option
Maison
Flash info
Contenu
WillGarcía
WillGarcía
21 août 2026

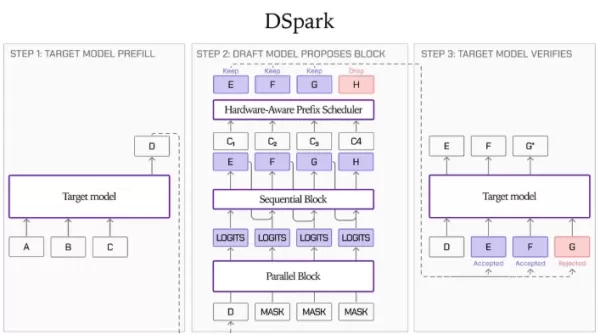
Liquid AI et Hugging Face ont publié des points de contrôle de modèle préliminaires DSpark pour les trois modèles de la série LFM2.5, ces derniers intégrant une voie de décodage spéculative qui permet d’augmenter le débit d’inférence jusqu’à 3,18 fois sur des GPU et 2,87 fois sur des appareils edge sans affecter la qualité du résultat. Cette technologie réduit de 57 % le temps de latence lié aux appels de fonction chez LFM2.5-2.6B dans les scénarios d’agents edge, atteignant ainsi 139 tokens par seconde sur un MacBook Pro M4Max, ce qui diminue les obstacles à son déploiement local et offre des performances supérieures à celles de certains modèles cloud propriétaires. En utilisant un modèle préliminaire léger pour générer des tokens candidats, qui sont ensuite validés de manière uniforme, cette technologie surmonte les contraintes liées à la bande passante mémoire dans les processus d’inférence traditionnels. Elle se compose d’un réseau principal parallèle, d’une tête séquentielle et d’un validateur de planification de confiance. Le modèle préliminaire initial repose sur une architecture à 5 couches et 9 blocs basée uniquement sur l’attention, comptant environ 300 millions de paramètres. La précision des résultats reste identique à celle obtenue avec la méthode de décodage greedy de base. DSpark est compatible avec SGLang et llama.cpp dès son lancement.
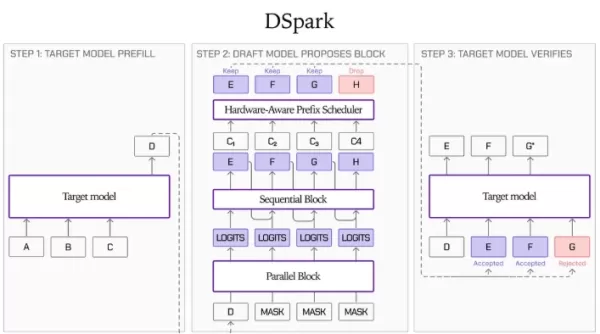
Liquid AI et Hugging Face ont publié des points de contrôle de modèle préliminaires DSpark pour les trois modèles de la série LFM2.5, ces derniers intégrant une voie de décodage spéculative qui permet d’augmenter le débit d’inférence jusqu’à 3,18 fois sur des GPU et 2,87 fois sur des appareils edge sans affecter la qualité du résultat. Cette technologie réduit de 57 % le temps de latence lié aux appels de fonction chez LFM2.5-2.6B dans les scénarios d’agents edge, atteignant ainsi 139 tokens par seconde sur un MacBook Pro M4Max, ce qui diminue les obstacles à son déploiement local et offre des performances supérieures à celles de certains modèles cloud propriétaires. En utilisant un modèle préliminaire léger pour générer des tokens candidats, qui sont ensuite validés de manière uniforme, cette technologie surmonte les contraintes liées à la bande passante mémoire dans les processus d’inférence traditionnels. Elle se compose d’un réseau principal parallèle, d’une tête séquentielle et d’un validateur de planification de confiance. Le modèle préliminaire initial repose sur une architecture à 5 couches et 9 blocs basée uniquement sur l’attention, comptant environ 300 millions de paramètres. La précision des résultats reste identique à celle obtenue avec la méthode de décodage greedy de base. DSpark est compatible avec SGLang et llama.cpp dès son lancement. Liquid AI et Hugging Face ont publié des points de contrôle de modèle préliminaires DSpark pour les trois modèles de la série LFM2.5, ces derniers intégrant une voie de décodage spéculative qui permet d’augmenter le débit d’inférence jusqu’à 3,18 fois sur des GPU et 2,87 fois sur des appareils edge sans affecter la qualité du résultat. Cette technologie réduit de 57 % le temps de latence lié aux appels de fonction chez LFM2.5-2.6B dans les scénarios d’agents edge, atteignant ainsi 139 tokens par seconde sur un MacBook Pro M4Max, ce qui diminue les obstacles à son déploiement local et offre des performances supérieures à celles de certains modèles cloud propriétaires. En utilisant un modèle préliminaire léger pour générer des tokens candidats, qui sont ensuite validés de manière uniforme, cette technologie surmonte les contraintes liées à la bande passante mémoire dans les processus d’inférence traditionnels. Elle se compose d’un réseau principal parallèle, d’une tête séquentielle et d’un validateur de planification de confiance. Le modèle préliminaire initial repose sur une architecture à 5 couches et 9 blocs basée uniquement sur l’attention, comptant environ 300 millions de paramètres. La précision des résultats reste identique à celle obtenue avec la méthode de décodage greedy de base. DSpark est compatible avec SGLang et llama.cpp dès son lancement.
commentaires (0)
0/300
OR