オプション
速報
コンテンツ
WillGarcía
WillGarcía
2026年8月21日

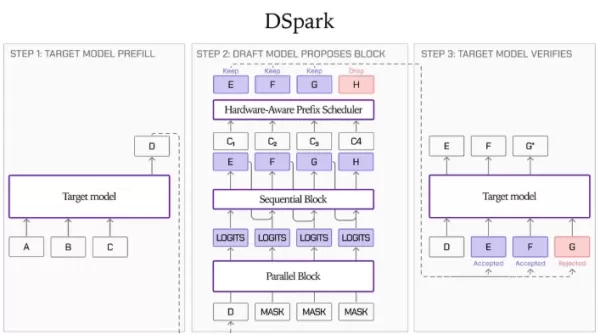
Liquid AIとHugging Faceは、LFM2.5シリーズの3つのモデル向けにDSparkドラフトモデルチェックポイントを公開しました。この技術は推測型デコーディングパスを採用することで、出力品質に影響を与えることなく、GPU上では推論処理速度を最大3.18倍、エッジデバイス上では2.87倍まで向上させます。また、エッジエージェント環境下におけるLFM2.5-2.6Bの関数呼び出し遅延を57%削減し、M4Max MacBook Pro上では1秒あたり139トークンの処理速度を実現しています。これによりローカル環境での導入障壁が低減され、一部のプロプライエタリなクラウドモデルよりも優れたパフォーマンスが得られます。この技術は、軽量なドラフトモデルを用いて候補となるトークンを生成し、それらを一括して検証することで、従来の推論処理におけるメモリ帯域幅の制約に対応しています。構成要素は並列型のバックボーンネットワーク、順次処理型のヘッド、そして信頼度スケジューリング検証器からなります。初期のドラフトモデルはアテンションのみを利用した5層9ブロック構造で、パラメータ数は約3億個です。出力精度はベースラインとなるグリーディーデコーディングと変わりません。DSparkはリリース時点ですでにSGLangおよびllama.cppと互換性があります。
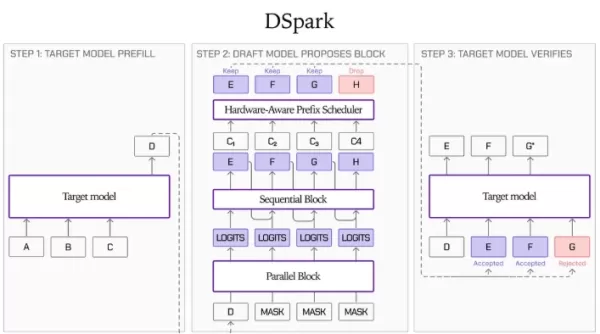
Liquid AIとHugging Faceは、LFM2.5シリーズの3つのモデル向けにDSparkドラフトモデルチェックポイントを公開しました。この技術は推測型デコーディングパスを採用することで、出力品質に影響を与えることなく、GPU上では推論処理速度を最大3.18倍、エッジデバイス上では2.87倍まで向上させます。また、エッジエージェント環境下におけるLFM2.5-2.6Bの関数呼び出し遅延を57%削減し、M4Max MacBook Pro上では1秒あたり139トークンの処理速度を実現しています。これによりローカル環境での導入障壁が低減され、一部のプロプライエタリなクラウドモデルよりも優れたパフォーマンスが得られます。この技術は、軽量なドラフトモデルを用いて候補となるトークンを生成し、それらを一括して検証することで、従来の推論処理におけるメモリ帯域幅の制約に対応しています。構成要素は並列型のバックボーンネットワーク、順次処理型のヘッド、そして信頼度スケジューリング検証器からなります。初期のドラフトモデルはアテンションのみを利用した5層9ブロック構造で、パラメータ数は約3億個です。出力精度はベースラインとなるグリーディーデコーディングと変わりません。DSparkはリリース時点ですでにSGLangおよびllama.cppと互換性があります。 Liquid AIとHugging Faceは、LFM2.5シリーズの3つのモデル向けにDSparkドラフトモデルチェックポイントを公開しました。この技術は推測型デコーディングパスを採用することで、出力品質に影響を与えることなく、GPU上では推論処理速度を最大3.18倍、エッジデバイス上では2.87倍まで向上させます。また、エッジエージェント環境下におけるLFM2.5-2.6Bの関数呼び出し遅延を57%削減し、M4Max MacBook Pro上では1秒あたり139トークンの処理速度を実現しています。これによりローカル環境での導入障壁が低減され、一部のプロプライエタリなクラウドモデルよりも優れたパフォーマンスが得られます。この技術は、軽量なドラフトモデルを用いて候補となるトークンを生成し、それらを一括して検証することで、従来の推論処理におけるメモリ帯域幅の制約に対応しています。構成要素は並列型のバックボーンネットワーク、順次処理型のヘッド、そして信頼度スケジューリング検証器からなります。初期のドラフトモデルはアテンションのみを利用した5層9ブロック構造で、パラメータ数は約3億個です。出力精度はベースラインとなるグリーディーデコーディングと変わりません。DSparkはリリース時点ですでにSGLangおよびllama.cppと互換性があります。
コメント (0)
0/300
OR