
opción
Hogar
Última hora
Contenido
WillGarcía
WillGarcía
21 de agosto de 2026

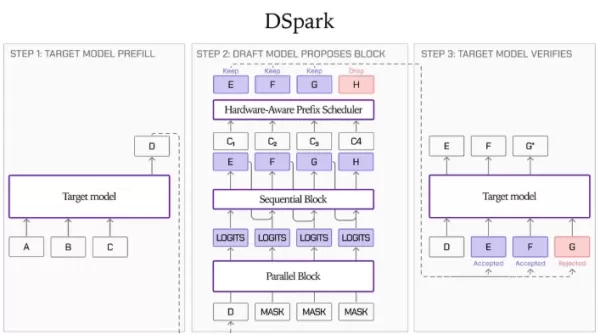
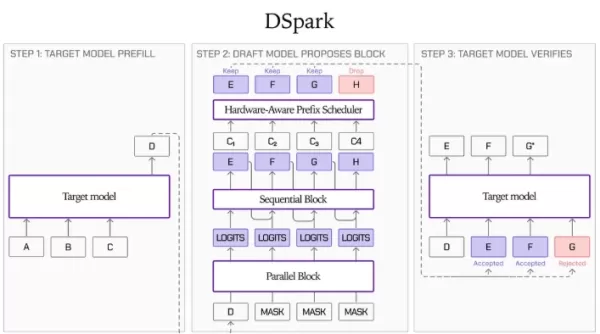
Liquid AI y Hugging Face han publicado los puntos de control del modelo preliminar DSpark para los tres modelos de la serie LFM2.5, los cuales cuentan con una ruta de decodificación especulativa que aumenta el rendimiento de inferencia hasta 3,18 veces en GPUs y 2,87 veces en dispositivos periféricos, sin afectar la calidad del resultado. Esta tecnología reduce en un 57% la latencia de las llamadas a funciones en el modelo LFM2.5-2.6B en escenarios de agentes periféricos, logrando un procesamiento de 139 tokens por segundo en un MacBook Pro M4Max, lo que disminuye las barreras para su implementación local y ofrece un rendimiento superior al de algunos modelos en la nube propietarios. Para superar las limitaciones de ancho de banda de memoria en los métodos tradicionales de inferencia, esta tecnología emplea un modelo preliminar ligero para generar tokens candidatos, los cuales son validados de forma uniforme. DSpark está compuesto por una red principal paralela, una capa de procesamiento secuencial y un validador de programación de confianza. El modelo preliminar inicial utiliza una arquitectura de 5 capas y 9 bloques basada únicamente en mecanismos de atención, con aproximadamente 300 millones de parámetros. La precisión del resultado sigue siendo idéntica a la obtenida con el método de decodificación tradicional. Desde su lanzamiento, DSpark es compatible con SGLang y llama.cpp.
Liquid AI y Hugging Face han publicado los puntos de control del modelo preliminar DSpark para los tres modelos de la serie LFM2.5, los cuales cuentan con una ruta de decodificación especulativa que aumenta el rendimiento de inferencia hasta 3,18 veces en GPUs y 2,87 veces en dispositivos periféricos, sin afectar la calidad del resultado. Esta tecnología reduce en un 57% la latencia de las llamadas a funciones en el modelo LFM2.5-2.6B en escenarios de agentes periféricos, logrando un procesamiento de 139 tokens por segundo en un MacBook Pro M4Max, lo que disminuye las barreras para su implementación local y ofrece un rendimiento superior al de algunos modelos en la nube propietarios. Para superar las limitaciones de ancho de banda de memoria en los métodos tradicionales de inferencia, esta tecnología emplea un modelo preliminar ligero para generar tokens candidatos, los cuales son validados de forma uniforme. DSpark está compuesto por una red principal paralela, una capa de procesamiento secuencial y un validador de programación de confianza. El modelo preliminar inicial utiliza una arquitectura de 5 capas y 9 bloques basada únicamente en mecanismos de atención, con aproximadamente 300 millones de parámetros. La precisión del resultado sigue siendo idéntica a la obtenida con el método de decodificación tradicional. Desde su lanzamiento, DSpark es compatible con SGLang y llama.cpp. Liquid AI y Hugging Face han publicado los puntos de control del modelo preliminar DSpark para los tres modelos de la serie LFM2.5, los cuales cuentan con una ruta de decodificación especulativa que aumenta el rendimiento de inferencia hasta 3,18 veces en GPUs y 2,87 veces en dispositivos periféricos, sin afectar la calidad del resultado. Esta tecnología reduce en un 57% la latencia de las llamadas a funciones en el modelo LFM2.5-2.6B en escenarios de agentes periféricos, logrando un procesamiento de 139 tokens por segundo en un MacBook Pro M4Max, lo que disminuye las barreras para su implementación local y ofrece un rendimiento superior al de algunos modelos en la nube propietarios. Para superar las limitaciones de ancho de banda de memoria en los métodos tradicionales de inferencia, esta tecnología emplea un modelo preliminar ligero para generar tokens candidatos, los cuales son validados de forma uniforme. DSpark está compuesto por una red principal paralela, una capa de procesamiento secuencial y un validador de programación de confianza. El modelo preliminar inicial utiliza una arquitectura de 5 capas y 9 bloques basada únicamente en mecanismos de atención, con aproximadamente 300 millones de parámetros. La precisión del resultado sigue siendo idéntica a la obtenida con el método de decodificación tradicional. Desde su lanzamiento, DSpark es compatible con SGLang y llama.cpp.
comentario (0)
0/300
OR