選項
首頁
快訊
內容
WillGarcía
WillGarcía
2026-08-21

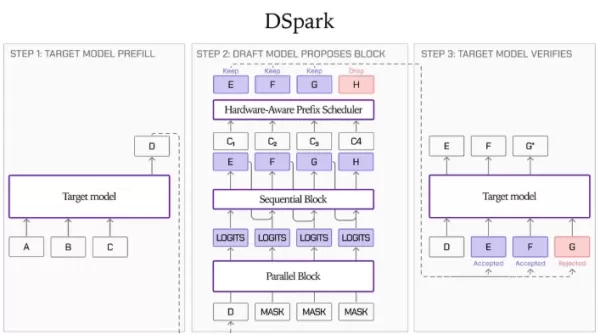
Liquid AI與Hugging Face已為三款LFM2.5系列模型釋出了DSpark草案模型檢查點,該模型採用了推測性解碼路徑,在不影響輸出質量的前提下,可使GPU上的推理吞吐量提升至原來的3.18倍,而在邊緣裝置上則可提升2.87倍。在邊緣代理場景中,它還將LFM2.5-2.6B的函式呼叫延遲降低了57%,在M4Max版MacBook Pro上的處理速度可達每秒139個標記,從而降低了本地部署的門檻,並且其效能優於某些專有的雲模型。該技術透過使用輕量級的草案模型來生成候選標記,再對這些標記進行統一驗證,以此解決傳統推理方式中存在的記憶體頻寬限制問題。該模型由並行主幹網路、順序式頭部結構以及置信度排程驗證器組成。初始的草案模型採用僅基於注意力機制的5層9塊架構,引數量約為3億個。其輸出精度與基線的貪婪解碼方法相比沒有變化。DSpark在釋出時即相容SGLang和llama.cpp。
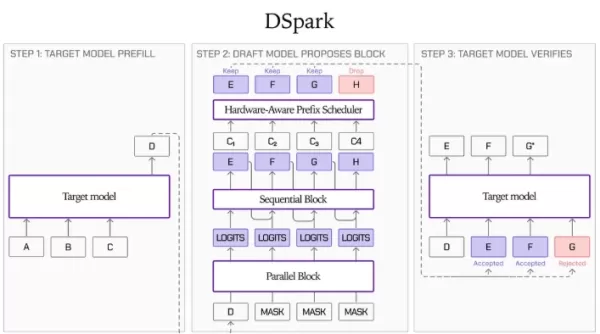
Liquid AI與Hugging Face已為三款LFM2.5系列模型釋出了DSpark草案模型檢查點,該模型採用了推測性解碼路徑,在不影響輸出質量的前提下,可使GPU上的推理吞吐量提升至原來的3.18倍,而在邊緣裝置上則可提升2.87倍。在邊緣代理場景中,它還將LFM2.5-2.6B的函式呼叫延遲降低了57%,在M4Max版MacBook Pro上的處理速度可達每秒139個標記,從而降低了本地部署的門檻,並且其效能優於某些專有的雲模型。該技術透過使用輕量級的草案模型來生成候選標記,再對這些標記進行統一驗證,以此解決傳統推理方式中存在的記憶體頻寬限制問題。該模型由並行主幹網路、順序式頭部結構以及置信度排程驗證器組成。初始的草案模型採用僅基於注意力機制的5層9塊架構,引數量約為3億個。其輸出精度與基線的貪婪解碼方法相比沒有變化。DSpark在釋出時即相容SGLang和llama.cpp。 Liquid AI與Hugging Face已為三款LFM2.5系列模型釋出了DSpark草案模型檢查點,該模型採用了推測性解碼路徑,在不影響輸出質量的前提下,可使GPU上的推理吞吐量提升至原來的3.18倍,而在邊緣裝置上則可提升2.87倍。在邊緣代理場景中,它還將LFM2.5-2.6B的函式呼叫延遲降低了57%,在M4Max版MacBook Pro上的處理速度可達每秒139個標記,從而降低了本地部署的門檻,並且其效能優於某些專有的雲模型。該技術透過使用輕量級的草案模型來生成候選標記,再對這些標記進行統一驗證,以此解決傳統推理方式中存在的記憶體頻寬限制問題。該模型由並行主幹網路、順序式頭部結構以及置信度排程驗證器組成。初始的草案模型採用僅基於注意力機制的5層9塊架構,引數量約為3億個。其輸出精度與基線的貪婪解碼方法相比沒有變化。DSpark在釋出時即相容SGLang和llama.cpp。
評論 (0)
0/300
OR