opção
WillGarcía
WillGarcía
21 de Agosto de 2026

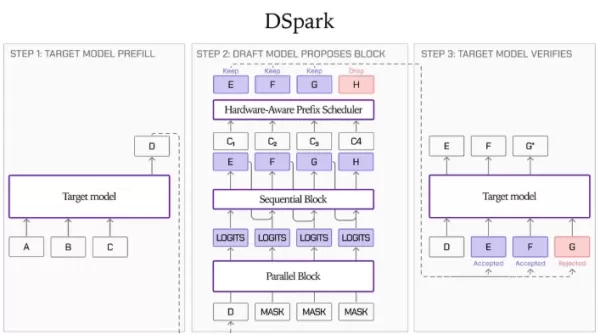
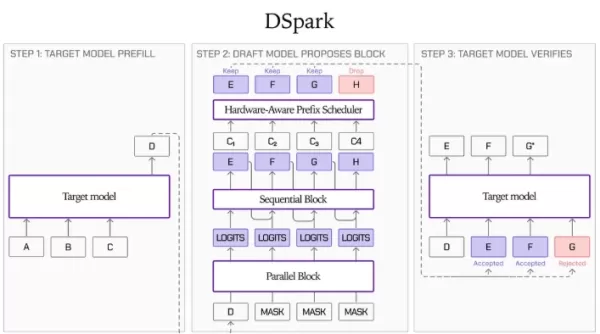
A Liquid AI e a Hugging Face lançaram os pontos de verificação do modelo em versão preliminar DSpark para os três modelos da série LFM2.5, que contam com um caminho de decodificação especulativa capaz de aumentar a taxa de processamento em até 3,18 vezes em GPUs e 2,87 vezes em dispositivos edge, sem afetar a qualidade da saída. Esse método reduz o atraso nas chamadas de função do LFM2.5-2.6B em 57% em cenários de agentes edge, alcançando 139 tokens por segundo no M4Max MacBook Pro, o que diminui as barreiras para implantação local e oferece desempenho superior a alguns modelos em nuvem proprietários. A tecnologia supera as limitações de largura de banda da memória nos processamentos tradicionais ao utilizar um modelo preliminar leve para gerar tokens candidatos, que são validados de forma uniforme. Ele é composto por uma rede principal paralela, uma camada de cabeçalho sequencial e um validador de agendamento de confiança. O modelo preliminar inicial adota uma arquitetura de 5 camadas e 9 blocos baseada apenas em atenção, com cerca de 300 milhões de parâmetros. A precisão da saída permanece idêntica à do método de decodificação greedy padrão. O DSpark é compatível com SGLang e llama.cpp desde o lançamento.
A Liquid AI e a Hugging Face lançaram os pontos de verificação do modelo em versão preliminar DSpark para os três modelos da série LFM2.5, que contam com um caminho de decodificação especulativa capaz de aumentar a taxa de processamento em até 3,18 vezes em GPUs e 2,87 vezes em dispositivos edge, sem afetar a qualidade da saída. Esse método reduz o atraso nas chamadas de função do LFM2.5-2.6B em 57% em cenários de agentes edge, alcançando 139 tokens por segundo no M4Max MacBook Pro, o que diminui as barreiras para implantação local e oferece desempenho superior a alguns modelos em nuvem proprietários. A tecnologia supera as limitações de largura de banda da memória nos processamentos tradicionais ao utilizar um modelo preliminar leve para gerar tokens candidatos, que são validados de forma uniforme. Ele é composto por uma rede principal paralela, uma camada de cabeçalho sequencial e um validador de agendamento de confiança. O modelo preliminar inicial adota uma arquitetura de 5 camadas e 9 blocos baseada apenas em atenção, com cerca de 300 milhões de parâmetros. A precisão da saída permanece idêntica à do método de decodificação greedy padrão. O DSpark é compatível com SGLang e llama.cpp desde o lançamento. A Liquid AI e a Hugging Face lançaram os pontos de verificação do modelo em versão preliminar DSpark para os três modelos da série LFM2.5, que contam com um caminho de decodificação especulativa capaz de aumentar a taxa de processamento em até 3,18 vezes em GPUs e 2,87 vezes em dispositivos edge, sem afetar a qualidade da saída. Esse método reduz o atraso nas chamadas de função do LFM2.5-2.6B em 57% em cenários de agentes edge, alcançando 139 tokens por segundo no M4Max MacBook Pro, o que diminui as barreiras para implantação local e oferece desempenho superior a alguns modelos em nuvem proprietários. A tecnologia supera as limitações de largura de banda da memória nos processamentos tradicionais ao utilizar um modelo preliminar leve para gerar tokens candidatos, que são validados de forma uniforme. Ele é composto por uma rede principal paralela, uma camada de cabeçalho sequencial e um validador de agendamento de confiança. O modelo preliminar inicial adota uma arquitetura de 5 camadas e 9 blocos baseada apenas em atenção, com cerca de 300 milhões de parâmetros. A precisão da saída permanece idêntica à do método de decodificação greedy padrão. O DSpark é compatível com SGLang e llama.cpp desde o lançamento.
Comentários (0)
0/300
OR