


Découvrez des outils AI de qualité
Rassemblez les principaux outils d'intelligence artificielle du monde pour aider à améliorer l'efficacité du travail

Articles publiés par WillGarcía
Elon Musk prévoit que l'IA doublera la croissance du PIB des États-Unis à 4 % l'année prochaine, contrairement aux prévisions conservatrices qui citent des taux d'intérêt élevés et des retards de productivité. Bien que les dépenses en capital liées à l'IA puissent atteindre 3 % du PIB d'ici 2029, les experts notent des retards historiques dans la traduction des investissements en gains économiques. Les hausses de taux de la Fed ajoutent une incertitude, pouvant entraver les petites entreprises malgré des dépenses continues et importantes dans les infrastructures technologiques.
Elon Musk prévoit que l'IA doublera la croissance du PIB des États-Unis à 4 % l'année prochaine, contrairement aux prévisions conservatrices qui citent des taux d'intérêt élevés et des retards de productivité. Bien que les dépenses en capital liées à l'IA puissent atteindre 3 % du PIB d'ici 2029, les experts notent des retards historiques dans la traduction des investissements en gains économiques. Les hausses de taux de la Fed ajoutent une incertitude, pouvant entraver les petites entreprises malgré des dépenses continues et importantes dans les infrastructures technologiques.

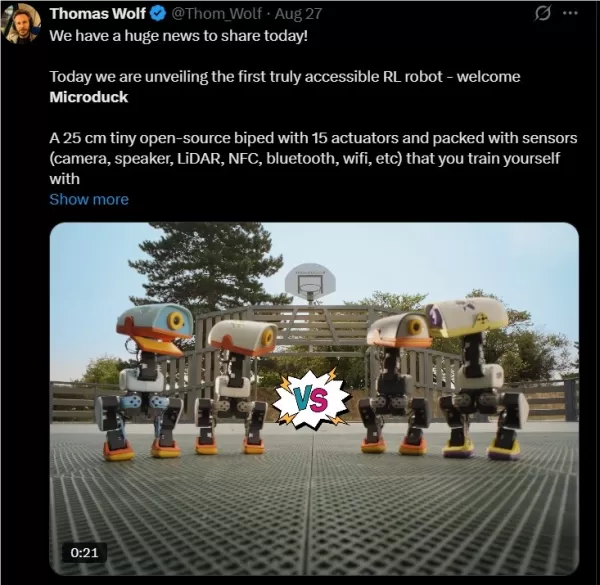
Hugging Face a open-sourcé Microduck, un mini robot bipède de 25 cm et 800 g. Alimenté par un Rockchip RK3566, il actionne 15 servomoteurs à 50 Hz et réalise des actions telles que la marche, le roulement et la manipulation d’objets grâce à l’apprentissage par renforcement. Le projet intègre un transfert Sim2Real utilisant PPO et une randomisation de domaine, avec un modèle ONNX déployé sur du matériel réel. Conçu en Rust, son architecture orientée services garantit la sécurité et des mises à jour OTA transparentes avec rollback automatique. Cette plateforme propose un pipeline complet, de la simulation au déploiement, pour la recherche en intelligence incarnée.
Hugging Face a open-sourcé Microduck, un mini robot bipède de 25 cm et 800 g. Alimenté par un Rockchip RK3566, il actionne 15 servomoteurs à 50 Hz et réalise des actions telles que la marche, le roulement et la manipulation d’objets grâce à l’apprentissage par renforcement. Le projet intègre un transfert Sim2Real utilisant PPO et une randomisation de domaine, avec un modèle ONNX déployé sur du matériel réel. Conçu en Rust, son architecture orientée services garantit la sécurité et des mises à jour OTA transparentes avec rollback automatique. Cette plateforme propose un pipeline complet, de la simulation au déploiement, pour la recherche en intelligence incarnée.
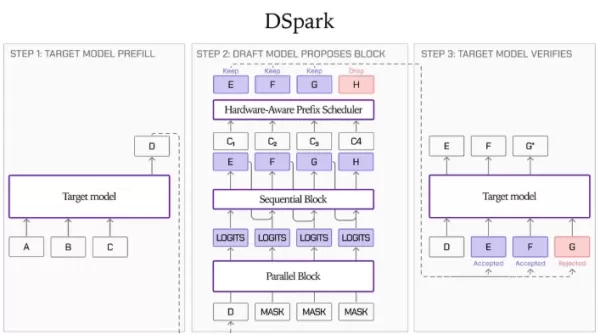
Liquid AI et Hugging Face ont publié des points de contrôle de modèle préliminaires DSpark pour les trois modèles de la série LFM2.5, ces derniers intégrant une voie de décodage spéculative qui permet d’augmenter le débit d’inférence jusqu’à 3,18 fois sur des GPU et 2,87 fois sur des appareils edge sans affecter la qualité du résultat. Cette technologie réduit de 57 % le temps de latence lié aux appels de fonction chez LFM2.5-2.6B dans les scénarios d’agents edge, atteignant ainsi 139 tokens par seconde sur un MacBook Pro M4Max, ce qui diminue les obstacles à son déploiement local et offre des performances supérieures à celles de certains modèles cloud propriétaires. En utilisant un modèle préliminaire léger pour générer des tokens candidats, qui sont ensuite validés de manière uniforme, cette technologie surmonte les contraintes liées à la bande passante mémoire dans les processus d’inférence traditionnels. Elle se compose d’un réseau principal parallèle, d’une tête séquentielle et d’un validateur de planification de confiance. Le modèle préliminaire initial repose sur une architecture à 5 couches et 9 blocs basée uniquement sur l’attention, comptant environ 300 millions de paramètres. La précision des résultats reste identique à celle obtenue avec la méthode de décodage greedy de base. DSpark est compatible avec SGLang et llama.cpp dès son lancement.
Liquid AI et Hugging Face ont publié des points de contrôle de modèle préliminaires DSpark pour les trois modèles de la série LFM2.5, ces derniers intégrant une voie de décodage spéculative qui permet d’augmenter le débit d’inférence jusqu’à 3,18 fois sur des GPU et 2,87 fois sur des appareils edge sans affecter la qualité du résultat. Cette technologie réduit de 57 % le temps de latence lié aux appels de fonction chez LFM2.5-2.6B dans les scénarios d’agents edge, atteignant ainsi 139 tokens par seconde sur un MacBook Pro M4Max, ce qui diminue les obstacles à son déploiement local et offre des performances supérieures à celles de certains modèles cloud propriétaires. En utilisant un modèle préliminaire léger pour générer des tokens candidats, qui sont ensuite validés de manière uniforme, cette technologie surmonte les contraintes liées à la bande passante mémoire dans les processus d’inférence traditionnels. Elle se compose d’un réseau principal parallèle, d’une tête séquentielle et d’un validateur de planification de confiance. Le modèle préliminaire initial repose sur une architecture à 5 couches et 9 blocs basée uniquement sur l’attention, comptant environ 300 millions de paramètres. La précision des résultats reste identique à celle obtenue avec la méthode de décodage greedy de base. DSpark est compatible avec SGLang et llama.cpp dès son lancement.
Anthropic prévoit de lever 10 milliards de dollars à une valorisation de 350 milliards de dollars, sous la houlette de Coatue et GIC, doublant ainsi sa valeur depuis son dernier tour de table il y a trois mois.
Anthropic prévoit de lever 10 milliards de dollars à une valorisation de 350 milliards de dollars, sous la houlette de Coatue et GIC, doublant ainsi sa valeur depuis son dernier tour de table il y a trois mois.
L'ancien directeur de Databricks AI, Naveen Raos, a levé 475 millions d'euros de fonds d'amorçage à une valeur de 45 milliards d'euros, sous la direction d'Andreessen Horowitz et de Lightspeed Ventures. L'objectif est d'atteindre 1 milliard d'euros. La société vise à construire un nouvel ordinateur économe en énergie pour l'intelligence artificielle.
L'ancien directeur de Databricks AI, Naveen Raos, a levé 475 millions d'euros de fonds d'amorçage à une valeur de 45 milliards d'euros, sous la direction d'Andreessen Horowitz et de Lightspeed Ventures. L'objectif est d'atteindre 1 milliard d'euros. La société vise à construire un nouvel ordinateur économe en énergie pour l'intelligence artificielle.
Les startups de codage IA comme Windsurf font face à des coûts élevés et des marges négatives en raison des LLM coûteux et de la concurrence, ce qui conduit à des ventes stratégiques ou à des efforts de construction de modèles, comme on l'a vu avec Anysphere.
Les startups de codage IA comme Windsurf font face à des coûts élevés et des marges négatives en raison des LLM coûteux et de la concurrence, ce qui conduit à des ventes stratégiques ou à des efforts de construction de modèles, comme on l'a vu avec Anysphere.


