옵션
속보
콘텐츠
WillGarcía
WillGarcía
2026년 8월 21일

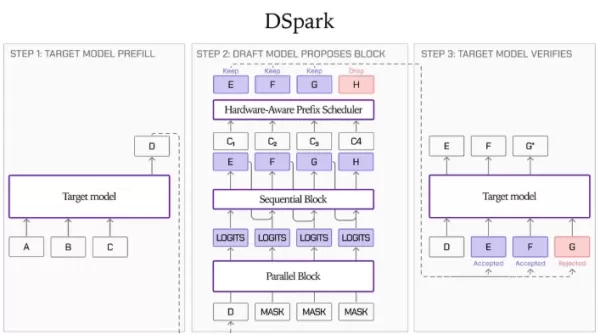
Liquid AI와 Hugging Face는 세 가지 LFM2.5 시리즈 모델을 위한 DSpark 예비 모델 체크포인트를 공개했습니다. 이 모델은 추측 기반 디코딩 경로를 채택하여 출력 품질에 영향을 주지 않으면서도 GPU 환경에서는 추론 처리 속도를 최대 3.18배, 엣지 장치에서는 2.87배까지 향상시킵니다. 또한 엣지 에이전트 환경에서 LFM2.5-2.6B의 함수 호출 지연 시간을 57% 줄여 M4Max MacBook Pro에서 초당 139개의 토큰을 처리할 수 있게 하며, 로컬 배포의 장벽을 낮추고 일부 독점적인 클라우드 모델들보다 더 우수한 성능을 제공합니다. 이 기술은 가벼운 예비 모델을 활용해 후보 토큰들을 생성하고 이를 일괄적으로 검증함으로써 기존 추론 방식의 메모리 대역폭 제약 문제를 해결합니다. DSpark는 병렬형 백본 네트워크, 순차형 헤드, 그리고 신뢰도 스케줄링 검증기로 구성되어 있습니다. 초기 예비 모델은 약 3억 개의 파라미터를 가진 5레이어 9블록 구조의 어텐션 전용 아키텍처를 사용합니다. 출력 정확도는 기존의 그리디 디코딩 방식과 동일한 수준을 유지합니다. DSpark는 출시 시점부터 SGLang 및 llama.cpp와 호환됩니다.
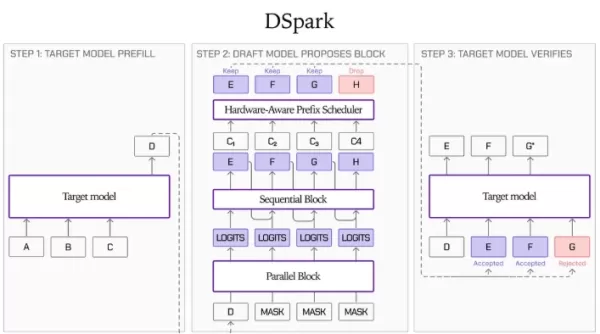
Liquid AI와 Hugging Face는 세 가지 LFM2.5 시리즈 모델을 위한 DSpark 예비 모델 체크포인트를 공개했습니다. 이 모델은 추측 기반 디코딩 경로를 채택하여 출력 품질에 영향을 주지 않으면서도 GPU 환경에서는 추론 처리 속도를 최대 3.18배, 엣지 장치에서는 2.87배까지 향상시킵니다. 또한 엣지 에이전트 환경에서 LFM2.5-2.6B의 함수 호출 지연 시간을 57% 줄여 M4Max MacBook Pro에서 초당 139개의 토큰을 처리할 수 있게 하며, 로컬 배포의 장벽을 낮추고 일부 독점적인 클라우드 모델들보다 더 우수한 성능을 제공합니다. 이 기술은 가벼운 예비 모델을 활용해 후보 토큰들을 생성하고 이를 일괄적으로 검증함으로써 기존 추론 방식의 메모리 대역폭 제약 문제를 해결합니다. DSpark는 병렬형 백본 네트워크, 순차형 헤드, 그리고 신뢰도 스케줄링 검증기로 구성되어 있습니다. 초기 예비 모델은 약 3억 개의 파라미터를 가진 5레이어 9블록 구조의 어텐션 전용 아키텍처를 사용합니다. 출력 정확도는 기존의 그리디 디코딩 방식과 동일한 수준을 유지합니다. DSpark는 출시 시점부터 SGLang 및 llama.cpp와 호환됩니다. Liquid AI와 Hugging Face는 세 가지 LFM2.5 시리즈 모델을 위한 DSpark 예비 모델 체크포인트를 공개했습니다. 이 모델은 추측 기반 디코딩 경로를 채택하여 출력 품질에 영향을 주지 않으면서도 GPU 환경에서는 추론 처리 속도를 최대 3.18배, 엣지 장치에서는 2.87배까지 향상시킵니다. 또한 엣지 에이전트 환경에서 LFM2.5-2.6B의 함수 호출 지연 시간을 57% 줄여 M4Max MacBook Pro에서 초당 139개의 토큰을 처리할 수 있게 하며, 로컬 배포의 장벽을 낮추고 일부 독점적인 클라우드 모델들보다 더 우수한 성능을 제공합니다. 이 기술은 가벼운 예비 모델을 활용해 후보 토큰들을 생성하고 이를 일괄적으로 검증함으로써 기존 추론 방식의 메모리 대역폭 제약 문제를 해결합니다. DSpark는 병렬형 백본 네트워크, 순차형 헤드, 그리고 신뢰도 스케줄링 검증기로 구성되어 있습니다. 초기 예비 모델은 약 3억 개의 파라미터를 가진 5레이어 9블록 구조의 어텐션 전용 아키텍처를 사용합니다. 출력 정확도는 기존의 그리디 디코딩 방식과 동일한 수준을 유지합니다. DSpark는 출시 시점부터 SGLang 및 llama.cpp와 호환됩니다.
의견 (0)
0/300
OR