Option
Heim
Eilmeldung
Inhalt
WillGarcía
WillGarcía
21. August 2026

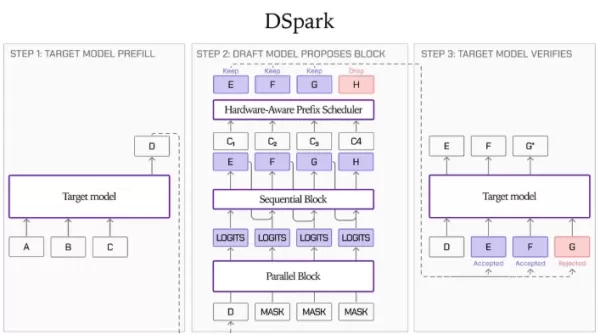
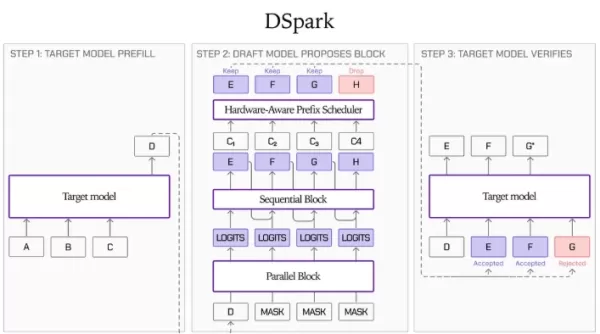
Liquid AI und Hugging Face haben Draft-Modell-Checkpoints für die drei Modelle der LFM2.5-Serie unter Verwendung von DSpark veröffentlicht. Diese Features einen spekulativen Dekodierpfad, der die Inferenzgeschwindigkeit auf GPUs um bis zu 3,18 Mal und auf Edge-Geräten um 2,87 Mal erhöht, ohne die Ausgabequalität zu beeinträchtigen. In Szenarien mit Edge-Agenten verringert er die Latenz bei den Funktionsaufrufen von LFM2.5-2.6B um 57 Prozent – auf einem M4Max MacBook Pro sind dadurch bis zu 139 Tokens pro Sekunde möglich. Dadurch werden die Hürden für eine lokale Implementierung gesenkt und es wird eine bessere Leistung erzielt als bei einigen proprietären Cloud-Modellen. Die Technologie bewältigt die Einschränkungen hinsichtlich der Speicherkapazitäten bei herkömmlichen Inferenzverfahren, indem sie ein leichtgewichtiges Draft-Modell verwendet, um Kandidaten-Token zu erzeugen, die anschließend einheitlich überprüft werden. Es setzt sich aus einem parallelen Backbone-Netzwerk, einem sequentiellen Head sowie einem Validierer zur Bestimmung des Vertrauensniveaus zusammen. Das ursprüngliche Draft-Modell basiert auf einer ausschließlich auf Attention beruhenden Architektur mit 5 Schichten und 9 Blöcken sowie rund 300 Millionen Parametern. Die Ausgabegenauigkeit bleibt im Vergleich zur Baseline-Methode des gierigen Dekodierens unverändert. Bei der Einführung ist DSpark mit SGLang und llama.cpp kompatibel.
Liquid AI und Hugging Face haben Draft-Modell-Checkpoints für die drei Modelle der LFM2.5-Serie unter Verwendung von DSpark veröffentlicht. Diese Features einen spekulativen Dekodierpfad, der die Inferenzgeschwindigkeit auf GPUs um bis zu 3,18 Mal und auf Edge-Geräten um 2,87 Mal erhöht, ohne die Ausgabequalität zu beeinträchtigen. In Szenarien mit Edge-Agenten verringert er die Latenz bei den Funktionsaufrufen von LFM2.5-2.6B um 57 Prozent – auf einem M4Max MacBook Pro sind dadurch bis zu 139 Tokens pro Sekunde möglich. Dadurch werden die Hürden für eine lokale Implementierung gesenkt und es wird eine bessere Leistung erzielt als bei einigen proprietären Cloud-Modellen. Die Technologie bewältigt die Einschränkungen hinsichtlich der Speicherkapazitäten bei herkömmlichen Inferenzverfahren, indem sie ein leichtgewichtiges Draft-Modell verwendet, um Kandidaten-Token zu erzeugen, die anschließend einheitlich überprüft werden. Es setzt sich aus einem parallelen Backbone-Netzwerk, einem sequentiellen Head sowie einem Validierer zur Bestimmung des Vertrauensniveaus zusammen. Das ursprüngliche Draft-Modell basiert auf einer ausschließlich auf Attention beruhenden Architektur mit 5 Schichten und 9 Blöcken sowie rund 300 Millionen Parametern. Die Ausgabegenauigkeit bleibt im Vergleich zur Baseline-Methode des gierigen Dekodierens unverändert. Bei der Einführung ist DSpark mit SGLang und llama.cpp kompatibel. Liquid AI und Hugging Face haben Draft-Modell-Checkpoints für die drei Modelle der LFM2.5-Serie unter Verwendung von DSpark veröffentlicht. Diese Features einen spekulativen Dekodierpfad, der die Inferenzgeschwindigkeit auf GPUs um bis zu 3,18 Mal und auf Edge-Geräten um 2,87 Mal erhöht, ohne die Ausgabequalität zu beeinträchtigen. In Szenarien mit Edge-Agenten verringert er die Latenz bei den Funktionsaufrufen von LFM2.5-2.6B um 57 Prozent – auf einem M4Max MacBook Pro sind dadurch bis zu 139 Tokens pro Sekunde möglich. Dadurch werden die Hürden für eine lokale Implementierung gesenkt und es wird eine bessere Leistung erzielt als bei einigen proprietären Cloud-Modellen. Die Technologie bewältigt die Einschränkungen hinsichtlich der Speicherkapazitäten bei herkömmlichen Inferenzverfahren, indem sie ein leichtgewichtiges Draft-Modell verwendet, um Kandidaten-Token zu erzeugen, die anschließend einheitlich überprüft werden. Es setzt sich aus einem parallelen Backbone-Netzwerk, einem sequentiellen Head sowie einem Validierer zur Bestimmung des Vertrauensniveaus zusammen. Das ursprüngliche Draft-Modell basiert auf einer ausschließlich auf Attention beruhenden Architektur mit 5 Schichten und 9 Blöcken sowie rund 300 Millionen Parametern. Die Ausgabegenauigkeit bleibt im Vergleich zur Baseline-Methode des gierigen Dekodierens unverändert. Bei der Einführung ist DSpark mit SGLang und llama.cpp kompatibel.
Kommentare (0)
0/300
OR