вариант
Дом
Срочные новости
Содержание
WillGarcía
WillGarcía
21 августа 2026 г.

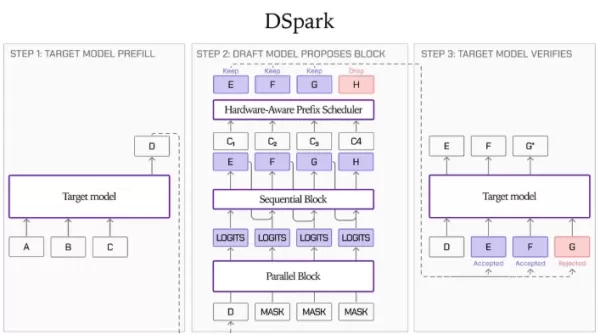
Компании Liquid AI и Hugging Face выпустили прототипные чекпоинты модели DSpark для трех моделей серии LFM2.5, оснащенные алгоритмом спекулятивной декодировки, который позволяет увеличить скорость обработки запросов до 3,18 раз на GPU и в 2,87 раза на периферийных устройствах без снижения качества результата. В сценариях использования edge-агентов этот алгоритм сокращает время выполнения функциональных вызовов модели LFM2.5-2.6B на 57%, достигая скорости обработки 139 токенов в секунду на устройстве MacBook Pro с процессором M4Max, тем самым снижая барьеры для локальной развертки и обеспечивая лучшую производительность по сравнению с некоторыми проприетарными облачными моделями. Данная технология преодолевает ограничения по пропускной способности памяти в традиционных схемах инференса за счет использования легковесного прототипа модели для генерации кандидатских токенов, которые затем проверяются единообразным образом. Структура системы включает параллельную основную сеть, последовательный блок обработки и механизм верификации уровня уверенности. Исходный прототип модели построен на архитектуре из 5 слоев и 9 блоков с использованием только механизма внимания и содержит около 300 миллионов параметров. Точность вывода остается неизменной по сравнению с базовым методом жадной декодировки. При запуске DSpark совместим с инструментами SGLang и llama.cpp.
Компании Liquid AI и Hugging Face выпустили прототипные чекпоинты модели DSpark для трех моделей серии LFM2.5, оснащенные алгоритмом спекулятивной декодировки, который позволяет увеличить скорость обработки запросов до 3,18 раз на GPU и в 2,87 раза на периферийных устройствах без снижения качества результата. В сценариях использования edge-агентов этот алгоритм сокращает время выполнения функциональных вызовов модели LFM2.5-2.6B на 57%, достигая скорости обработки 139 токенов в секунду на устройстве MacBook Pro с процессором M4Max, тем самым снижая барьеры для локальной развертки и обеспечивая лучшую производительность по сравнению с некоторыми проприетарными облачными моделями. Данная технология преодолевает ограничения по пропускной способности памяти в традиционных схемах инференса за счет использования легковесного прототипа модели для генерации кандидатских токенов, которые затем проверяются единообразным образом. Структура системы включает параллельную основную сеть, последовательный блок обработки и механизм верификации уровня уверенности. Исходный прототип модели построен на архитектуре из 5 слоев и 9 блоков с использованием только механизма внимания и содержит около 300 миллионов параметров. Точность вывода остается неизменной по сравнению с базовым методом жадной декодировки. При запуске DSpark совместим с инструментами SGLang и llama.cpp. Компании Liquid AI и Hugging Face выпустили прототипные чекпоинты модели DSpark для трех моделей серии LFM2.5, оснащенные алгоритмом спекулятивной декодировки, который позволяет увеличить скорость обработки запросов до 3,18 раз на GPU и в 2,87 раза на периферийных устройствах без снижения качества результата. В сценариях использования edge-агентов этот алгоритм сокращает время выполнения функциональных вызовов модели LFM2.5-2.6B на 57%, достигая скорости обработки 139 токенов в секунду на устройстве MacBook Pro с процессором M4Max, тем самым снижая барьеры для локальной развертки и обеспечивая лучшую производительность по сравнению с некоторыми проприетарными облачными моделями. Данная технология преодолевает ограничения по пропускной способности памяти в традиционных схемах инференса за счет использования легковесного прототипа модели для генерации кандидатских токенов, которые затем проверяются единообразным образом. Структура системы включает параллельную основную сеть, последовательный блок обработки и механизм верификации уровня уверенности. Исходный прототип модели построен на архитектуре из 5 слоев и 9 блоков с использованием только механизма внимания и содержит около 300 миллионов параметров. Точность вывода остается неизменной по сравнению с базовым методом жадной декодировки. При запуске DSpark совместим с инструментами SGLang и llama.cpp.
Автор GeorgeMiller GeorgeMiller 20 сентября 2026 г.
Step Zenith представила Step5Preview — флагманскую модель искусственного интеллекта нового поколения, оптимизированную для программирования, программной инженерии и финансов. Модель использует разреженную архитектуру MoE с 600 миллиардами параметров, из которых 27 миллиардов являются активными, поддерживает контекстное окно на 1 миллион токенов и нативный мультимодальный ввод. Модель входит в мировую тройку лидеров по уровню интеллекта среди открытых моделей, демонстрируя производительность, сопоставимую с Claude Opus5, при стоимости в восемь раз меньшей. Она обеспечивает баланс между интеллектом, стоимостью и эффективностью для решения реальных задач агентов. Официальный открытый релиз Step5Preview запланирован на 15 октября; модель ориентирована на сложные профессиональные рабочие процессы и направлена на повышение общей операционной эффективности.
/ru/live/7463
OR