首页

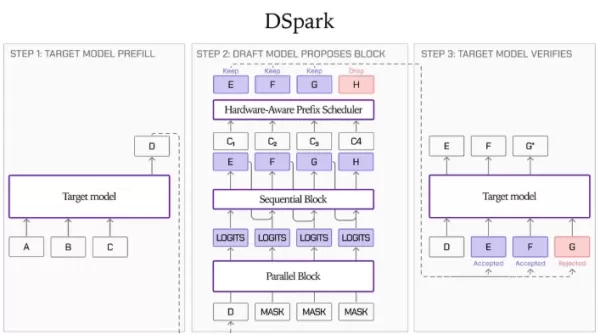
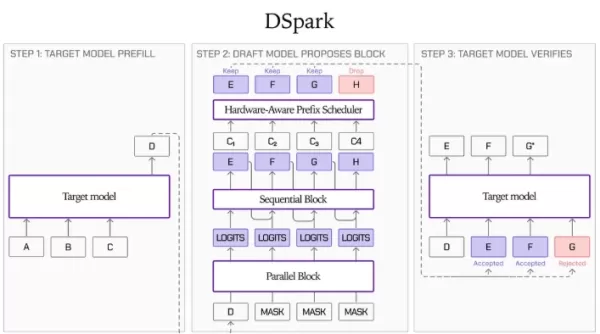
Liquid AI与Hugging Face已为三款LFM2.5系列模型发布了DSpark草案模型检查点,该模型采用了推测性解码路径,在不影响输出质量的前提下,可使GPU上的推理吞吐量提升至原来的3.18倍,而在边缘设备上则可提升2.87倍。在边缘代理场景中,它还将LFM2.5-2.6B的函数调用延迟降低了57%,在M4Max版MacBook Pro上的处理速度可达每秒139个标记,从而降低了本地部署的门槛,并且其性能优于某些专有的云模型。该技术通过使用轻量级的草案模型来生成候选标记,再对这些标记进行统一验证,以此解决传统推理方式中存在的内存带宽限制问题。该模型由并行主干网络、顺序式头部结构以及置信度调度验证器组成。初始的草案模型采用仅基于注意力机制的5层9块架构,参数量约为3亿个。其输出精度与基线的贪婪解码方法相比没有变化。DSpark在发布时即兼容SGLang和llama.cpp。
评论 (0)
0/300