


Descubre herramientas de IA de calidad
Reúna las principales herramientas de inteligencia artificial del mundo para ayudar a mejorar la eficiencia laboral

Artículos publicados por WillGarcía
Elon Musk predice que la IA duplicará el crecimiento del PIB de Estados Unidos al 4% el próximo año, en contraste con las previsiones conservadoras que citan altas tasas de interés y rezagos en la productividad. Aunque el gasto en capital de IA podría alcanzar el 3% del PIB para 2029, los expertos señalan retrasos históricos en la traducción de la inversión en ganancias económicas. Los aumentos de las tasas de la Reserva Federal añaden incertidumbre, lo que podría obstaculizar a las pequeñas empresas a pesar de la continua inversión sustancial en infraestructura tecnológica.
Elon Musk predice que la IA duplicará el crecimiento del PIB de Estados Unidos al 4% el próximo año, en contraste con las previsiones conservadoras que citan altas tasas de interés y rezagos en la productividad. Aunque el gasto en capital de IA podría alcanzar el 3% del PIB para 2029, los expertos señalan retrasos históricos en la traducción de la inversión en ganancias económicas. Los aumentos de las tasas de la Reserva Federal añaden incertidumbre, lo que podría obstaculizar a las pequeñas empresas a pesar de la continua inversión sustancial en infraestructura tecnológica.

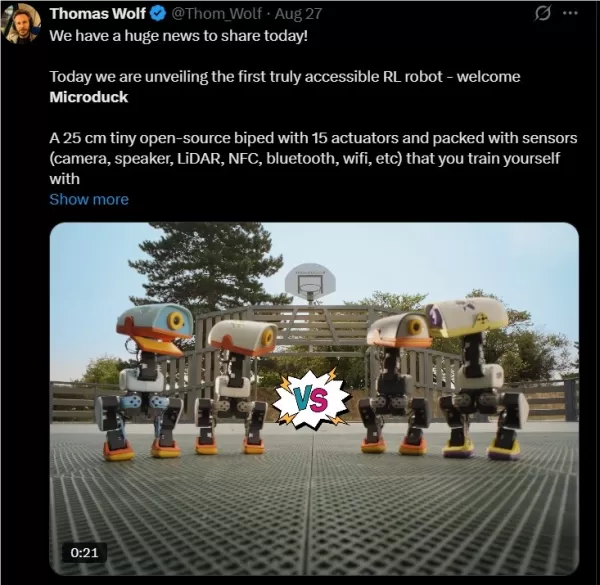
El robot bípedo en miniatura Microduck de 25 cm y 800 g, desarrollado por Pollen Robotics de Hugging Face, ha sido publicado como código abierto. Impulsado por un Rockchip RK3566, controla 15 servomotores a 50 Hz y realiza acciones como caminar, rodar y manipular objetos mediante aprendizaje por refuerzo. El proyecto incluye una transferencia Sim2Real utilizando PPO y aleatorización de dominio, con un modelo ONNX implementado en hardware real. Desarrollado en Rust, su arquitectura orientada a servicios garantiza la seguridad y actualizaciones OTA sin interrupciones con reversión automática. Esta plataforma ofrece un flujo de trabajo completo desde la simulación hasta el despliegue para la investigación en inteligencia encarnada.
El robot bípedo en miniatura Microduck de 25 cm y 800 g, desarrollado por Pollen Robotics de Hugging Face, ha sido publicado como código abierto. Impulsado por un Rockchip RK3566, controla 15 servomotores a 50 Hz y realiza acciones como caminar, rodar y manipular objetos mediante aprendizaje por refuerzo. El proyecto incluye una transferencia Sim2Real utilizando PPO y aleatorización de dominio, con un modelo ONNX implementado en hardware real. Desarrollado en Rust, su arquitectura orientada a servicios garantiza la seguridad y actualizaciones OTA sin interrupciones con reversión automática. Esta plataforma ofrece un flujo de trabajo completo desde la simulación hasta el despliegue para la investigación en inteligencia encarnada.
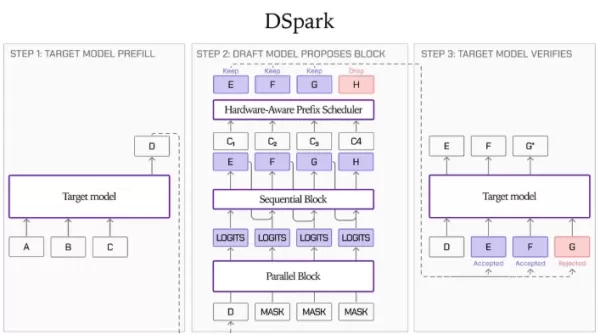
Liquid AI y Hugging Face han publicado los puntos de control del modelo preliminar DSpark para los tres modelos de la serie LFM2.5, los cuales cuentan con una ruta de decodificación especulativa que aumenta el rendimiento de inferencia hasta 3,18 veces en GPUs y 2,87 veces en dispositivos periféricos, sin afectar la calidad del resultado. Esta tecnología reduce en un 57% la latencia de las llamadas a funciones en el modelo LFM2.5-2.6B en escenarios de agentes periféricos, logrando un procesamiento de 139 tokens por segundo en un MacBook Pro M4Max, lo que disminuye las barreras para su implementación local y ofrece un rendimiento superior al de algunos modelos en la nube propietarios. Para superar las limitaciones de ancho de banda de memoria en los métodos tradicionales de inferencia, esta tecnología emplea un modelo preliminar ligero para generar tokens candidatos, los cuales son validados de forma uniforme. DSpark está compuesto por una red principal paralela, una capa de procesamiento secuencial y un validador de programación de confianza. El modelo preliminar inicial utiliza una arquitectura de 5 capas y 9 bloques basada únicamente en mecanismos de atención, con aproximadamente 300 millones de parámetros. La precisión del resultado sigue siendo idéntica a la obtenida con el método de decodificación tradicional. Desde su lanzamiento, DSpark es compatible con SGLang y llama.cpp.
Liquid AI y Hugging Face han publicado los puntos de control del modelo preliminar DSpark para los tres modelos de la serie LFM2.5, los cuales cuentan con una ruta de decodificación especulativa que aumenta el rendimiento de inferencia hasta 3,18 veces en GPUs y 2,87 veces en dispositivos periféricos, sin afectar la calidad del resultado. Esta tecnología reduce en un 57% la latencia de las llamadas a funciones en el modelo LFM2.5-2.6B en escenarios de agentes periféricos, logrando un procesamiento de 139 tokens por segundo en un MacBook Pro M4Max, lo que disminuye las barreras para su implementación local y ofrece un rendimiento superior al de algunos modelos en la nube propietarios. Para superar las limitaciones de ancho de banda de memoria en los métodos tradicionales de inferencia, esta tecnología emplea un modelo preliminar ligero para generar tokens candidatos, los cuales son validados de forma uniforme. DSpark está compuesto por una red principal paralela, una capa de procesamiento secuencial y un validador de programación de confianza. El modelo preliminar inicial utiliza una arquitectura de 5 capas y 9 bloques basada únicamente en mecanismos de atención, con aproximadamente 300 millones de parámetros. La precisión del resultado sigue siendo idéntica a la obtenida con el método de decodificación tradicional. Desde su lanzamiento, DSpark es compatible con SGLang y llama.cpp.
Anthropic planea recaudar 10 000 millones de dólares con una valoración de 350 000 millones de dólares liderada por Coatue y GIC, lo que casi duplica su valor desde su última ronda de financiación hace tres meses.
Anthropic planea recaudar 10 000 millones de dólares con una valoración de 350 000 millones de dólares liderada por Coatue y GIC, lo que casi duplica su valor desde su última ronda de financiación hace tres meses.
Naveen Raos, ex director de Databricks AI, ha recaudado 475 millones de euros en financiación inicial con una valoración de 45.000 millones, liderada por Andreessen Horowitz y Lightspeed Ventures. El objetivo de la ronda es llegar hasta los 1.000 millones.
Naveen Raos, ex director de Databricks AI, ha recaudado 475 millones de euros en financiación inicial con una valoración de 45.000 millones, liderada por Andreessen Horowitz y Lightspeed Ventures. El objetivo de la ronda es llegar hasta los 1.000 millones.
Las startups de codificación de IA como Windsurf enfrentan altos costos y márgenes negativos debido a los costosos LLMs y la competencia, lo que lleva a ventas estratégicas o esfuerzos de construcción de modelos, como se observa con Anysphere.
Las startups de codificación de IA como Windsurf enfrentan altos costos y márgenes negativos debido a los costosos LLMs y la competencia, lo que lleva a ventas estratégicas o esfuerzos de construcción de modelos, como se observa con Anysphere.


