


Entdecken Sie qualitativ hochwertige KI -Werkzeuge
Bringen Sie die weltweit führenden Tools für künstliche Intelligenz zusammen, um die Arbeitseffizienz zu verbessern

Artikel, die von WillGarcía veröffentlicht wurden
Elon Musk prognostiziert, dass die künstliche Intelligenz das Wirtschaftswachstum der USA im kommenden Jahr auf 4 % verdoppeln wird, im Gegensatz zu konservativeren Prognosen, die hohe Zinssätze und Produktivitätsrückstände anführen. Obwohl die Ausgaben für KI-Kapitalgüter bis 2029 3 % des BIP erreichen könnten, weisen Experten darauf hin, dass es in der Vergangenheit Verzögerungen bei der Umwandlung von Investitionen in wirtschaftliche Gewinne gab. Zinserhöhungen der Federal Reserve erhöhen die Unsicherheit und könnten trotz weiterhin hoher Ausgaben für die Technologieinfrastruktur kleinere Unternehmen behindern.
Elon Musk prognostiziert, dass die künstliche Intelligenz das Wirtschaftswachstum der USA im kommenden Jahr auf 4 % verdoppeln wird, im Gegensatz zu konservativeren Prognosen, die hohe Zinssätze und Produktivitätsrückstände anführen. Obwohl die Ausgaben für KI-Kapitalgüter bis 2029 3 % des BIP erreichen könnten, weisen Experten darauf hin, dass es in der Vergangenheit Verzögerungen bei der Umwandlung von Investitionen in wirtschaftliche Gewinne gab. Zinserhöhungen der Federal Reserve erhöhen die Unsicherheit und könnten trotz weiterhin hoher Ausgaben für die Technologieinfrastruktur kleinere Unternehmen behindern.

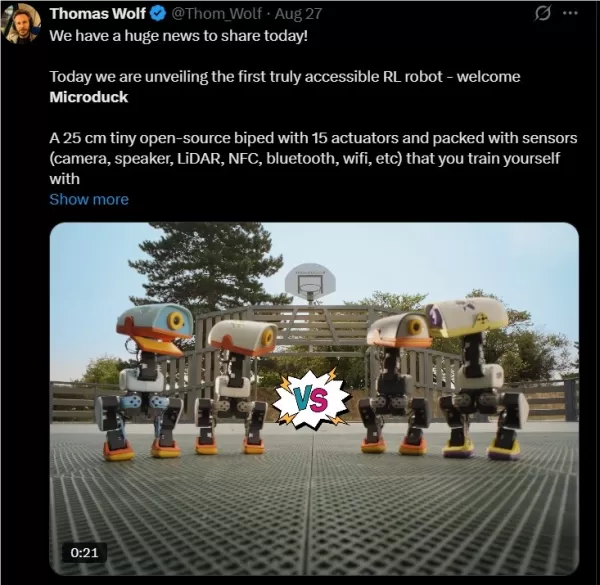
Hugging Faces Pollen Robotics hat Microduck, einen 25 cm großen, 800 g leichten miniaturisierten bipedalen Roboter, open-source veröffentlicht. Angetrieben von einem Rockchip RK3566 steuert er 15 Servos mit 50 Hz und führt Aktionen wie Gehen, Rollen und Objektmanipulation durch, die mittels Verstärkungslernen erlernt wurden. Das Projekt nutzt Sim2Real-Transfer mit PPO und Domain Randomization, wobei ein ONNX-Modell auf realer Hardware bereitgestellt wird. In Rust entwickelt, gewährleistet seine dienstorientierte Architektur Sicherheit und nahtlose OTA-Updates mit automatischem Rollback. Diese Plattform bietet eine vollständige Pipeline von der Simulation bis zur Bereitstellung für die Forschung zur verkörperten Intelligenz.
Hugging Faces Pollen Robotics hat Microduck, einen 25 cm großen, 800 g leichten miniaturisierten bipedalen Roboter, open-source veröffentlicht. Angetrieben von einem Rockchip RK3566 steuert er 15 Servos mit 50 Hz und führt Aktionen wie Gehen, Rollen und Objektmanipulation durch, die mittels Verstärkungslernen erlernt wurden. Das Projekt nutzt Sim2Real-Transfer mit PPO und Domain Randomization, wobei ein ONNX-Modell auf realer Hardware bereitgestellt wird. In Rust entwickelt, gewährleistet seine dienstorientierte Architektur Sicherheit und nahtlose OTA-Updates mit automatischem Rollback. Diese Plattform bietet eine vollständige Pipeline von der Simulation bis zur Bereitstellung für die Forschung zur verkörperten Intelligenz.
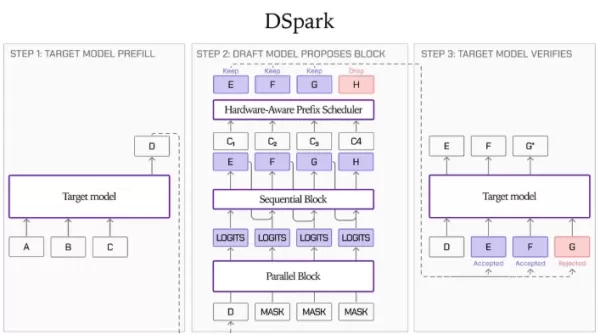
Liquid AI und Hugging Face haben Draft-Modell-Checkpoints für die drei Modelle der LFM2.5-Serie unter Verwendung von DSpark veröffentlicht. Diese Features einen spekulativen Dekodierpfad, der die Inferenzgeschwindigkeit auf GPUs um bis zu 3,18 Mal und auf Edge-Geräten um 2,87 Mal erhöht, ohne die Ausgabequalität zu beeinträchtigen. In Szenarien mit Edge-Agenten verringert er die Latenz bei den Funktionsaufrufen von LFM2.5-2.6B um 57 Prozent – auf einem M4Max MacBook Pro sind dadurch bis zu 139 Tokens pro Sekunde möglich. Dadurch werden die Hürden für eine lokale Implementierung gesenkt und es wird eine bessere Leistung erzielt als bei einigen proprietären Cloud-Modellen. Die Technologie bewältigt die Einschränkungen hinsichtlich der Speicherkapazitäten bei herkömmlichen Inferenzverfahren, indem sie ein leichtgewichtiges Draft-Modell verwendet, um Kandidaten-Token zu erzeugen, die anschließend einheitlich überprüft werden. Es setzt sich aus einem parallelen Backbone-Netzwerk, einem sequentiellen Head sowie einem Validierer zur Bestimmung des Vertrauensniveaus zusammen. Das ursprüngliche Draft-Modell basiert auf einer ausschließlich auf Attention beruhenden Architektur mit 5 Schichten und 9 Blöcken sowie rund 300 Millionen Parametern. Die Ausgabegenauigkeit bleibt im Vergleich zur Baseline-Methode des gierigen Dekodierens unverändert. Bei der Einführung ist DSpark mit SGLang und llama.cpp kompatibel.
Liquid AI und Hugging Face haben Draft-Modell-Checkpoints für die drei Modelle der LFM2.5-Serie unter Verwendung von DSpark veröffentlicht. Diese Features einen spekulativen Dekodierpfad, der die Inferenzgeschwindigkeit auf GPUs um bis zu 3,18 Mal und auf Edge-Geräten um 2,87 Mal erhöht, ohne die Ausgabequalität zu beeinträchtigen. In Szenarien mit Edge-Agenten verringert er die Latenz bei den Funktionsaufrufen von LFM2.5-2.6B um 57 Prozent – auf einem M4Max MacBook Pro sind dadurch bis zu 139 Tokens pro Sekunde möglich. Dadurch werden die Hürden für eine lokale Implementierung gesenkt und es wird eine bessere Leistung erzielt als bei einigen proprietären Cloud-Modellen. Die Technologie bewältigt die Einschränkungen hinsichtlich der Speicherkapazitäten bei herkömmlichen Inferenzverfahren, indem sie ein leichtgewichtiges Draft-Modell verwendet, um Kandidaten-Token zu erzeugen, die anschließend einheitlich überprüft werden. Es setzt sich aus einem parallelen Backbone-Netzwerk, einem sequentiellen Head sowie einem Validierer zur Bestimmung des Vertrauensniveaus zusammen. Das ursprüngliche Draft-Modell basiert auf einer ausschließlich auf Attention beruhenden Architektur mit 5 Schichten und 9 Blöcken sowie rund 300 Millionen Parametern. Die Ausgabegenauigkeit bleibt im Vergleich zur Baseline-Methode des gierigen Dekodierens unverändert. Bei der Einführung ist DSpark mit SGLang und llama.cpp kompatibel.
Anthropic plant, unter der Führung von Coatue und GIC 10 Milliarden US-Dollar bei einer Bewertung von 350 Milliarden US-Dollar aufzubringen, was fast einer Verdopplung seines Wertes seit der letzten Finanzierungsrunde vor drei Monaten entspricht.
Anthropic plant, unter der Führung von Coatue und GIC 10 Milliarden US-Dollar bei einer Bewertung von 350 Milliarden US-Dollar aufzubringen, was fast einer Verdopplung seines Wertes seit der letzten Finanzierungsrunde vor drei Monaten entspricht.
Der ehemalige KI-Chef von Databricks, Naveen Raos neues Startup Unconventional AI, hat eine Startfinanzierung in Höhe von 475 Millionen bei einer Bewertung von 45 Milliarden unter der Leitung von Andreessen Horowitz und Lightspeed Ventures erhalten Die Runde zielt auf bis zu 1 Milliarde ab Das Unternehmen will einen neuen energieeffizienten Computer für künstliche Intelligenz entwickeln
Der ehemalige KI-Chef von Databricks, Naveen Raos neues Startup Unconventional AI, hat eine Startfinanzierung in Höhe von 475 Millionen bei einer Bewertung von 45 Milliarden unter der Leitung von Andreessen Horowitz und Lightspeed Ventures erhalten Die Runde zielt auf bis zu 1 Milliarde ab Das Unternehmen will einen neuen energieeffizienten Computer für künstliche Intelligenz entwickeln
KI-Coding-Startups wie Windsurf stehen vor hohen Kosten und negativen Margen aufgrund teurer LLMs und Wettbewerb, was zu strategischen Verkäufen oder Modellbaubemühungen führt, wie bei Anysphere zu sehen ist.
KI-Coding-Startups wie Windsurf stehen vor hohen Kosten und negativen Margen aufgrund teurer LLMs und Wettbewerb, was zu strategischen Verkäufen oder Modellbaubemühungen führt, wie bei Anysphere zu sehen ist.


