


 首页
Text-to-Reward
文本到奖励(Text-to-Reward):RL 奖励模型开源框架


帮助 TikTok 卖家/品牌/MCN/TAP 选爆品、找达人
HelpLook 以一套AI驱动的知识库一体化工具,帮助企业快速搭建知识库、帮助中心与企
你的AI工作台
302.AI是企业级AI资源平台,按用量付费,全模型API接入,应用在线使用

剧火AI — AI编剧+导演,一人短剧工作室 一句话说清楚它是什么: 剧火AI 是一个 AI 驱动的
Tile 是什么?Tile 通过其人工智能驱动的平台,无需编码即可将创意转化为功能齐全的 iOS 和 Android 应用程序,从而彻底改变了移动应用程序的开发。这一创新解决方案将人工智能与专业级基础设施相结合,实现了从用户界面设计到用户身份验证和支付处理等后台服务的自动化。企业主和创作者可在数小时内生成可直接投入生产的应用程序,并可导出简洁的代码,直接发布到各大应用程序商店。如何使用Ti
什么是RAGFlow ?RAGFlow RAGFlow 是一款开源的 RAG(检索增强生成)引擎,旨在简化 AI 代理的创建和部署。它将智能文档处理与向量搜索相结合,将来自 PDF、网站和数据库的非结构化数据转换为自定义知识库。 开发者可通过其 Python SDK 或 RESTful API,利用任何大型语言模型获取精准上下文并生成准确答案。 支持多种智能代理工作流,包括聊天机器人、摘要工具和
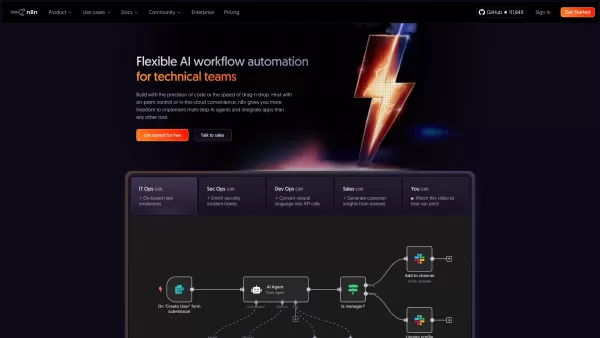
什么是n8n? n8n 这是一款融合人工智能与流程自动化的强大工作流自动化平台。它为开发者提供代码控制权与可视化编辑器的简易性,助力其创建复杂的人工智能代理,并连接超过500款应用程序。您可将n8n部署在自有服务器上以获得最大控制权,或选择其托管云服务以实现便捷操作。如何使用n8n? 您可通过可视化设计或编写自定义JavaScript/Python代码来构建工作流。该平台支持与任意大型语言模型(L
如果你对探索AI聊天机器人感兴趣,让我为你介绍一下免费的Google Gemini AI聊天机器人。这不仅仅是一个聊天机器人——它由强大的Google Gemini技术驱动,成为满足你所有对话需求的强大工具。\n\n如何使用免费的Google Gemini AI聊天机器人?\n-------------\n\n开始使用就像吃馅饼一样简单!你所需要的只是一个Google Gemini API密钥。一旦你有了它,就可以完全免费享受聊天机器人的功能。这就像在指尖拥有一个个人AI助手,没有隐藏费用的麻烦
DeepShare 是什么?DeepShare 这是一个雄心勃勃的实验性平台,旨在将全球的创造者、思想家和学习者聚集在一个屋檐下。它不仅仅是另一个内容共享网站,而是一个深度内容聚合中心,用户可以在这里围绕人工智能、网络开发、机器学习以及尖端工具和模型等主题进行探索、创造和交流。在这里,思想碰撞、知识倍增、创新蓬勃。DeepShare 如何工作?DeepShare 的核心是发现和贡献。无论您是想
Text-to-Reward产品信息
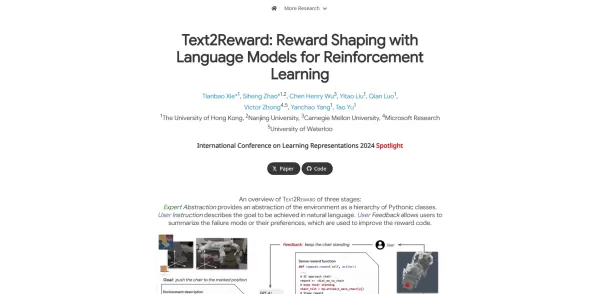
什么是Text-to-Reward ?
Text-to-Reward 它为训练奖励模型提供了一套完整的工作流程,可将基于文本的任务描述或反馈转化为强化学习代理的标量奖励。通过利用基于转换器的架构和对人类偏好数据集的微调,该系统可自动学习将自然语言指令解释为奖励信号。用户可以通过文本提示定义任何任务,训练模型,并将生成的奖励函数集成到任何 RL 算法中。这消除了人工奖励塑造,提高了采样效率,并允许代理在模拟或真实环境中执行复杂的多步骤指令。
谁在使用Text-to-Reward ?
- 强化学习研究人员
- 机器学习工程师
- 机器人开发人员
- 人工智能学生和学者
- 游戏人工智能开发人员
如何使用Text-to-Reward
- 第一步:使用 pip 安装Text-to-Reward Python 软件包。
- 第 2 步:准备一个数据集,其中包含与偏好或奖励注释配对的文本指令。
- 第 3 步:使用附带的训练脚本配置和训练奖励模型。
- 第 4 步:导出训练好的模型并将其纳入 RL 管道(如 OpenAI Gym)。
- 第 5 步:使用学习到的奖励函数运行 RL 代理并评估其性能。
平台
- MacOS
- Windows
- Linux
Text-to-Reward 核心功能与优势
核心功能
- 自然语言条件奖励建模
- 基于变换器的架构
- 根据人类偏好数据进行训练
- 与 OpenAI Gym 无缝集成
- 可输出奖励函数,与任何 RL 算法兼容
优势
- 无需人工奖励工程
- 适用于各种任务和环境
- 提供可解释的语言驱动奖励信号
- 提高采样效率
- 允许通过文本自定义任务定义
主要用例和应用
- 使用文本任务描述进行机器人控制
- 遵循语言目标的游戏代理
- 使用不同指令的多任务强化学习
- 用于改进策略的人在环反馈
- 通过语言指令进行模拟环境导航
Text-to-Reward 优缺点
优点
自动生成密集奖励函数,无需领域知识或数据
使用大型语言模型解释自然语言目标
支持通过人工反馈进行迭代改进
在基准测试中取得与专家设计的奖励相当或更高的性能
可将模拟训练的策略部署到真实世界环境中
生成可解释的自由形式奖励代码
Text-to-Reward 常见问题
Text-to-Reward 是什么?
Text-to-Reward 是一个通过自然语言指令为强化学习代理训练奖励模型的框架。
如何安装Text-to-Reward ?
通过 pip 安装: pip installtext-to-reward ,并参考文档中的安装说明。
支持哪些环境?
默认情况下,它与 OpenAI Gym 一起工作,也可适用于自定义模拟或真实世界环境。
它使用什么模型?
它采用基于变换器的架构,并根据人类偏好数据进行微调,以预测奖励值。
如何准备训练数据?
按照文档中概述的格式创建指令-奖励或偏好对数据集。
是否提供预训练模型?
目前,官方不提供预训练模型;用户必须在自己的数据上训练模型。
如何评估学习到的奖励函数?
将其集成到 RL 代理中,并与手动设计的基线进行性能比较。
支持哪些编程语言?
Text-to-Reward 目前,"RL "是一个 Python 库。
我能为该项目做出贡献吗?
可以,欢迎通过 GitHub 存储库进行贡献;请遵守贡献指南。
Text-to-Reward 采用何种许可证?
该项目采用 MIT 许可发布。
Text-to-Reward 公司信息
- Text-to-Reward 项目名称
- xlang-ai
- https://xlang.ai/
- @XLangNLP
- README.md
Text-to-Reward截图


2026年最新最佳漫画AI背景生成器排行榜——高评分精选!这份精心策划的合集展示了功能强大、颠覆传统的工具,非常适合制作高质量的章节背景、书籍封面和宣传插画。每款工具都经过了严格的实际测试,以确保其可靠性。 获取免费版与付费版的对比分析及详细解读。立即探索,发现最适合您的工具,在漫画创作中释放AI带来的竞争优势。
 6 个工具
 xix.ai
2026年最新最佳、评分最高的AI对象移除编辑器,适用于人像、旅行及产品摄影!XIX.AI精心精选了一系列功能强大、颠覆性的工具,并通过每周排名持续更新。这些工具经过实际测试,可帮助您快速移除不需要的元素、提升内容质量,并在不影响效果的前提下节省大量时间。 对于任何希望释放AI创作潜能的人来说,这都是必试之选。立即探索!
10 个工具
xix.ai
2026年最新、最佳、评价最高的在线课程AI文本转语音工具由XIX.AI根据严格的实际测试和每周更新的排名精心挑选。这些强大的工具可帮助内容创作者轻松生成清晰流畅的音频内容,从而提高写作效率并简化课程制作流程。查看免费版与付费版的对比,找到最适合您的选择。 立即探索,在在线教育领域释放您的AI优势。
10 个工具
xix.ai
2026 年最新最佳高评分 AI 博客标题工具,提升点击率!XIX.AI 精心策划了一套强大且改变游戏规则的工具合集,均经过严格的真实世界测试。您将找到免费与付费版本的对比、每周更新的排名以及详细的见解,帮助您高效提升博客流量。重点推荐必试选项,助您释放 AI 优势。立即探索!
10 个工具
xix.ai
2026年最新、最佳、评分最高的AI任务分发工具,助力支持工作流!XIX.AI精心挑选了一系列功能强大、颠覆行业且必试的解决方案,所有工具均经过严格的实际测试,并每周更新。这些工具可优化工作流、提升生产力,并帮助团队提供更快、更高效的支持服务。 立即探索,发现最适合您的工具,释放您的AI优势!
17 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI文献引用与论文摘要工具,由XIX.AI精心精选。获取这些功能强大、颠覆性的解决方案,助您快速创建内容、提升写作效率并提高生产力。我们提供免费版与付费版的对比分析,辅以实际测试结果和每周更新的排行榜,帮助您找到最适合自身需求、绝对值得一试的工具。 立即探索,解锁您的AI优势。
10 个工具
xix.ai


Интересный подход к обучению с подкреплением через текстовые описания! 🧠 Возможно, это поможет создать более 'осмысленных' ИИ-агентов, которые лучше понимают цели. Хотелось бы увидеть больше примеров применения в играх или робототехнике. Есть вопросы по настройке гиперпараметров модели.


