


 Heim
Text-to-Reward
Text-zu-Belohnung: Open-Source Framework für RL-Belohnungsmodelle


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?
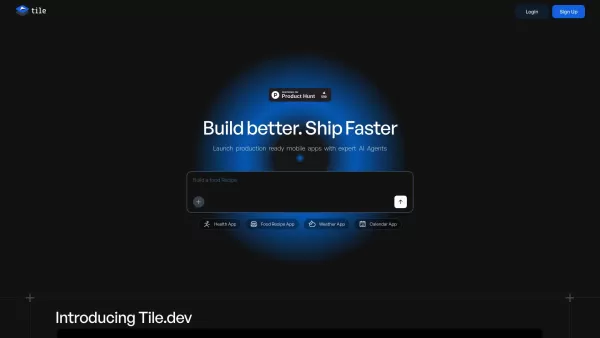
Was ist Tile?Tile revolutioniert die Entwicklung mobiler Apps mit seiner KI-gesteuerten Plattform, die Ideen in voll funktionsfähige iOS- und Android-Apps ohne Programmierung verwandelt. Diese innov
Was ist „ RAGFlow “?RAGFlow ist eine Open-Source-RAG-Engine (Retrieval-Augmented Generation), die entwickelt wurde, um die Erstellung und Bereitstellung von KI-Agenten zu vereinfachen. Sie kombiniert
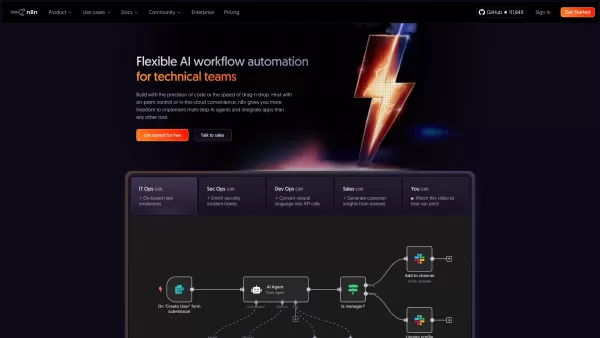
Was ist „n8n“? n8n ist eine leistungsstarke Plattform zur Workflow-Automatisierung, die KI mit Prozessautomatisierung verbindet. Sie bietet Entwicklern die Kontrolle über den Code sowie die Einfachhei
Wenn Sie neugierig auf die Welt der AI -Chatbots eintauchen, lassen Sie mich Sie mit dem kostenlosen Google Gemini AI Chatbot vorstellen. Dies ist kein Chatbot - es wird von der robusten Google Gemini -Technologie betrieben, was es zu einem Kraftpake
Was ist DeepShare?DeepShare ist eine ehrgeizige, experimentelle Plattform, die eine globale Gemeinschaft von Kreativen, Denkern und Lernenden unter einem Dach zusammenbringen soll. Es ist nicht einfa
Text-to-Reward Produktinformationen
Was ist Text-to-Reward?
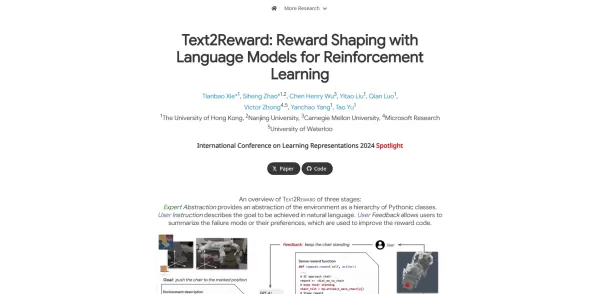
Text-to-Reward bietet einen kompletten Arbeitsablauf für das Training von Belohnungsmodellen, die textbasierte Aufgabenbeschreibungen oder Feedback in skalare Belohnungen für Reinforcement Learning Agenten übersetzen. Durch den Einsatz von transformatorbasierten Architekturen und die Feinabstimmung auf menschliche Präferenzdaten lernt das System automatisch, natürlichsprachliche Anweisungen als Belohnungssignale zu interpretieren. Benutzer können jede Aufgabe durch Textaufforderungen definieren, das Modell trainieren und die resultierende Belohnungsfunktion in jeden RL-Algorithmus integrieren. Dadurch entfällt die manuelle Gestaltung von Belohnungen, die Effizienz der Proben wird verbessert und die Agenten können komplexe mehrstufige Anweisungen in simulierten oder realen Umgebungen ausführen.
Wer benutzt Text-to-Reward?
- Forscher im Bereich Reinforcement Learning
- Ingenieure für maschinelles Lernen
- Robotik-Entwickler
- KI-Studenten und Akademiker
- Spiele-KI-Entwickler
Wie man es benutzt Text-to-Reward
- Schritt 1: Installieren Sie das Text-to-Reward Python-Paket mit pip.
- Schritt 2: Bereiten Sie einen Datensatz vor, der Textanweisungen gepaart mit Präferenz- oder Belohnungsannotationen enthält.
- Schritt 3: Konfigurieren und trainieren Sie das Belohnungsmodell mithilfe der mitgelieferten Trainingsskripte.
- Schritt 4: Exportieren Sie das trainierte Modell und binden Sie es in Ihre RL-Pipeline ein (z.B. OpenAI Gym).
- Schritt 5: Lassen Sie Ihren RL-Agenten mit der gelernten Belohnungsfunktion laufen und bewerten Sie seine Leistung.
Plattform
- macOS
- Windows
- Linux
Text-to-Reward Hauptmerkmale & Vorteile
Wesentliche Merkmale
- Natursprachlich bedingte Belohnungsmodellierung
- Transformer-basierte Architektur
- Training mit menschlichen Präferenzdaten
- Nahtlose Integration mit OpenAI Gym
- Exportierbare Belohnungsfunktionen, die mit jedem RL-Algorithmus kompatibel sind
Vorteile
- Beseitigt die Notwendigkeit der manuellen Belohnungserstellung
- Skalierbar für verschiedene Aufgaben und Umgebungen
- Bietet interpretierbare sprachgesteuerte Belohnungssignale
- Verbessert die Effizienz von Proben
- Ermöglicht anpassbare Aufgabendefinitionen durch Text
Hauptanwendungsfälle & Anwendungen
- Robotersteuerung mit textuellen Aufgabenbeschreibungen
- Spielende Agenten, die sprachbasierte Ziele verfolgen
- Multi-Task Reinforcement Learning mit unterschiedlichen Anweisungen
- Human-in-the-Loop-Feedback zur Verbesserung von Strategien
- Simulierte Umgebungsnavigation über Sprachbefehle
Text-to-Reward Pro und Kontra
Vorteile
Erzeugt automatisch dichte Belohnungsfunktionen, ohne dass Fachwissen oder Daten erforderlich sind
Verwendet umfangreiche Sprachmodelle zur Interpretation natürlichsprachlicher Ziele
Unterstützt iterative Verfeinerung mit menschlichem Feedback
Erzielt bei Benchmarks eine Leistung, die mit von Experten entwickelten Belohnungen vergleichbar ist oder diese übertrifft
Ermöglicht den Einsatz von in der Simulation trainierten Richtlinien in der realen Welt
Erzeugt interpretierbaren, frei formulierten Belohnungscode
Text-to-Reward Häufig gestellte Fragen
Was ist Text-to-Reward?
Text-to-Reward ist ein Framework, das Belohnungsmodelle aus natürlichsprachlichen Anweisungen für Reinforcement Learning Agents trainiert.
Wie kann ich Text-to-Reward installieren?
Installieren Sie über pip: pip install text-to-reward und lesen Sie die Dokumentation für die Installationsanweisungen.
Welche Umgebungen werden unterstützt?
Es funktioniert standardmäßig mit OpenAI Gym und kann für eigene simulierte oder reale Umgebungen angepasst werden.
Welche Modelle verwendet es?
Es verwendet transformatorbasierte Architekturen, die auf der Grundlage menschlicher Präferenzdaten feinabgestimmt wurden, um Belohnungswerte vorherzusagen.
Wie bereite ich Trainingsdaten vor?
Erstellen Sie einen Datensatz mit Anweisungs-Belohnungs- oder Präferenzpaaren, die wie in der Dokumentation beschrieben formatiert sind.
Sind bereits trainierte Modelle verfügbar?
Zurzeit werden keine offiziellen vortrainierten Modelle angeboten; die Benutzer müssen die Modelle mit ihren eigenen Daten trainieren.
Wie kann ich die gelernte Belohnungsfunktion auswerten?
Integrieren Sie sie in einen RL-Agenten und vergleichen Sie die Leistung mit manuell erstellten Basislinien.
Welche Programmiersprachen werden unterstützt?
Text-to-Reward ist derzeit als Python-Bibliothek verfügbar.
Kann ich zu dem Projekt beitragen?
Ja, Beiträge sind über das GitHub-Repository willkommen; bitte beachten Sie die Richtlinien für Beiträge.
Welche Lizenz gilt für Text-to-Reward?
Das Projekt ist unter der MIT-Lizenz veröffentlicht.
Text-to-Reward Informationen zum Unternehmen
- Text-to-Reward Projekt
- xlang-ai
- https://xlang.ai/
- @XLangNLP
- README.md
Text-to-Reward Screenshot


2026: Die besten Manga-KI-Hintergrundgeneratoren im Ranking – die Top-Bewertungen! Diese sorgfältig zusammengestellte Sammlung präsentiert leistungsstarke, bahnbrechende Tools, die sich perfekt für die Erstellung hochwertiger Kapitelhintergründe, Buchcover und Werbegrafiken eignen. Jede Option wurde strengen Praxistests unterzogen, um ihre Zuverlässigkeit sicherzustellen. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Einblicke. Entdecken Sie jetzt das perfekte Tool für sich und nutzen Sie den KI-Vorteil bei der Manga-Erstellung.
 6 Tools
 xix.ai

Die besten und am besten bewerteten KI-Tools zum Entfernen von Objekten aus Porträts, Reisefotos und Produktfotos im Jahr 2026! XIX.AI stellt eine leistungsstarke, bahnbrechende Auswahl zusammen, die regelmäßig mit wöchentlichen Rankings aktualisiert wird. Diese Tools wurden in der Praxis getestet und helfen Ihnen dabei, unerwünschte Elemente schnell zu entfernen, die Qualität Ihrer Inhalte zu steigern und viel Zeit zu sparen, ohne dabei Abstriche bei den Ergebnissen zu machen. Ein Muss für alle, die ihr kreatives Potenzial mit KI voll ausschöpfen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Text-to-Speech-Tools für Online-Kurse des Jahres 2026 wurden von XIX.AI auf der Grundlage strenger Praxistests und wöchentlich aktualisierter Rankings zusammengestellt. Diese leistungsstarken Tools helfen Kursanbietern dabei, mühelos kristallklare Audioinhalte zu erstellen, die Effizienz beim Verfassen von Texten zu steigern und die Kursproduktion zu optimieren. Sehen Sie sich den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten an, um das für Sie passende Tool zu finden. Entdecken Sie jetzt, wie Sie sich im Bereich der Online-Bildung einen KI-Vorteil verschaffen können.
10 Tools
xix.ai

2026 Neueste Beste Top-Bewertete KI-Blogtitel-Tools für höhere Klickraten! XIX.AI hat sorgfältig eine leistungsstarke, spielfreudige Sammlung der besten Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden einen kostenlosen vs. kostenpflichtigen Vergleich, wöchentlich aktualisierte Rankings und detaillierte Einblicke, die Ihnen helfen, den Traffic Ihres Blogs effizient zu steigern. Besonders empfehlenswerte Optionen sind hervorgehoben, um Ihnen zu helfen, Ihren KI-Vorteil zu entfalten. Entdecken Sie jetzt!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Aufgabenverteilung in Support-Workflows – Stand 2026! XIX.AI hat eine äußerst leistungsstarke und bahnbrechende Auswahl an Lösungen zusammengestellt, die Sie unbedingt ausprobieren sollten. Alle wurden strengen Praxistests unterzogen und werden wöchentlich aktualisiert. Diese Tools optimieren Arbeitsabläufe, steigern die Produktivität und helfen Teams dabei, einen schnelleren und effizienteren Support zu bieten. Entdecken Sie jetzt das perfekte Tool für Sie und nutzen Sie Ihren KI-Vorteil!
17 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Zitate und Zusammenfassungen wissenschaftlicher Artikel im Jahr 2026 – zusammengestellt von XIX.AI. Holen Sie sich leistungsstarke, bahnbrechende Lösungen für die schnelle Erstellung von Inhalten, mehr Effizienz beim Schreiben und eine Steigerung Ihrer Produktivität. Wir bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, damit Sie das Tool finden, das perfekt zu Ihren Anforderungen passt und das Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
10 Tools
xix.ai


Интересный подход к обучению с подкреплением через текстовые описания! 🧠 Возможно, это поможет создать более 'осмысленных' ИИ-агентов, которые лучше понимают цели. Хотелось бы увидеть больше примеров применения в играх или робототехнике. Есть вопросы по настройке гиперпараметров модели.


