


 首頁
Text-to-Reward
Text-to-Reward:RL 獎勵模型的開放源碼框架


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?
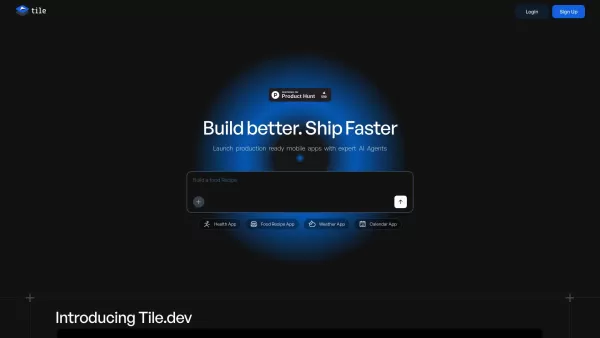
Tile 是什麼?Tile 透過其人工智能驅動平台,無需編碼即可將構想轉換為功能完整的 iOS 和 Android 應用程式,為行動應用程式開發帶來革命性的改變。這個創新的解決方案結合了人工智慧與專業級的基礎架構,從 UI 設計到後端服務 (例如使用者驗證與付款處理) 皆可自動化。企業主和創造者可在數小時內生成可立即投入生產的應用程式,並輸出乾淨的程式碼,以及直接在主要應用程式商店發佈的功能。
什麼是RAGFlow ?RAGFlow 是一款開源的 RAG(檢索增強生成)引擎,旨在簡化 AI 代理的建立與部署。它結合了智慧文件處理與向量搜尋技術,能將來自 PDF、網站及資料庫的非結構化資料轉化為客製化的知識庫。 開發者可透過其 Python SDK 或 RESTful API,擷取精確的上下文,並結合任何大型語言模型生成準確的答案。RAGFlow 支援多種代理程式工作流程,包括聊天機器人、
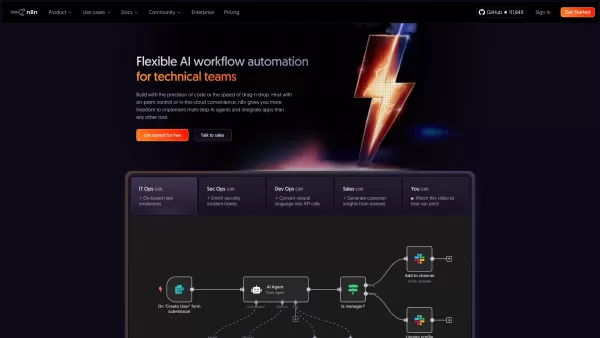
什麼是n8n? n8n 是一款強大的工作流程自動化平台,融合人工智慧與流程自動化技術。它讓開發者既能掌控程式碼,又能享受視覺化編輯器的簡便性,賦予他們建立複雜人工智慧代理程式並串接超過500款應用程式的能力。您可將n8n部署於自有伺服器以獲得最大控制權,或選擇其託管雲端服務以提升使用便利性。如何使用n8n? 您可透過視覺化設計或編寫自訂 JavaScript/Python 程式碼來建構工作流程。本
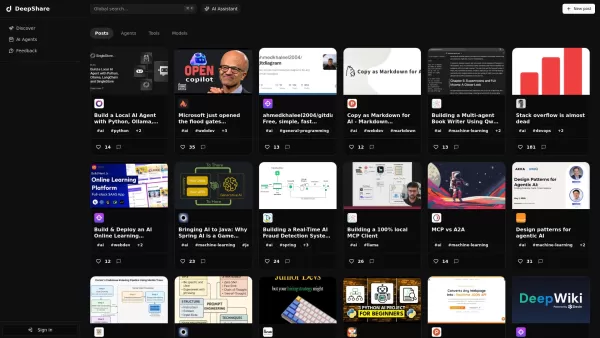
DeepShare 是什麼?DeepShare 是一個雄心勃勃的實驗性平台,旨在將全球的創造者、思考者和學習者聚集在同一屋簷下。它不只是另一個內容分享網站,而是一個深入的內容聚合中心,使用者可以在此探索、創造,並就人工智慧、網路開發、機器學習、尖端工具與模型等主題進行交流。您可以將它視為一個思想碰撞、知識倍增、創新蓬勃的地方。DeepShare 如何運作?DeepShare 的核心是為探索和貢
如果你對探索AI聊天機器人感興趣,讓我為你介紹一下免費的Google Gemini AI聊天機器人。這不僅僅是一個聊天機器人——它由強大的Google Gemini技術驅動,成為滿足你所有對話需求的強大工具。\n\n如何使用免費的Google Gemini AI聊天機器人?\n-------------\n\n開始使用就像吃餡餅一樣簡單!你所需要的就是一個Google Gemini API金鑰。一旦你有了它,就可以完全免費享受聊天機器人的功能。這就像在指尖擁有個人AI助手,沒有隱藏費用的麻煩。\
Text-to-Reward產品信息
Text-to-Reward 是什麼?
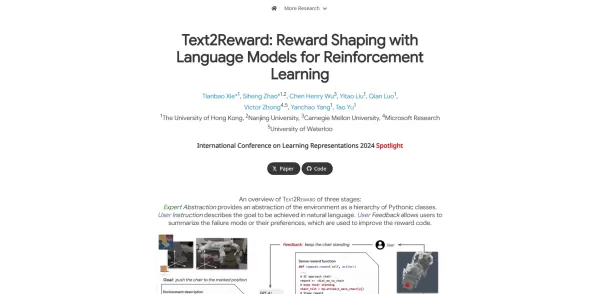
Text-to-Reward 提供訓練獎勵模型的完整工作流程,可將以文字為基礎的任務描述或回饋轉換為強化學習代理的標量獎勵。藉由利用轉換器架構和人類偏好資料集的微調,系統會自動學習將自然語言指令詮釋為獎勵信號。使用者可以透過文字提示定義任何任務、訓練模型,並將所得的獎勵函數整合到任何 RL 演算法中。這樣就省去了人工獎勵塑造,提高了取樣效率,並允許代理在模擬或真實環境中執行複雜的多步指令。
誰會使用Text-to-Reward?
- 強化學習研究人員
- 機器學習工程師
- 機器人開發人員
- AI 學生與學者
- 遊戲 AI 開發人員
如何使用Text-to-Reward
- 步驟 1:使用 pip 安裝Text-to-Reward Python 套件。
- 步驟 2:準備一個資料集,其中包含搭配偏好或獎勵註解的文字指示。
- 步驟 3:使用隨附的訓練腳本設定並訓練獎勵模型。
- 步驟 4:匯出訓練好的模型,並將其納入您的 RL 管道 (例如 OpenAI Gym)。
- 步驟 5:使用學習到的獎勵功能執行您的 RL 代理,並評估其效能。
平台
- MacOS
- 視窗
- Linux
Text-to-Reward 核心功能與優點
核心功能
- 自然語言條件獎勵建模
- 以變形器為基礎的架構
- 在人類偏好資料上進行訓練
- 與 OpenAI Gym 無縫整合
- 可輸出獎勵功能,與任何 RL 演算法相容
優點
- 無需手動獎勵工程
- 適用於各種任務與環境
- 提供可解釋的語言驅動獎勵信號
- 提高取樣效率
- 允許透過文字自訂任務定義
主要使用案例與應用
- 使用文字任務描述的機器人控制
- 遵循語言目標的遊戲代理
- 使用不同指令的多任務強化學習
- 人在迴圈回饋以改善政策
- 透過語言指令進行模擬環境導航
Text-to-Reward 優點與缺點
優點
自動產生密集的獎勵函數,不需要領域知識或資料
使用大型語言模型詮釋自然語言目標
支援人類回饋的迭代改進
在基準上達到媲美或超越專家設計獎勵的效能
可將模擬訓練的政策部署到真實世界設定中
生成可解釋的自由形式獎勵代碼
Text-to-Reward 常見問題
Text-to-Reward 是什麼?
Text-to-Reward 是一個用自然語言指令為強化學習代理訓練獎勵模型的框架。
如何安裝Text-to-Reward?
透過 pip 安裝: pip installtext-to-reward ,並參閱說明文件中的設定指示。
支援哪些環境?
預設支援 OpenAI Gym,也可以針對自訂的模擬或真實世界環境進行調整。
它使用哪些模型?
它採用基於變換器的架構,並根據人類偏好資料進行微調,以預測獎勵值。
如何準備訓練資料?
按照文件中概述的格式建立指令-獎勵或偏好對的資料集。
是否提供預先訓練的模型?
目前,官方沒有提供預先訓練的模型;使用者必須在自己的資料上訓練模型。
如何評估學習到的獎勵函數?
將它整合到 RL 代理中,並與手動設計的基線比較效能。
支援哪些程式語言?
Text-to-Reward 目前可使用 Python 程式庫。
我可以為專案貢獻嗎?
可以,歡迎透過 GitHub 儲存庫進行貢獻;請遵循貢獻指南。
Text-to-Reward 採用何種授權條款?
本專案採用 MIT 授權釋出。
Text-to-Reward 公司資訊
- Text-to-Reward 專案
- xlang-ai
- https://xlang.ai/
- @XLangNLP
- README.md
Text-to-Reward屏幕截圖


2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
 10 個工具
 xix.ai

2026 年最新、最受好評的 AI 提示詞庫,可優化各類 ChatGPT 工作流程。XIX.AI 精心蒐羅了一套強大且具革命性的精選集合,並經過嚴格的實際測試,以確保其表現卓越。 您可查閱詳盡的免費版與付費版比較分析,以及專家評比,助您挑選必試工具,從而提升工作效率並釋放您的 AI 優勢。立即探索!
11 個工具
xix.ai

2026年最新最佳AI測驗構建平臺,適用於教師、輔導老師和基於群體的學習專案!XIX.AI精心整理了一份頂級評分列表,包含經過現實世界測試的強力變革性工具,以提供準確的排名。這些必試平臺有助於提高寫作效率、簡化內容創作,並簡化各種學習場景中的測驗設計。立即探索,發現您解鎖教學AI優勢的理想工具!
13 個工具
xix.ai

2026 年最新、最優秀的 GitHub 團隊 AI 拉取請求審查工具,就在 XIX.AI!這份精選且評價極高的清單,展示了多款強大且能徹底改變遊戲規則的解決方案,可優化所有團隊工作流程中的重構、錯誤修復及安全漏洞偵測。 透過免費與付費版本的比較、實際測試結果以及詳細排名,協助您找到能顯著提升生產力的完美工具。立即探索,釋放您的 AI 競爭優勢!
12 個工具
xix.ai

2026 年最新、最受好評的頂級 AI 文字轉語音工具,助您打造自然生動的配音,盡在 XIX.AI!這份精選清單收錄了強大且顛覆業界的選項,能為各種使用情境提供水晶般清晰的語音,並經由實際測試驗證,排行榜更每週更新。 立即獲取免費版與付費版的比較指南,找出能瞬間提升您工作效率的必試解決方案。現在就來探索,解鎖您的 AI 競爭優勢!
11 個工具
xix.ai

2026 年最新最佳漫畫 AI 背景生成器排行榜:高評價精選!這份精心策劃的合集展示了強大且能改變遊戲規則的工具,非常適合製作高品質的章節背景、書封及宣傳插畫。每項選項都經過嚴格的實際測試,以確保其可靠性。 立即獲取免費版與付費版的比較分析及詳細評析。現在就來探索,找出最適合您的工具,並在漫畫創作中發揮 AI 的優勢。
6 個工具
xix.ai


Интересный подход к обучению с подкреплением через текстовые описания! 🧠 Возможно, это поможет создать более 'осмысленных' ИИ-агентов, которые лучше понимают цели. Хотелось бы увидеть больше примеров применения в играх или робототехнике. Есть вопросы по настройке гиперпараметров модели.


