


 Дом
Text-to-Reward
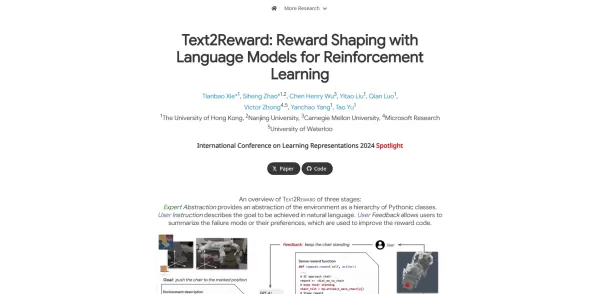
Text-to-Reward: Фреймворк с открытым исходным кодом для моделей вознаграждения RL


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?
Что такое Tile?Tile Компания совершает революцию в разработке мобильных приложений благодаря своей платформе, управляемой искусственным интеллектом, которая превращает идеи в полнофункциональные пр
Что такое RAGFlow?RAGFlow — это движок RAG (Retrieval-Augmented Generation) с открытым исходным кодом, разработанный для упрощения создания и развертывания ИИ-агентов. Он объединяет интеллектуальную о
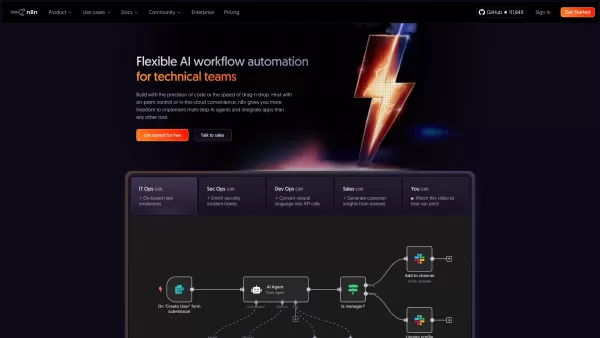
Что такое «n8n»? n8n — это мощная платформа для автоматизации рабочих процессов, сочетающая в себе искусственный интеллект и автоматизацию процессов. Она предлагает разработчикам контроль над кодом на
Если вы хотите познакомиться с миром чат-ботов на базе ИИ, позвольте представить вам Free Google Gemini AI ChatBot. Это не просто чат-бот – он работает на мощной технологии Google Gemini, что делает его мощным помощником для всех ваших потребностей в
Что такое DeepShare?DeepShare это амбициозная, экспериментальная платформа, призванная собрать под одной крышей глобальное сообщество творцов, мыслителей и обучающихся. Это не просто очередной сайт д
Text-to-Reward Информация о продукте
Что такое Text-to-Reward?
Text-to-Reward предлагает полный рабочий процесс для обучения моделей вознаграждения, которые переводят текстовые описания задач или обратную связь в скалярные вознаграждения для агентов обучения с подкреплением. Благодаря использованию архитектур на основе трансформаторов и тонкой настройке на базе данных о человеческих предпочтениях система автоматически учится интерпретировать инструкции на естественном языке как сигналы вознаграждения. Пользователи могут задать любую задачу с помощью текстовых подсказок, обучить модель и интегрировать полученную функцию вознаграждения в любой алгоритм RL. Это избавляет от необходимости вручную формировать вознаграждение, повышает эффективность выборки и позволяет агентам выполнять сложные многоступенчатые инструкции в симулированных или реальных условиях.
Кто использует Text-to-Reward?
- Исследователи в области обучения с применением подкрепления
- Инженеры машинного обучения
- Разработчики робототехники
- Студенты и преподаватели ИИ
- Разработчики игрового ИИ
Как использовать Text-to-Reward
- Шаг 1: Установите пакет Text-to-Reward Python с помощью pip.
- Шаг 2. Подготовьте набор данных, содержащий текстовые инструкции в паре с аннотациями предпочтений или вознаграждений.
- Шаг 3: Настройте и обучите модель вознаграждения, используя прилагаемые скрипты обучения.
- Шаг 4: Экспортируйте обученную модель и включите ее в свой RL-конвейер (например, OpenAI Gym).
- Шаг 5: Запустите своего RL-агента с обученной функцией вознаграждения и оцените его производительность.
Платформа
- macOS
- Windows
- Linux
Text-to-Reward Основные возможности и преимущества
Особенности ядра
- Моделирование вознаграждения с учетом естественного языка
- Архитектура на основе трансформаторов
- Обучение на данных о предпочтениях человека
- Бесшовная интеграция с OpenAI Gym
- Экспортируемые функции вознаграждения, совместимые с любым алгоритмом RL
Преимущества
- Устраняет необходимость ручной разработки вознаграждений
- Масштабируется для различных задач и сред
- Обеспечивает интерпретируемые языковые сигналы вознаграждения
- Повышает эффективность выборки
- Позволяет настраивать определения задач с помощью текста
Основные примеры использования и применения
- Управление роботами с помощью текстовых описаний задач
- Игровые агенты, которые следуют целям, основанным на языке
- Многозадачное обучение с подкреплением и разнообразными инструкциями
- Обратная связь с человеком в контуре для улучшения политики
- Моделируемая навигация по окружающей среде с помощью языковых команд
Text-to-Reward Плюсы и минусы
Плюсы
Автоматически генерирует плотные функции вознаграждения, не требуя знаний или данных о домене
Использует большие языковые модели для интерпретации целей на естественном языке
Поддерживает итеративную доработку с обратной связью от человека
Достигнута производительность, сопоставимая или превышающая производительность вознаграждений, разработанных экспертами, на эталонных тестах
Позволяет внедрять политики, обученные в симуляторе, в реальные условия.
Генерирует интерпретируемый код вознаграждения в свободной форме
Text-to-Reward Вопросы и ответы
Что такое Text-to-Reward?
Text-to-Reward это фреймворк, который обучает модели вознаграждения из инструкций на естественном языке для агентов обучения с подкреплением.
Как установить Text-to-Reward?
Установите через pip: pip install text-to-reward и обратитесь к документации за инструкциями по настройке.
Какие среды поддерживаются?
По умолчанию он работает с OpenAI Gym, но может быть адаптирован для пользовательских симуляторов или реальных сред.
Какие модели он использует?
Для предсказания величины вознаграждения используются архитектуры на основе трансформаторов, точно настроенные на данных о человеческих предпочтениях.
Как подготовить данные для обучения?
Создайте набор данных пар "инструкция - вознаграждение" или "предпочтение" в формате, описанном в документации.
Доступны ли предварительно обученные модели?
В настоящее время официальные предварительно обученные модели не предоставляются; пользователи должны обучать модели на своих собственных данных.
Как я могу оценить выученную функцию вознаграждения?
Интегрируйте ее в RL-агент и сравните производительность с базовыми значениями, рассчитанными вручную.
Какие языки программирования поддерживаются?
Text-to-Reward В настоящее время проект доступен в виде библиотеки Python.
Могу ли я внести свой вклад в проект?
Да, вклад приветствуется через репозиторий GitHub; пожалуйста, следуйте рекомендациям по вкладу.
Какая лицензия распространяется на Text-to-Reward?
Проект выпускается под лицензией MIT.
Text-to-Reward Информация о компании
- Text-to-Reward Проект
- xlang-ai
- https://xlang.ai/
- @XLangNLP
- README.md
Text-to-Reward экрана

2026 год: лучшие и самые популярные редакторы с ИИ для удаления объектов на портретах, фотографиях путешествий и товарах! XIX.AI подбирает мощную коллекцию инструментов, которые кардинально меняют правила игры, и регулярно обновляет её, публикуя еженедельные рейтинги. Эти инструменты прошли реальные тесты, которые помогут вам быстро удалить ненужные элементы, повысить качество контента и сэкономить массу времени без ущерба для результатов. Обязательно попробуйте, если хотите раскрыть свой творческий потенциал с помощью ИИ. Откройте для себя эти инструменты прямо сейчас!
 10 инструментов
 xix.ai

2026 лучших и наиболее высокооцененных инструментов преобразования текста в речь на базе ИИ для онлайн-курсов отобраны компанией XIX.AI на основе тщательных практических тестов и еженедельно обновляемого рейтинга. Эти мощные инструменты помогают авторам без особых усилий создавать кристально чистый аудиоконтент, повышая эффективность написания текстов и оптимизируя процесс создания курсов. Ознакомьтесь со сравнением бесплатных и платных версий, чтобы найти вариант, идеально подходящий именно вам. Узнайте больше прямо сейчас, чтобы раскрыть потенциал ИИ в сфере онлайн-образования.
10 инструментов
xix.ai

2026 год: лучшие и самые популярные инструменты для создания заголовков блога на основе ИИ для повышения кликабельности! XIX.AI тщательно подобрал мощную коллекцию лучших инструментов, которые прошли строгие реальные тесты. Вы найдете сравнение бесплатных и платных вариантов, еженедельно обновляемые рейтинги и подробные аналитические данные, которые помогут вам эффективно увеличить трафик вашего блога. Обязательно попробуйте выделенные варианты, чтобы раскрыть ваше преимущество с помощью ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для распределения задач с помощью ИИ в рамках рабочих процессов службы поддержки! XIX.AI подготовила чрезвычайно мощную и революционную подборку решений, которые обязательно стоит попробовать — все они проходят тщательные тесты в реальных условиях и обновляются еженедельно. Эти инструменты оптимизируют рабочие процессы, повышают производительность и помогают командам обеспечивать более быструю и эффективную поддержку. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и раскрыть весь потенциал искусственного интеллекта!
17 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для цитирования и резюмирования научных статей на базе ИИ, отобранные XIX.AI. Получите мощные, революционные решения для быстрого создания контента, повышения эффективности написания текстов и роста продуктивности. Мы предлагаем сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемый рейтинг, чтобы помочь вам найти инструмент, который идеально соответствует вашим потребностям и который обязательно стоит попробовать. Откройте для себя эти инструменты прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ.
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты ИИ для повышения производительности в повседневной работе! XIX.AI подобрал мощный набор решений, способных кардинально изменить работу с помощью строгих еженедельных рейтингов и тестов в реальных условиях. Здесь представлены инструменты, которые обязательно стоит попробовать: они повышают эффективность написания текстов, упрощают создание контента и помогают преодолевать ежедневные рабочие задачи. Получите бесплатное сравнение версий с платными, чтобы найти оптимальный вариант для ваших потребностей. Ознакомьтесь сейчас и раскройте потенциал ИИ в своей работе!
9 инструментов
xix.ai


Интересный подход к обучению с подкреплением через текстовые описания! 🧠 Возможно, это поможет создать более 'осмысленных' ИИ-агентов, которые лучше понимают цели. Хотелось бы увидеть больше примеров применения в играх или робототехнике. Есть вопросы по настройке гиперпараметров модели.


