


 집
Text-to-Reward
텍스트 보상: RL 보상 모델을 위한 오픈 소스 프레임워크


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?
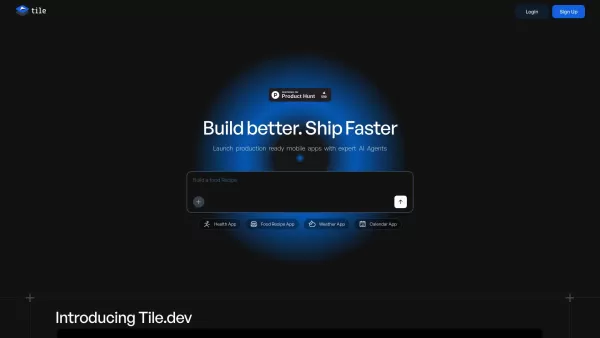
Tile?Tile 는 코딩 없이도 아이디어를 완전한 기능을 갖춘 iOS 및 Android 앱으로 변환하는 AI 기반 플랫폼으로 모바일 앱 개발에 혁신을 가져왔습니다. 이 혁신적인 솔루션은 인공 지능과 전문가 수준의 인프라를 결합하여 UI 디자인부터 사용자 인증 및 결제 처리와 같은 백엔드 서비스까지 모든 것을 자동화합니다. 비즈니스 소유자와 크리에이터는
RAGFlow 란 무엇인가요?RAGFlow RAGFlow 는 AI 에이전트의 생성 및 배포를 간소화하기 위해 설계된 오픈소스 RAG(Retrieval-Augmented Generation) 엔진입니다. 이 엔진은 지능형 문서 처리와 벡터 검색을 결합하여 PDF, 웹사이트, 데이터베이스의 비정형 데이터를 맞춤형 지식 기반으로 변환합니다. 개발자는 Python
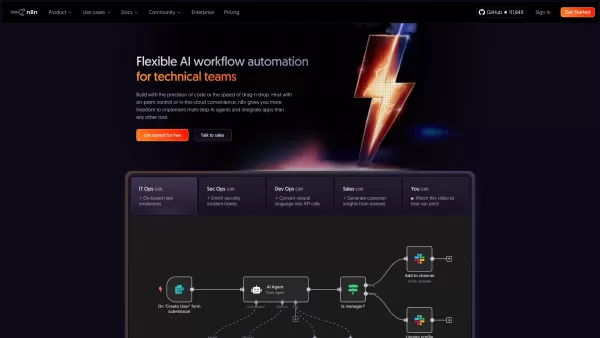
n8n란 무엇인가요? n8n AI와 프로세스 자동화를 결합한 강력한 워크플로 자동화 플랫폼입니다. 개발자에게 코드 제어권과 시각적 편집기의 간편함을 동시에 제공하여 정교한 AI 에이전트를 생성하고 500개 이상의 앱과 연결할 수 있도록 지원합니다. 최대의 제어권을 위해 자체 서버에 n8n를 배포하거나 사용 편의성을 위해 관리형 클라우드 서비스를 선택할 수
AI 챗봇 세계에 대해 호기심이 있다면 Google Gemini AI 챗봇을 소개해드리겠습니다. 단순한 챗봇이 아닙니다 — 강력한 Google Gemini 기술로 구동되며, 모든 대화 요구 사항을 충족하는 강력한 도구입니다.\n\nGoogle Gemini AI ChatBot 사용 방법\n-------------\n\n시작하기는 파이 먹기처럼 쉽습니다! 필요한 것은 단지 Google Gemini API 키입니다. 이를 얻으면 모든 기능을 완전히
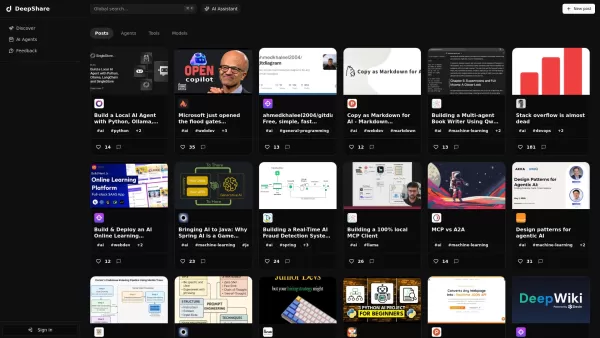
DeepShare 이란?DeepShare 는 크리에이터, 사상가, 학습자로 구성된 글로벌 커뮤니티를 한 지붕 아래 모을 수 있도록 설계된 야심차고 실험적인 플랫폼입니다. 단순한 콘텐츠 공유 사이트가 아니라 AI, 웹 개발, 머신 러닝, 최첨단 도구 및 모델과 같은 주제를 중심으로 사용자가 탐색하고, 만들고, 연결할 수 있는 심층적인 콘텐츠 통합 허브입니다
Text-to-Reward 제품 정보
Text-to-Reward 란 무엇인가요?
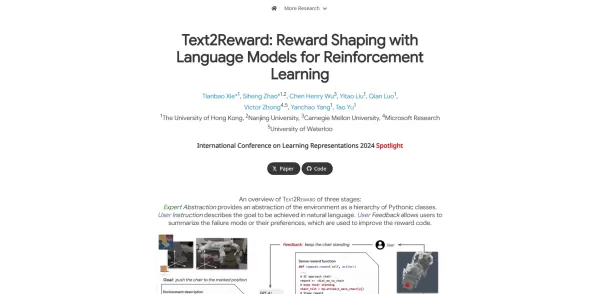
Text-to-Reward 는 텍스트 기반 작업 설명이나 피드백을 강화 학습 에이전트를 위한 스칼라 보상으로 변환하는 보상 모델 학습을 위한 완벽한 워크플로우를 제공합니다. 트랜스포머 기반 아키텍처를 활용하고 사람의 선호도 데이터 세트를 미세 조정함으로써 시스템은 자연어 지시를 보상 신호로 해석하는 방법을 자동으로 학습합니다. 사용자는 텍스트 프롬프트를 통해 모든 작업을 정의하고, 모델을 학습시키고, 결과 보상 함수를 모든 RL 알고리즘에 통합할 수 있습니다. 이를 통해 수동 보상 형성을 없애고 샘플 효율성을 개선하며 에이전트가 시뮬레이션 또는 실제 환경에서 복잡한 다단계 지시를 수행할 수 있습니다.
누가 Text-to-Reward 을 사용하나요?
- 강화 학습 연구자
- 머신 러닝 엔지니어
- 로보틱스 개발자
- AI 학생 및 학자
- 게임 AI 개발자
사용 방법 Text-to-Reward
- 1단계: pip를 사용하여 Text-to-Reward Python 패키지를 설치합니다.
- 2단계: 선호도 또는 보상 주석과 짝을 이루는 텍스트 지침이 포함된 데이터 세트를 준비합니다.
- 3단계: 포함된 트레이닝 스크립트를 사용하여 보상 모델을 구성하고 트레이닝합니다.
- 4단계: 훈련된 모델을 내보내고 RL 파이프라인(예: OpenAI Gym)에 통합합니다.
- 5단계: 학습된 보상 기능으로 RL 에이전트를 실행하고 성능을 평가합니다.
플랫폼
- macOS
- Windows
- Linux
Text-to-Reward 핵심 기능 및 이점
핵심 기능
- 자연어 조건부 보상 모델링
- 트랜스포머 기반 아키텍처
- 사람 선호도 데이터에 대한 학습
- OpenAI Gym과의 원활한 통합
- 모든 RL 알고리즘과 호환되는 내보내기 가능한 보상 기능
이점
- 수동 보상 엔지니어링의 필요성 제거
- 다양한 작업 및 환경에 맞게 확장 가능
- 해석 가능한 언어 기반 보상 신호 제공
- 샘플 효율성 향상
- 텍스트를 통해 사용자 정의 가능한 작업 정의 가능
주요 사용 사례 및 애플리케이션
- 텍스트 작업 설명을 사용한 로봇 제어
- 언어 기반 목표를 따르는 게임 플레이 에이전트
- 다양한 지침이 포함된 멀티태스크 강화 학습
- 정책 개선을 위한 휴먼 인 더 루프 피드백
- 언어 명령을 통한 시뮬레이션 환경 탐색
Text-to-Reward 장점 및 단점
장점
도메인 지식이나 데이터 없이도 고밀도 보상 함수 자동 생성
대규모 언어 모델을 사용하여 자연어 목표 해석
사람의 피드백을 통한 반복적인 개선 지원
벤치마크에서 전문가가 설계한 보상과 비슷하거나 그 이상의 성과 달성
시뮬레이션에서 학습된 정책을 실제 환경에 배포할 수 있습니다.
해석 가능한 자유 형식의 보상 코드 생성
Text-to-Reward FAQ
Text-to-Reward 이란 무엇인가요?
Text-to-Reward 는 강화 학습 에이전트를 위한 자연어 지침으로 보상 모델을 훈련하는 프레임워크입니다.
Text-to-Reward?는 어떻게 설치하나요?
pip를 통해 설치: pip 설치 text-to-reward 설정 지침은 설명서를 참조하세요.
어떤 환경이 지원되나요?
기본적으로 OpenAI Gym에서 작동하며 사용자 지정 시뮬레이션 또는 실제 환경에 맞게 조정할 수 있습니다.
어떤 모델을 사용하나요?
인간의 선호도 데이터에 따라 미세 조정된 트랜스포머 기반 아키텍처를 사용하여 보상 값을 예측합니다.
훈련 데이터는 어떻게 준비하나요?
설명서에 설명된 대로 형식이 지정된 명령-보상 또는 선호도 쌍의 데이터 세트를 생성합니다.
사전 학습된 모델을 사용할 수 있나요?
현재 공식적으로 사전 학습된 모델은 제공되지 않으며, 사용자는 자신의 데이터로 모델을 학습시켜야 합니다.
학습된 보상 함수를 평가하려면 어떻게 해야 하나요?
RL 에이전트에 통합하여 수동으로 설계한 기준선과 성능을 비교합니다.
어떤 프로그래밍 언어가 지원되나요?
Text-to-Reward 현재 Python 라이브러리로 제공됩니다.
프로젝트에 기여할 수 있나요?
예. GitHub 리포지토리를 통해 기여하실 수 있으며, 기여 가이드라인을 따르세요.
Text-to-Reward 에는 어떤 라이선스가 적용되나요?
이 프로젝트는 MIT 라이선스에 따라 릴리스됩니다.
Text-to-Reward 회사 정보
- Text-to-Reward 프로젝트
- xlang-ai
- https://xlang.ai/
- @XLangNLP
- README.md
Text-to-Reward 스크린 샷


2026년 최신 최고 평점을 받은 AI 물체 제거 편집기: 인물 사진, 여행 사진, 제품 사진에 최적! XIX.AI는 매주 랭킹을 업데이트하며, 판도를 바꿀 만큼 강력한 도구들을 엄선해 제공합니다. 이 도구들은 실제 테스트를 통해 원치 않는 요소를 빠르게 제거하고, 콘텐츠 품질을 높이며, 결과물의 품질을 떨어뜨리지 않으면서도 시간을 대폭 절약할 수 있도록 도와줍니다. AI 창작의 경쟁력을 한 단계 높이고 싶은 분이라면 꼭 사용해 보세요. 지금 바로 확인해 보세요!
 10 도구
 xix.ai

2026년 온라인 강좌용 최신 최고 평점 AI 텍스트 음성 변환 도구는 XIX.AI가 엄격한 실전 테스트와 매주 업데이트되는 순위를 바탕으로 엄선한 것입니다. 이 강력한 도구들은 콘텐츠 제작자가 손쉽게 선명한 오디오 콘텐츠를 제공할 수 있도록 도와주어, 글쓰기 효율을 높이고 강좌 제작 과정을 간소화합니다. 무료 버전과 유료 버전의 비교 정보를 확인하여 본인에게 가장 적합한 도구를 찾아보세요. 지금 바로 살펴보고 온라인 교육 분야에서 AI를 활용한 경쟁력을 확보하세요.
10 도구
xix.ai

2026년 최신 최고의 상위 평가 AI 블로그 제목 도구로 클릭률 높이기! XIX.AI는 엄격한 실제 테스트를 거친 강력한 게임 체인저 모음의 상위 도구를 신중하게 선별했습니다. 무료 대 유료 비교, 매주 업데이트되는 순위, 블로그 트래픽을 효율적으로 증대하는 데 도움이 되는 상세한 통찰력을 찾을 수 있습니다. AI 경쟁력을 unlocking하는 데 도움이 되는 필수 옵션이 강조되어 있습니다. 지금 탐색하세요!
10 도구
xix.ai

2026년 지원 워크플로우를 위한 최신 최고 평점의 AI 업무 배정 도구! XIX.AI는 반드시 사용해 봐야 할, 매우 강력하고 판도를 바꿀 만한 솔루션들을 엄선하여 소개합니다. 이 모든 솔루션은 엄격한 실전 테스트를 거쳤으며 매주 업데이트됩니다. 이 도구들은 워크플로우를 간소화하고 생산성을 높여, 팀이 더 빠르고 효율적인 지원을 제공할 수 있도록 돕습니다. 지금 바로 살펴보고 귀사에 딱 맞는 도구를 찾아 AI의 경쟁력을 극대화해 보세요!
17 도구
xix.ai

XIX.AI가 엄선한 2026년 최신 최고 평점의 AI 인용 및 논문 요약 도구. 빠른 콘텐츠 제작, 글쓰기 효율 향상, 생산성 증대를 위한 획기적인 솔루션을 만나보세요. 무료 버전과 유료 버전의 비교 정보, 실제 테스트 결과, 매주 업데이트되는 순위 정보를 제공하여 여러분의 필요에 완벽하게 맞는, 꼭 사용해 봐야 할 도구를 찾으실 수 있도록 도와드립니다. 지금 바로 탐색하여 AI를 통한 경쟁 우위를 확보하세요.
10 도구
xix.ai

2026년, 일상 업무에 최적화된 최신의 우수한 인기 AI 생산성 도구들! XIX.AI는 매주 업데이트되는 철저한 순위 체계와 실제 사용 테스트를 바탕으로 획기적인 성능을 자랑하는 도구들을 엄선했습니다. 글쓰기 효율성을 높이고 콘텐츠 제작 과정을 간소화하며, 일상 업무에서 마주하는 다양한 과제를 극복하는 데 도움을 주는 필수 도구들을 만나보실 수 있습니다. 자신의 니즈에 가장 적합한 도구를 찾기 위해 무료 버전과 유료 버전의 비교 정보도 제공됩니다. 지금 바로 확인하여 AI를 활용한 경쟁 우위를 확보해 보세요!
9 도구
xix.ai


Интересный подход к обучению с подкреплением через текстовые описания! 🧠 Возможно, это поможет создать более 'осмысленных' ИИ-агентов, которые лучше понимают цели. Хотелось бы увидеть больше примеров применения в играх или робототехнике. Есть вопросы по настройке гиперпараметров модели.


