


 家
Text-to-Reward
テキストから報酬へ:RL報酬モデルのオープンソース・フレームワーク


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?
Tile とは?Tile は、コーディングなしでアイデアを完全に機能するiOSおよびAndroidアプリに変換するAI駆動型プラットフォームにより、モバイルアプリ開発に革命をもたらします。この革新的なソリューションは、人工知能とプロフェッショナルグレードのインフラストラクチャを組み合わせ、UIデザインからユーザー認証や支払い処理などのバックエンドサービスまで、すべてを自動化します。ビジネスオー
RAGFlow とは?RAGFlow RAGFlow とは、AIエージェントの作成と展開を簡素化するために設計されたオープンソースのRAG(Retrieval-Augmented Generation)エンジンです。インテリジェントな文書処理とベクトル検索を融合させ、PDF、ウェブサイト、データベースからの非構造化データをカスタムナレッジベースに変換します。 開発者は、Python SDKまたはR
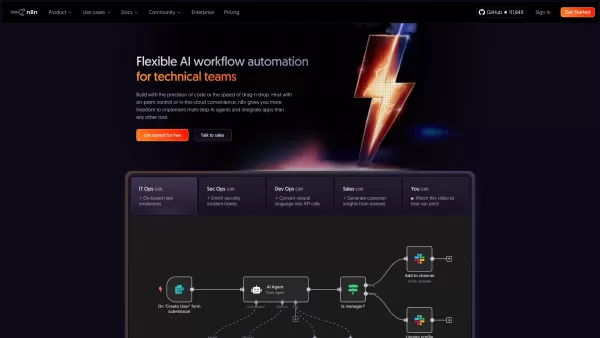
n8nとは何ですか? n8n AIとプロセス自動化を融合した強力なワークフロー自動化プラットフォームです。開発者はコード制御とビジュアルエディターの簡便性を両立させ、高度なAIエージェントの作成や500以上のアプリ連携を実現できます。最大級の制御を求める場合は自社サーバーにn8nをデプロイ可能、あるいは使いやすさを重視するならマネージドクラウドサービスを選択できます。n8n の使用方法 ワークフロ
AIチャットボットに興味があるなら、Google Gemini AIチャットボットをご紹介しましょう。これはただのチャットボットではありません——強力なGoogle Geminiテクノロジーによって駆動されており、すべての対話ニーズに対応するパワフルなツールです。\n\nGoogle Gemini AI ChatBotの使い方\n-------------\n\n始め方は手軽です!必要なのはGoogle Gemini APIキーだけです。それを取得したら、隠れた費用もなく完全無料でチャットボット
DeepShare とは?DeepShare は、クリエイター、思想家、学習者のグローバル・コミュニティをひとつ屋根の下に集めるために設計された、野心的で実験的なプラットフォームです。単なるコンテンツ共有サイトではなく、ユーザーがAI、ウェブ開発、機械学習、最先端のツールやモデルなどのトピックを探求し、創造し、つながることができる深いコンテンツ集約ハブです。アイデアが衝突し、知識が増殖し、イノベ
Text-to-Reward製品情報
Text-to-Reward とは?
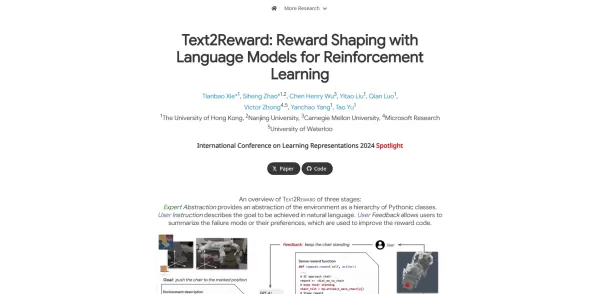
Text-to-Reward は、テキストベースのタスク記述やフィードバックを強化学習エージェントのスカラー報酬に変換する報酬モデルをトレーニングするための完全なワークフローを提供します。変換器ベースのアーキテクチャを活用し、人間の嗜好データセットで微調整することで、システムは自動的に自然言語の指示を報酬信号として解釈することを学習する。ユーザは、テキストプロンプトを通じて任意のタスクを定義し、モデルを訓練し、得られた報酬関数を任意のRLアルゴリズムに統合することができる。これにより、手動による報酬のシェーピングが不要になり、サンプルの効率が向上し、エージェントがシミュレーションや実環境で複雑なマルチステップの指示を実行できるようになります。
Text-to-Reward 。
- 強化学習の研究者
- 機械学習エンジニア
- ロボット開発者
- AIの学生や学者
- ゲームAI開発者
使用方法Text-to-Reward
- ステップ1:pipを使ってText-to-Reward Pythonパッケージをインストールする。
- ステップ2:嗜好または報酬の注釈とペアになったテキスト指示を含むデータセットを準備する。
- ステップ3:同梱のトレーニングスクリプトを使用して、報酬モデルを設定し、トレーニングします。
- ステップ4:学習済みモデルをエクスポートし、RLパイプライン(OpenAI Gymなど)に組み込みます。
- ステップ5:学習した報酬関数でRLエージェントを実行し、そのパフォーマンスを評価します。
プラットフォーム
- macOS
- Windows
- Linux
Text-to-Reward コア機能と利点
コア機能
- 自然言語による報酬モデリング
- 変換器ベースのアーキテクチャ
- 人間の嗜好データを用いたトレーニング
- OpenAI Gymとのシームレスな統合
- あらゆるRLアルゴリズムと互換性のあるエクスポート可能な報酬関数
利点
- 手動による報酬エンジニアリングの必要性を排除
- 多様なタスクや環境に対応
- 解釈可能な言語主導の報酬シグナルを提供
- サンプル効率を向上
- テキストによるタスク定義のカスタマイズが可能
主な使用例とアプリケーション
- テキストによるタスク記述を用いたロボット制御
- 言語ベースの目標に従うゲームプレイエージェント
- 多様な指示によるマルチタスク強化学習
- ポリシー改善のためのヒューマンインザループフィードバック
- 言語コマンドによる模擬環境ナビゲーション
Text-to-Reward 長所と短所
長所
ドメインの知識やデータを必要とせず、自動的に高密度の報酬関数を生成
自然言語の目標を解釈するために大規模な言語モデルを使用
人間のフィードバックによる反復的な改良をサポート
ベンチマークで専門家が設計した報酬に匹敵するか、それを上回るパフォーマンスを達成
シミュレーションで学習したポリシーを実環境に展開可能
解釈可能な自由形式の報酬コードを生成します。
Text-to-Reward よくある質問
Text-to-Reward とは何ですか?
Text-to-Reward は、強化学習エージェントのための自然言語命令から報酬モデルを学習するフレームワークです。
Text-to-Reward のインストール方法は?
pip installtext-to-reward 。セットアップ方法についてはドキュメントを参照してください。
どの環境がサポートされていますか?
デフォルトではOpenAI Gymで動作し、カスタムのシミュレーション環境や実環境に適応させることができます。
どのようなモデルを使いますか?
報酬値を予測するために、人間の嗜好データに基づいて微調整された変換器ベースのアーキテクチャを採用しています。
トレーニングデータはどのように準備するのですか?
説明書に記載されているように、指示と報酬または嗜好のペアのデータセットを作成してください。
トレーニング済みのモデルはありますか?
現在のところ、公式な事前学習済みモデルは提供されていません。ユーザは自分のデータでモデルを学習する必要があります。
学習した報酬関数はどのように評価できますか?
RLエージェントに組み込んで、手動で設計したベースラインと性能を比較してください。
サポートされているプログラミング言語は?
Text-to-Reward 現在、Pythonライブラリとして提供されています。
プロジェクトに貢献できますか?
はい、GitHubのリポジトリを通して貢献することができます。
Text-to-Reward をカバーするライセンスは何ですか?
このプロジェクトはMITライセンスの下でリリースされています。
Text-to-Reward 会社情報
- Text-to-Reward プロジェクト
- xlang-ai
- https://xlang.ai/
- XLangNLP
- README.md
Text-to-Rewardスクリーンショット



2026年最新・最高評価のAIオブジェクト除去エディター(ポートレート・旅行・商品写真向け)!XIX.AIは、毎週更新されるランキングとともに、業界に革命をもたらす強力なツール群を厳選して紹介しています。これらのツールは実環境でのテストを経ており、画質を損なうことなく、不要な要素を素早く除去し、コンテンツの品質を向上させ、大幅な時間の節約を実現します。 AIを活用したクリエイティブの可能性を最大限に引き出したい方なら、ぜひ試してみてください。今すぐチェック!
 10 ツール
 xix.ai

2026年最新のオンライン講座向け高評価AIテキスト読み上げツールは、XIX.AIが厳格な実地テストに基づき厳選し、毎週ランキングを更新しています。これらの強力なツールを使えば、クリエイターは手間をかけずに明瞭な音声コンテンツを作成でき、執筆効率の向上や講座制作の効率化につながります。無料版と有料版の比較を確認して、ご自身にぴったりのツールを見つけてください。 今すぐチェックして、オンライン教育におけるAIの優位性を手に入れましょう。
10 ツール
xix.ai

2026年最新版・高CTRを実現するベストなAIブログタイトルツールのトップ評価一覧!XIX.AIは、厳格な実世界テストを通過した強力かつ画期的なトップツールコレクションを慎重に厳選しました。無料版と有料版の比較、週次更新のランキング、ブログのトラフィックを効率的に向上させるための詳細なインサイトが見つかります。AIでの優位性を引き出すために、特に試すべきオプションが強調表示されています。今すぐ探索しましょう!
10 ツール
xix.ai

2026年最新・最高評価のサポートワークフロー向けAIタスクルーティングツール!XIX.AIは、試してみるべき、極めて強力で業界に革新をもたらすソリューションを厳選しました。これらはすべて、実環境での厳格なテストを経ており、毎週更新されています。これらのツールはワークフローを効率化し、生産性を向上させ、チームがより迅速かつ効率的なサポートを提供できるよう支援します。 今すぐチェックして、あなたにぴったりのツールを見つけ、AIの力を最大限に引き出しましょう!
17 ツール
xix.ai

2026年最新・最高評価のAI引用・論文要約ツール。XIX.AIが厳選しました。コンテンツの迅速な作成、執筆効率の向上、生産性の向上を実現する、画期的なソリューションを手に入れましょう。無料版と有料版の比較、実地テスト、毎週更新されるランキングを通じて、あなたのニーズにぴったりの「ぜひ試すべき」ツールを見つけるお手伝いをします。 今すぐチェックして、AIの力を最大限に活用しましょう。
10 ツール
xix.ai

2026年、日常業務に最適な最新かつ最高評価のAI生産性ツールまとめ!XIX.AIは、厳格な週次ランキングの更新や実際の使用テストをもとに、画期的で強力なツール群を厳選しました。執筆効率を向上させ、コンテンツ作成の工程を簡素化し、日々の業務上の課題を克服するのに役立つツールが揃っています。無料版と有料版の比較情報もご用意しているので、ご自身のニーズに最も合ったものを見つけてみましょう。今すぐチェックして、AIの力でビジネスをより一層強化しましょう!
9 ツール
xix.ai


Интересный подход к обучению с подкреплением через текстовые описания! 🧠 Возможно, это поможет создать более 'осмысленных' ИИ-агентов, которые лучше понимают цели. Хотелось бы увидеть больше примеров применения в играх или робототехнике. Есть вопросы по настройке гиперпараметров модели.


