


 Hogar
Text-to-Reward
Text-to-Reward: Marco de código abierto para modelos de recompensa de RL


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?
¿Qué es Tile?Tile revoluciona el desarrollo de aplicaciones móviles con su plataforma basada en IA que transforma ideas en aplicaciones iOS y Android totalmente funcionales sin necesidad de programa
¿Qué es « RAGFlow »?RAGFlow Es un motor RAG (Retrieval-Augmented Generation) de código abierto diseñado para simplificar la creación y la implementación de agentes de IA. Combina el procesamiento inte
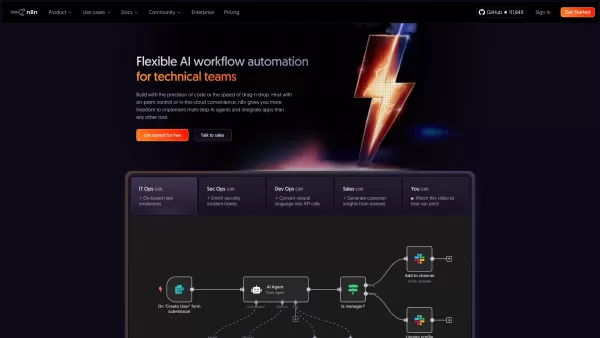
¿Qué es n8n? n8n Es una potente plataforma de automatización de flujos de trabajo que combina la inteligencia artificial con la automatización de procesos. Ofrece a los desarrolladores el control del
¿Qué es DeepShare?DeepShare es una ambiciosa plataforma experimental diseñada para reunir a una comunidad global de creadores, pensadores y estudiantes bajo un mismo techo. No es un sitio más para co
Si tienes curiosidad por adentrarte en el mundo de los chatbots de IA, déjame presentarte al ChatBot gratuito Google Gemini AI. ¡Este no es cualquier chatbot! Está impulsado por la robusta tecnología Google Gemini, convirtiéndolo en una potencia para
Text-to-Reward Información del producto
¿Qué es Text-to-Reward?
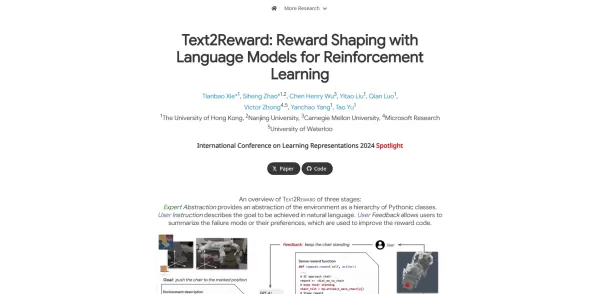
Text-to-Reward ofrece un flujo de trabajo completo para entrenar modelos de recompensa que traducen descripciones de tareas basadas en texto o comentarios en recompensas escalares para agentes de aprendizaje por refuerzo. Aprovechando las arquitecturas basadas en transformadores y el ajuste fino sobre conjuntos de datos de preferencias humanas, el sistema aprende automáticamente a interpretar las instrucciones en lenguaje natural como señales de recompensa. Los usuarios pueden definir cualquier tarea mediante instrucciones de texto, entrenar el modelo e integrar la función de recompensa resultante en cualquier algoritmo de RL. Esto elimina el modelado manual de recompensas, mejora la eficacia de las muestras y permite a los agentes ejecutar instrucciones complejas de varios pasos en entornos simulados o reales.
¿Quién utiliza Text-to-Reward?
- Investigadores en aprendizaje por refuerzo
- Ingenieros de aprendizaje automático
- Desarrolladores de robótica
- Estudiantes y académicos de IA
- Desarrolladores de IA para juegos
Cómo utilizarlo Text-to-Reward
- Paso 1: Instale el paquete Python Text-to-Reward con pip.
- Paso 2: Preparar un conjunto de datos que contenga instrucciones de texto emparejadas con anotaciones de preferencia o recompensa.
- Paso 3: Configurar y entrenar el modelo de recompensa utilizando los scripts de entrenamiento incluidos.
- Paso 4: Exporte el modelo entrenado e incorpórelo a su pipeline de RL (como OpenAI Gym).
- Paso 5: Ejecute su agente RL con la función de recompensa aprendida y evalúe su rendimiento.
Plataforma
- macOS
- Windows
- Linux
Text-to-Reward Características principales y ventajas
Características principales
- Modelado de recompensas condicionado por el lenguaje natural
- Arquitectura basada en transformadores
- Entrenamiento con datos de preferencias humanas
- Perfecta integración con OpenAI Gym
- Funciones de recompensa exportables compatibles con cualquier algoritmo de RL
Ventajas
- Elimina la necesidad de ingeniería manual de recompensas
- Se adapta a diversas tareas y entornos
- Proporciona señales de recompensa interpretables basadas en el lenguaje
- Mejora la eficacia de las muestras
- Permite personalizar las definiciones de tareas mediante texto
Principales casos de uso y aplicaciones
- Control robótico mediante descripciones textuales de tareas
- Agentes de juego que siguen objetivos basados en el lenguaje
- Aprendizaje por refuerzo multitarea con instrucciones variadas
- Retroalimentación humana para la mejora de políticas
- Navegación por entornos simulados mediante comandos lingüísticos
Text-to-Reward Pros y contras
Pros
Genera automáticamente funciones de recompensa densas sin necesidad de conocimientos o datos del dominio.
Utiliza grandes modelos lingüísticos para interpretar objetivos en lenguaje natural
Admite el perfeccionamiento iterativo con retroalimentación humana
Alcanza un rendimiento comparable o superior al de las recompensas diseñadas por expertos en pruebas de referencia.
Permite implantar en el mundo real políticas entrenadas en simulación.
Genera un código de recompensas interpretable y de forma libre.
Text-to-Reward Preguntas frecuentes
¿Qué es Text-to-Reward?
Text-to-Reward es un marco que entrena modelos de recompensa a partir de instrucciones en lenguaje natural para agentes de aprendizaje por refuerzo.
¿Cómo se instala Text-to-Reward?
Instálelo mediante pip: pip install text-to-reward y consulte la documentación para obtener instrucciones de instalación.
¿Qué entornos son compatibles?
Funciona con OpenAI Gym por defecto y puede adaptarse a entornos simulados personalizados o del mundo real.
¿Qué modelos utiliza?
Utiliza arquitecturas basadas en transformadores y ajustadas a los datos de preferencias humanas para predecir los valores de recompensa.
¿Cómo se preparan los datos de entrenamiento?
Cree un conjunto de datos de pares de instrucciones-recompensas o preferencias con el formato descrito en la documentación.
¿Existen modelos preentrenados?
En la actualidad, no se proporcionan modelos preentrenados oficiales; los usuarios deben entrenar los modelos con sus propios datos.
¿Cómo puedo evaluar la función de recompensa aprendida?
Integrándola en un agente RL y comparando su rendimiento con líneas de base diseñadas manualmente.
¿Qué lenguajes de programación son compatibles?
Text-to-Reward está disponible actualmente como biblioteca de Python.
¿Puedo contribuir al proyecto?
Sí, las contribuciones son bienvenidas a través del repositorio GitHub; por favor, siga las directrices de contribución.
¿Qué licencia cubre Text-to-Reward?
El proyecto está publicado bajo la Licencia MIT.
Text-to-Reward Información de la empresa
- Text-to-Reward Proyecto
- xlang-ai
- https://xlang.ai/
- @XLangNLP
- LÉEME.md
Text-to-Reward captura de pantalla



¡Las mejores herramientas de 2026 de conversión de texto a voz con IA, con las mejores valoraciones para locuciones naturales, ya están aquí, en XIX.AI! Esta lista seleccionada incluye opciones potentes y revolucionarias que ofrecen voces nítidas para cualquier caso de uso, respaldadas por pruebas en el mundo real y clasificaciones que se actualizan semanalmente. Consigue una comparación entre las versiones gratuitas y de pago para encontrar la solución imprescindible que impulse tu productividad al instante. ¡Explora ahora y descubre tu ventaja con la IA!
 11 herramientas
 xix.ai

¡Los mejores generadores de fondos de manga con IA de 2026, clasificados según las valoraciones más altas! Esta selección presenta potentes herramientas revolucionarias, perfectas para crear fondos de capítulos, portadas de libros e ilustraciones promocionales de alta calidad. Todas las opciones han sido sometidas a rigurosas pruebas en condiciones reales para garantizar su fiabilidad. Consigue una comparación entre las versiones gratuitas y de pago, junto con información detallada. Explora ahora mismo para descubrir tu herramienta perfecta y sacar el máximo partido a la IA en la creación de manga.
6 herramientas
xix.ai

¡Los mejores editores de IA para la eliminación de objetos de 2026, mejor valorados para retratos, fotos de viajes y de productos! XIX.AI selecciona una potente colección revolucionaria que se actualiza periódicamente con clasificaciones semanales. Estas herramientas ofrecen pruebas en situaciones reales para ayudarte a eliminar rápidamente elementos no deseados, mejorar la calidad del contenido y ahorrar muchísimo tiempo sin comprometer los resultados. Imprescindible para cualquiera que quiera sacar el máximo partido a la IA en sus creaciones. ¡Explóralas ahora!
10 herramientas
xix.ai

Las mejores herramientas de conversión de texto a voz con IA para cursos en línea de 2026 han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas ayudan a los creadores a ofrecer contenidos de audio de una claridad cristalina sin esfuerzo, lo que aumenta la eficiencia a la hora de redactar y agiliza la producción de los cursos. Echa un vistazo a la comparación entre las opciones gratuitas y las de pago para encontrar la que mejor se adapte a tus necesidades. Explora ahora mismo y descubre las ventajas que te ofrece la IA en la educación en línea.
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Títulos para Blogs de IA Mejor Valoradas para Mayores Tasas de Clics. XIX.AI ha seleccionado cuidadosamente una poderosa y revolucionaria colección de las mejores herramientas que han pasado rigurosas pruebas en el mundo real. Encontrarás una comparación entre versiones gratuitas y de pago, clasificaciones actualizadas semanalmente e información detallada para ayudarte a aumentar el tráfico de tu blog de manera eficiente. Las opciones más recomendadas están destacadas para ayudarte a desbloquear tu ventaja con IA. ¡Explóralas ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de distribución de tareas con IA mejor valoradas de 2026 para flujos de trabajo de asistencia técnica! XIX.AI ha seleccionado una colección revolucionaria y muy potente de soluciones que no te puedes perder, todas ellas sometidas a rigurosas pruebas en condiciones reales y actualizadas semanalmente. Estas herramientas agilizan los flujos de trabajo, aumentan la productividad y ayudan a los equipos a ofrecer una asistencia más rápida y eficiente. ¡Explora ahora mismo para descubrir tu herramienta perfecta y sacar el máximo partido a la IA!
17 herramientas
xix.ai


Интересный подход к обучению с подкреплением через текстовые описания! 🧠 Возможно, это поможет создать более 'осмысленных' ИИ-агентов, которые лучше понимают цели. Хотелось бы увидеть больше примеров применения в играх или робототехнике. Есть вопросы по настройке гиперпараметров модели.


