


 Lar
Text-to-Reward
Text-to-Reward: Estrutura de código aberto para modelos de recompensa de RL


Helps TikTok sellers, brands, MCNs, and TAPs discover winning products and find creators.
HelpLook is an AI-powered all-in-one knowledge base tool that helps businesses quickly build knowledge bases, help centers, and...
Your AI Workspace
302.AI is an enterprise-grade AI resource platform with pay-as-you-go pricing, API access to a full range of AI models, and ready-to-use online applications.

剧火AI — AI Screenwriter + Director, a One-Person Short Drama Studio In one sentence, what is it?
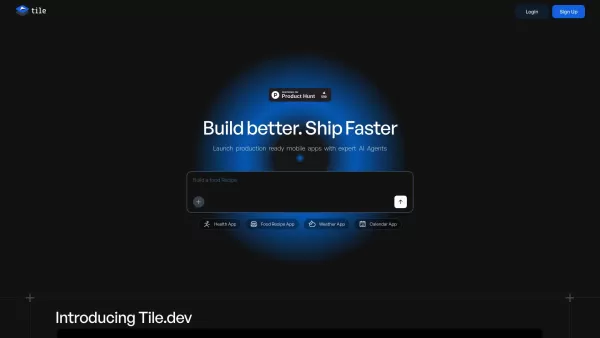
O que é Tile?Tile A revoluciona o desenvolvimento de aplicativos móveis com sua plataforma orientada por IA que transforma ideias em aplicativos iOS e Android totalmente funcionais sem codificação.
O que é o RAGFlow?RAGFlow é um mecanismo RAG (Retrieval-Augmented Generation) de código aberto projetado para simplificar a criação e a implantação de agentes de IA. Ele combina o processamento inteli
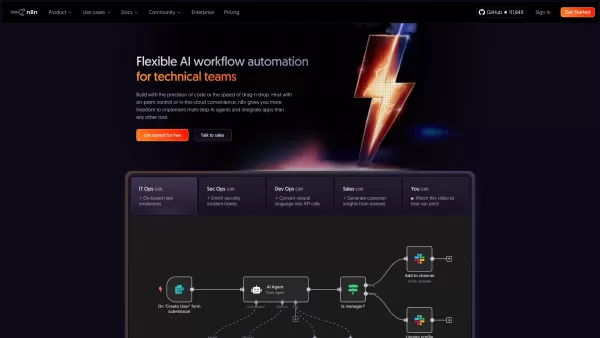
O que é o n8n? n8n É uma poderosa plataforma de automação de fluxo de trabalho que combina IA com automação de processos. Ela oferece aos desenvolvedores o controle do código, juntamente com a simplic
Se você está curioso para mergulhar no mundo dos chatbots de IA, deixe-me apresentar-lhe o ChatBot gratuito Google Gemini AI. Este não é apenas qualquer chatbot – é alimentado pela robusta tecnologia Google Gemini, tornando-o uma força poderosa para
O que é DeepShare?DeepShare O é uma plataforma ambiciosa e experimental projetada para reunir uma comunidade global de criadores, pensadores e alunos sob o mesmo teto. Não é apenas mais um site de c
Informações sobre o produto
O que é Text-to-Reward?
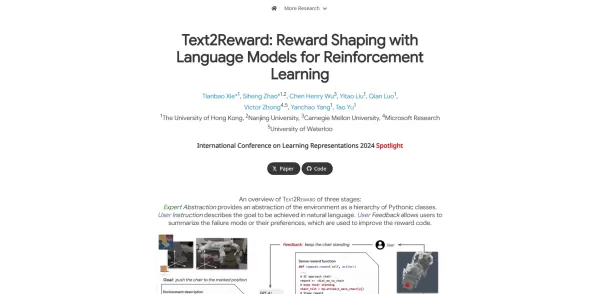
Text-to-Reward oferece um fluxo de trabalho completo para o treinamento de modelos de recompensa que traduzem descrições de tarefas baseadas em texto ou feedback em recompensas escalonadas para agentes de aprendizagem por reforço. Aproveitando as arquiteturas baseadas em transformadores e o ajuste fino em conjuntos de dados de preferências humanas, o sistema aprende automaticamente a interpretar instruções de linguagem natural como sinais de recompensa. Os usuários podem definir qualquer tarefa por meio de prompts de texto, treinar o modelo e integrar a função de recompensa resultante em qualquer algoritmo de RL. Isso elimina a modelagem manual de recompensas, melhora a eficiência da amostra e permite que os agentes executem instruções complexas de várias etapas em ambientes simulados ou reais.
Quem usa o Text-to-Reward?
- Pesquisadores de aprendizagem por reforço
- Engenheiros de aprendizado de máquina
- Desenvolvedores de robótica
- Estudantes e acadêmicos de IA
- Desenvolvedores de IA para jogos
Como usar Text-to-Reward
- Etapa 1: Instale o pacote Python Text-to-Reward usando pip.
- Etapa 2: prepare um conjunto de dados contendo instruções de texto emparelhadas com anotações de preferências ou recompensas.
- Etapa 3: Configure e treine o modelo de recompensa usando os scripts de treinamento incluídos.
- Etapa 4: exporte o modelo treinado e incorpore-o em seu pipeline de RL (como o OpenAI Gym).
- Etapa 5: execute seu agente de RL com a função de recompensa aprendida e avalie seu desempenho.
Plataforma
- macOS
- Windows
- Linux
Text-to-Reward Principais recursos e benefícios
Recursos principais
- Modelagem de recompensa condicionada por linguagem natural
- Arquitetura baseada em transformadores
- Treinamento em dados de preferências humanas
- Integração perfeita com o OpenAI Gym
- Funções de recompensa exportáveis compatíveis com qualquer algoritmo de RL
Benefícios
- Elimina a necessidade de engenharia manual de recompensas
- Adapta-se a diversas tarefas e ambientes
- Fornece sinais de recompensa interpretáveis e orientados por linguagem
- Aumenta a eficiência da amostra
- Permite definições de tarefas personalizáveis por meio de texto
Principais casos de uso e aplicativos
- Controle robótico usando descrições textuais de tarefas
- Agentes de jogos que seguem metas baseadas em linguagem
- Aprendizagem por reforço de várias tarefas com instruções variadas
- Feedback humano no circuito para aprimoramento de políticas
- Navegação em ambiente simulado por meio de comandos de linguagem
Text-to-Reward Prós e contras
Prós
Gera automaticamente funções de recompensa densas sem exigir conhecimento ou dados de domínio
Usa grandes modelos de linguagem para interpretar metas de linguagem natural
Oferece suporte ao refinamento iterativo com feedback humano
Obtém desempenho comparável ou superior às recompensas projetadas por especialistas em benchmarks
Permite a implementação de políticas treinadas em simulação para configurações do mundo real
Gera código de recompensa interpretável e de forma livre
Text-to-Reward Perguntas frequentes
O que é Text-to-Reward?
Text-to-Reward O é uma estrutura que treina modelos de recompensa a partir de instruções de linguagem natural para agentes de aprendizagem por reforço.
Como faço para instalar o Text-to-Reward?
Instale via pip: pip install text-to-reward e consulte a documentação para obter instruções de configuração.
Quais ambientes são compatíveis?
Ele funciona com o OpenAI Gym por padrão e pode ser adaptado para ambientes personalizados simulados ou do mundo real.
Quais modelos ele usa?
Ele emprega arquiteturas baseadas em transformadores ajustadas com base em dados de preferências humanas para prever valores de recompensa.
Como preparo os dados de treinamento?
Crie um conjunto de dados de pares de instrução-recompensa ou preferência formatados conforme descrito na documentação.
Há modelos pré-treinados disponíveis?
Atualmente, não são fornecidos modelos oficiais pré-treinados; os usuários devem treinar modelos com seus próprios dados.
Como posso avaliar a função de recompensa aprendida?
Integre-a em um agente de RL e compare o desempenho com linhas de base projetadas manualmente.
Quais linguagens de programação são compatíveis?
Text-to-Reward O projeto está atualmente disponível como uma biblioteca Python.
Posso contribuir com o projeto?
Sim, as contribuições são bem-vindas por meio do repositório do GitHub; siga as diretrizes de contribuição.
Qual licença abrange o Text-to-Reward?
O projeto é lançado sob a licença MIT.
Text-to-Reward Informações sobre a empresa
- Text-to-Reward Projeto
- xlang-ai
- https://xlang.ai/
- @XLangNLP
- README.md
Screenshot Text-to-Reward



Os melhores e mais bem avaliados editores de remoção de objetos com IA de 2026 para retratos, fotos de viagem e fotos de produtos! O XIX.AI seleciona uma coleção poderosa e revolucionária, atualizada regularmente com rankings semanais. Essas ferramentas oferecem testes práticos para ajudar você a remover rapidamente elementos indesejados, melhorar a qualidade do conteúdo e economizar muito tempo sem comprometer os resultados. Imperdível para quem quer explorar todo o potencial da IA na criação. Explore agora!
 10 ferramentas
 xix.ai

As melhores e mais bem avaliadas ferramentas de conversão de texto em fala com IA para cursos on-line de 2026 foram selecionadas pela XIX.AI com base em testes rigorosos no mundo real e em rankings atualizados semanalmente. Essas ferramentas poderosas ajudam os criadores a produzir conteúdo de áudio com som cristalino sem esforço, aumentando a eficiência na redação e agilizando a produção de cursos. Confira a comparação entre as versões gratuitas e pagas para encontrar a opção ideal para você. Explore agora para aproveitar a vantagem da IA na educação online.
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Títulos para Blogs de IA Mais Bem Avaliadas para Maiores Taxas de Clique! A XIX.AI cuidadosamente selecionou uma coleção poderosa e transformadora das melhores ferramentas que passam por rigorosos testes no mundo real. Você encontrará uma comparação entre gratuito e pago, rankings atualizados semanalmente e insights detalhados para ajudá-lo a aumentar o tráfego do seu blog de forma eficiente. As opções imperdíveis estão destacadas para ajudá-lo a desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de roteamento de tarefas com IA para fluxos de trabalho de suporte em 2026! A XIX.AI selecionou um conjunto extremamente poderoso e revolucionário de soluções imperdíveis, todas submetidas a rigorosos testes em condições reais e atualizadas semanalmente. Essas ferramentas otimizam os fluxos de trabalho, aumentam a produtividade e ajudam as equipes a oferecer um suporte mais rápido e eficiente. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo as vantagens da IA!
17 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de 2026 para citações e resumos de artigos com IA, selecionadas pela XIX.AI. Obtenha soluções poderosas e revolucionárias para a criação rápida de conteúdo, maior eficiência na redação e aumento da produtividade. Oferecemos uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente, para ajudá-lo a encontrar a ferramenta indispensável que atenda perfeitamente às suas necessidades. Explore agora para explorar todo o potencial da IA.
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de produtividade com IA para o trabalho diário em 2026! A XIX.AI selecionou uma lista poderosa e revolucionária com base em rankings rigorosos, atualizados semanalmente, e em testes práticos. Você encontrará opções imperdíveis que aumentam a eficiência na redação, agilizam a criação de conteúdo e ajudam a superar os desafios do dia a dia no trabalho. Veja uma comparação entre versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai


Интересный подход к обучению с подкреплением через текстовые описания! 🧠 Возможно, это поможет создать более 'осмысленных' ИИ-агентов, которые лучше понимают цели. Хотелось бы увидеть больше примеров применения в играх или робототехнике. Есть вопросы по настройке гиперпараметров модели.


