


 Lar
ByteDance apresenta o Lance 3B: um modelo unificado para compreensão e geração visual e linguística
A ByteDance Research tornou oficialmente o Lance, seu grande modelo multimodal unificado nativo, de código aberto.
Embora o setor de IA normalmente dependa de modelos com centenas de bilhões ou trilhões de parâmetros, ou daqueles montados pela combinação de componentes separados, o Lance representa um grande avanço. Ele oferece funcionalidade completa com uma contagem excepcionalmente leve de parâmetros de ativação de 3 bilhões, preenchendo efetivamente a lacuna técnica entre “modelos de compreensão (VLM)” e “modelos generativos (DiT/Diffusion)”.
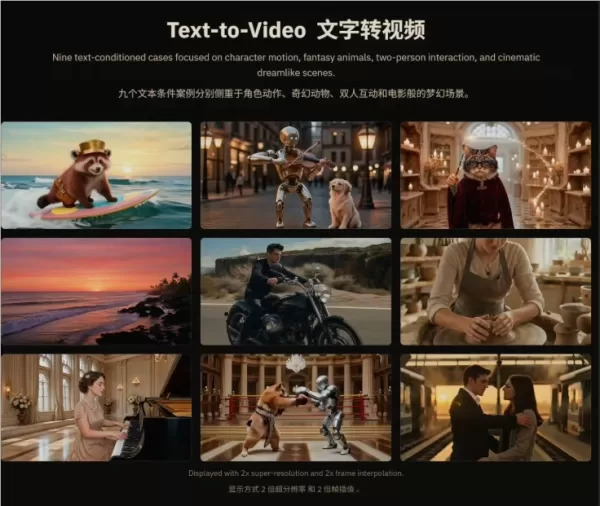
Principais destaques:
Unificado de forma nativa: Construído do zero, em vez de ser uma combinação de partes, ele integra a compreensão de imagens e vídeos, a geração e a edição multimodal em um único sistema.
Desempenho abrangente: um único modelo lida perfeitamente com $X rightarrow T$ (compreensão de texto/vídeo), $X rightarrow I$ (geração/edição de imagem) e $X rightarrow V$ (geração/edição de vídeo) — três tarefas principais de saída.
Código aberto e gratuito: Lançado sob a licença Apache 2.0, altamente permissiva. Os pesos estão totalmente disponíveis no Hugging Face, e todo o processo pode ser executado com um orçamento modesto de 128 GPUs A100.
Análise técnica: como ele consegue a “sincronização” entre demandas contrastantes?
Em arquiteturas tradicionais de IA, as capacidades de “compreensão” e “geração” costumam estar em conflito: as tarefas de compreensão exigem a filtragem de ruído para extrair características semânticas de alto nível, enquanto as tarefas de geração se concentram em texturas de baixo nível, estruturas geométricas e dinâmicas temporais.
Para enfrentar esse desafio em toda a indústria, o Lance emprega um design inteligente de “contexto compartilhado + desacoplamento paralelo de capacidades”:
1. Sequência entrelaçada unificada e arquitetura de especialistas de fluxo duplo
Todas as entradas de texto, imagem e vídeo são primeiro tokenizadas e convertidas em uma “sequência intercalada” unificada. Essa sequência é então processada por uma arquitetura MoE (Multi-Expert) de fluxo duplo, permitindo que especialistas dedicados à “compreensão” e à “geração” operem de forma independente, resolvendo efetivamente os conflitos de capacidade.
Lado da compreensão: os tokens de texto e as entradas visuais utilizam a camada de embedding do Qwen2.5-VL e o codificador ViT para extrair com precisão tokens visuais semânticos de alto nível.
Lado da geração: as entradas visuais são compactadas pelo poderoso VAE causal 3D do Wan2.2, alcançando uma redução de amostragem espacial de $16 vezes$ e uma redução de amostragem temporal de $4 vezes$, preservando assim representações contínuas, dinâmicas e detalhadas.
2. MaPE (Codificação de Posição Rotacional Sensível ao Modo)
Tokens visuais mistos (imagens, texto e vídeos) em sequências longas podem levar a alucinações do tipo “confusão de limites”. O Lance introduz o mecanismo MaPE, que adiciona deslocamentos temporais fixos a diferentes grupos modais. Esse design elegante permite uma forte identificação de limites espaciais e temporais sem perturbar a estrutura interna e a ordem temporal das imagens e dos vídeos.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Treinamento extremo em quatro fases: uma “batalha enxuta” com 128 GPUs
Em contraste com a “estética da força bruta” das grandes empresas que utilizam milhares de GPUs, o processo de treinamento da Lance demonstra alta eficiência financeira. Todo o ciclo de vida é estritamente limitado a um orçamento máximo de 128 GPUs, avançando por quatro fases estreitamente integradas:
Fase 1: Pré-treinamento (1,5 T de tokens) —— Processa 1 bilhão de pares imagem-texto e 140 milhões de pares vídeo-texto para estabelecer uma base robusta para a compreensão multimodal.
Fase 2: Treinamento contínuo (300 bilhões de tokens) —— Incorpora dados de edição, geração orientada por tema e compreensão multimodal para ativar a sinergia multitarefa.
Fase 3: Ajuste fino supervisionado (72 bilhões de tokens) —— Injeta extensivamente instruções humanas, com foco no cumprimento de instruções e na consistência da identidade visual.
Fase 4: Aprendizado por reforço (algoritmo GRPO) —— Utiliza otimização de políticas relativas baseada em grupos e, notavelmente, emprega o PaddleOCR como modelo de recompensa para abordar especificamente problemas de IA, como renderização imprecisa de texto e desalinhamento entre texto e imagens.
Resultados notáveis: o modelo de 3 bilhões de tokens supera gigantes de 7 bilhões de tokens em vários domínios
Graças à colaboração de dados entre tarefas (em que o modelo aprofunda a compreensão enquanto aprende a gerar e aprimora a geração enquanto aprende a compreender), o Lance, com 3 bilhões de parâmetros, alcançou um desempenho notável em vários benchmarks:
Geração de vídeo (VBench): obteve 85,11 pontos! Ele superou modelos “tudo em um” semelhantes, como o TUNA (84,06), e apresentou desempenho superior a modelos especializados em geração de vídeo, como o HunyuanVideo (83,33) e o Wan2.1-T2V (83,69).
Geração de imagens (GenEval): Obteve 0,90, garantindo firmemente uma posição de destaque entre os modelos de código aberto globais.
Compreensão de vídeo (MVBench): Obteve 62,0 pontos, superando significativamente o modelo dedicado à compreensão Show-o2 (7B, 55,7 pontos), que tem o dobro do tamanho do Lance.
Impacto no setor: os custos de implantação para aplicações multimodais cairão drasticamente
O código aberto do Lance representa uma grande revolução no setor, especialmente para áreas em franca expansão, como curtas-metragens de IA, colaboração entre agentes inteligentes (Agent) e mídia interativa.
Anteriormente, o desenvolvimento de uma ferramenta de IA capaz de compreender roteiros, gerar storyboards e modificar elementos visuais em tempo real, mantendo a consistência dos personagens, exigia a implantação, o agendamento e a integração de vários modelos de grande porte (um para a semântica VLM, outro para a geração de imagens por difusão e outro para vídeo temporal). Isso não só causava latência no sistema, como também tornava o alinhamento do pipeline um pesadelo para os desenvolvedores.
Agora, o Lance3B alcança o conceito de “o olho esquerdo vê, o olho direito edita, ambas as mãos criam” com um único modelo
Artigo relacionado
 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
Recomendações de tópicos especiais relacionados
SEO
 As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
 13 ferramentas
 xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

 Comentários (0)
A ByteDance Research tornou oficialmente o Lance, seu grande modelo multimodal unificado nativo, de código aberto.
Embora o setor de IA normalmente dependa de modelos com centenas de bilhões ou trilhões de parâmetros, ou daqueles montados pela combinação de componentes separados, o Lance representa um grande avanço. Ele oferece funcionalidade completa com uma contagem excepcionalmente leve de parâmetros de ativação de 3 bilhões, preenchendo efetivamente a lacuna técnica entre “modelos de compreensão (VLM)” e “modelos generativos (DiT/Diffusion)”.
Principais destaques:
Unificado de forma nativa: Construído do zero, em vez de ser uma combinação de partes, ele integra a compreensão de imagens e vídeos, a geração e a edição multimodal em um único sistema.
Desempenho abrangente: um único modelo lida perfeitamente com $X rightarrow T$ (compreensão de texto/vídeo), $X rightarrow I$ (geração/edição de imagem) e $X rightarrow V$ (geração/edição de vídeo) — três tarefas principais de saída.
Código aberto e gratuito: Lançado sob a licença Apache 2.0, altamente permissiva. Os pesos estão totalmente disponíveis no Hugging Face, e todo o processo pode ser executado com um orçamento modesto de 128 GPUs A100.
Análise técnica: como ele consegue a “sincronização” entre demandas contrastantes?
Em arquiteturas tradicionais de IA, as capacidades de “compreensão” e “geração” costumam estar em conflito: as tarefas de compreensão exigem a filtragem de ruído para extrair características semânticas de alto nível, enquanto as tarefas de geração se concentram em texturas de baixo nível, estruturas geométricas e dinâmicas temporais.
Para enfrentar esse desafio em toda a indústria, o Lance emprega um design inteligente de “contexto compartilhado + desacoplamento paralelo de capacidades”:
1. Sequência entrelaçada unificada e arquitetura de especialistas de fluxo duplo
Todas as entradas de texto, imagem e vídeo são primeiro tokenizadas e convertidas em uma “sequência intercalada” unificada. Essa sequência é então processada por uma arquitetura MoE (Multi-Expert) de fluxo duplo, permitindo que especialistas dedicados à “compreensão” e à “geração” operem de forma independente, resolvendo efetivamente os conflitos de capacidade.
Lado da compreensão: os tokens de texto e as entradas visuais utilizam a camada de embedding do Qwen2.5-VL e o codificador ViT para extrair com precisão tokens visuais semânticos de alto nível.
Lado da geração: as entradas visuais são compactadas pelo poderoso VAE causal 3D do Wan2.2, alcançando uma redução de amostragem espacial de $16 vezes$ e uma redução de amostragem temporal de $4 vezes$, preservando assim representações contínuas, dinâmicas e detalhadas.
2. MaPE (Codificação de Posição Rotacional Sensível ao Modo)
Tokens visuais mistos (imagens, texto e vídeos) em sequências longas podem levar a alucinações do tipo “confusão de limites”. O Lance introduz o mecanismo MaPE, que adiciona deslocamentos temporais fixos a diferentes grupos modais. Esse design elegante permite uma forte identificação de limites espaciais e temporais sem perturbar a estrutura interna e a ordem temporal das imagens e dos vídeos.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Treinamento extremo em quatro fases: uma “batalha enxuta” com 128 GPUs
Em contraste com a “estética da força bruta” das grandes empresas que utilizam milhares de GPUs, o processo de treinamento da Lance demonstra alta eficiência financeira. Todo o ciclo de vida é estritamente limitado a um orçamento máximo de 128 GPUs, avançando por quatro fases estreitamente integradas:
Fase 1: Pré-treinamento (1,5 T de tokens) —— Processa 1 bilhão de pares imagem-texto e 140 milhões de pares vídeo-texto para estabelecer uma base robusta para a compreensão multimodal.
Fase 2: Treinamento contínuo (300 bilhões de tokens) —— Incorpora dados de edição, geração orientada por tema e compreensão multimodal para ativar a sinergia multitarefa.
Fase 3: Ajuste fino supervisionado (72 bilhões de tokens) —— Injeta extensivamente instruções humanas, com foco no cumprimento de instruções e na consistência da identidade visual.
Fase 4: Aprendizado por reforço (algoritmo GRPO) —— Utiliza otimização de políticas relativas baseada em grupos e, notavelmente, emprega o PaddleOCR como modelo de recompensa para abordar especificamente problemas de IA, como renderização imprecisa de texto e desalinhamento entre texto e imagens.
Resultados notáveis: o modelo de 3 bilhões de tokens supera gigantes de 7 bilhões de tokens em vários domínios
Graças à colaboração de dados entre tarefas (em que o modelo aprofunda a compreensão enquanto aprende a gerar e aprimora a geração enquanto aprende a compreender), o Lance, com 3 bilhões de parâmetros, alcançou um desempenho notável em vários benchmarks:
Geração de vídeo (VBench): obteve 85,11 pontos! Ele superou modelos “tudo em um” semelhantes, como o TUNA (84,06), e apresentou desempenho superior a modelos especializados em geração de vídeo, como o HunyuanVideo (83,33) e o Wan2.1-T2V (83,69).
Geração de imagens (GenEval): Obteve 0,90, garantindo firmemente uma posição de destaque entre os modelos de código aberto globais.
Compreensão de vídeo (MVBench): Obteve 62,0 pontos, superando significativamente o modelo dedicado à compreensão Show-o2 (7B, 55,7 pontos), que tem o dobro do tamanho do Lance.
Impacto no setor: os custos de implantação para aplicações multimodais cairão drasticamente
O código aberto do Lance representa uma grande revolução no setor, especialmente para áreas em franca expansão, como curtas-metragens de IA, colaboração entre agentes inteligentes (Agent) e mídia interativa.
Anteriormente, o desenvolvimento de uma ferramenta de IA capaz de compreender roteiros, gerar storyboards e modificar elementos visuais em tempo real, mantendo a consistência dos personagens, exigia a implantação, o agendamento e a integração de vários modelos de grande porte (um para a semântica VLM, outro para a geração de imagens por difusão e outro para vídeo temporal). Isso não só causava latência no sistema, como também tornava o alinhamento do pipeline um pesadelo para os desenvolvedores.
Agora, o Lance3B alcança o conceito de “o olho esquerdo vê, o olho direito edita, ambas as mãos criam” com um único modelo








 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
 Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai












