


 Heim
ByteDance stellt „Lance 3B“ vor: Ein einheitliches Modell für das Verständnis und die Generierung von Bild- und Sprachdaten
ByteDance Research hat „Lance“, sein natives, einheitliches multimodales Großmodell, offiziell als Open-Source-Projekt veröffentlicht.
Während die KI-Branche in der Regel auf Modelle mit Hunderten von Milliarden oder Billionen von Parametern setzt oder auf solche, die durch die Kombination separater Komponenten zusammengesetzt werden, stellt „Lance“ einen bedeutenden Durchbruch dar. Es bietet volle Funktionalität bei einer außergewöhnlich geringen Anzahl von Aktivierungsparametern von 3B (3 Milliarden) und überbrückt damit effektiv die technische Kluft zwischen „Verständnismodellen (VLM)“ und „generativen Modellen (DiT/Diffusion)“.
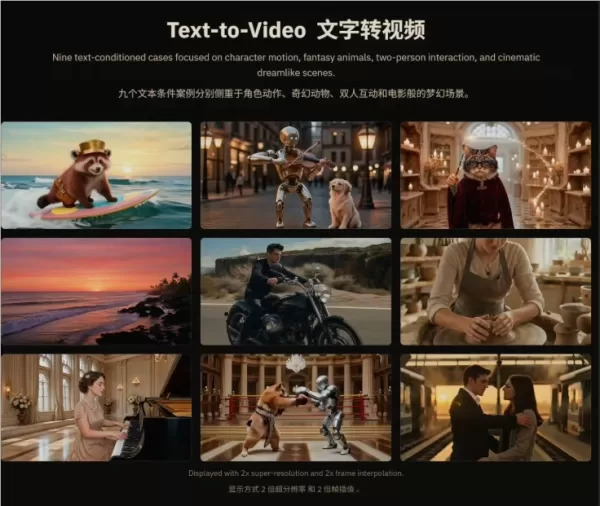
Wichtigste Highlights:
Von Grund auf einheitlich: Es wurde von Grund auf neu entwickelt und nicht aus einzelnen Komponenten zusammengesetzt. Das Modell integriert Bild- und Videoverstånd, -generierung sowie modalübergreifende Bearbeitung in einem einzigen System.
Umfassende Leistungsfähigkeit: Ein einziges Modell bewältigt nahtlos $X rightarrow T$ (Text-/Videoverstånd), $X rightarrow I$ (Bildgenerierung/-bearbeitung) und $X rightarrow V$ (Videogenerierung/-bearbeitung) – drei zentrale Ausgabeeinsätze.
Open Source & kostenlos: Veröffentlicht unter der äußerst freizügigen Apache-2.0-Lizenz. Die Gewichte sind auf Hugging Face vollständig verfügbar, und der gesamte Prozess lässt sich mit einem bescheidenen Budget von 128 A100-GPUs ausführen.
Technische Aufschlüsselung: Wie wird die „Synchronisation“ zwischen gegensätzlichen Anforderungen erreicht?
In traditionellen KI-Architekturen standen sich die Fähigkeiten des „Verstehens“ und der „Generierung“ oft entgegen: Verständnisaufgaben erfordern das Herausfiltern von Rauschen, um semantische Merkmale auf hoher Ebene zu extrahieren, während sich Generierungsaufgaben auf Texturen auf niedriger Ebene, geometrische Strukturen und zeitliche Dynamiken konzentrieren.
Um diese branchenweite Herausforderung zu bewältigen, setzt Lance auf ein cleveres Design mit „gemeinsamem Kontext und paralleler Entkopplung der Fähigkeiten“:
1. Einheitliche verschachtelte Sequenz und Dual-Stream-Expertenarchitektur
Alle Text-, Bild- und Videoeingaben werden zunächst tokenisiert und in eine einheitliche „verschachtelte Sequenz“ umgewandelt. Diese Sequenz wird anschließend von einer Dual-Stream-MoE-Architektur (Multi-Expert) verarbeitet, wodurch Experten für „Verstehen“ und „Generierung“ unabhängig voneinander arbeiten können, wodurch Kapazitätskonflikte effektiv gelöst werden.
Verständnisseite: Text-Token und visuelle Eingaben nutzen die Einbettungsschicht von Qwen2.5-VL und den ViT-Encoder, um hochrangige semantische visuelle Token präzise zu extrahieren.
Generierungsseite: Visuelle Eingaben werden durch das leistungsstarke 3D-Kausal-VAE von Wan2.2 komprimiert, wodurch eine räumliche Abtastungsreduktion um das $16-Fache$ und eine zeitliche Abtastungsreduktion um das $4-Fache$ erreicht wird, wodurch detaillierte, dynamische und kontinuierliche Darstellungen erhalten bleiben.
2. MaPE (Modal-Aware Rotational Position Encoding)
Gemischte visuelle Token (Bilder, Text und Videos) in langen Sequenzen können zu Halluzinationen in Form von „Grenzenverwirrung“ führen. Lance führt den MaPE-Mechanismus ein, der verschiedenen modalen Gruppen feste Zeitversätze hinzufügt. Dieses elegante Design ermöglicht eine starke räumliche und zeitliche Grenzerkennung, ohne die interne Struktur und zeitliche Reihenfolge von Bildern und Videos zu stören.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Vierphasiges Extremtraining: Ein „schlanker Kampf“ mit 128 GPUs
Im Gegensatz zur „Brute-Force-Ästhetik“ großer Unternehmen, die Tausende von GPUs einsetzen, zeichnet sich der Trainingsprozess von Lance durch hohe finanzielle Effizienz aus. Der gesamte Lebenszyklus ist streng auf ein maximales Budget von 128 GPUs begrenzt und durchläuft vier eng miteinander verzahnte Phasen:
Phase 1: Vortraining (1,5 T Tokens) – Verarbeitet 1 Mrd. Bild-Text-Paare und 140 Mio. Video-Text-Paare, um eine robuste Grundlage für multimodales Verständnis zu schaffen.
Phase 2: Kontinuierliches Training (300 Mrd. Token) —— Bezieht Daten zu Bearbeitung, themenorientierter Generierung und multimodalem Verständnis ein, um Synergien bei der Multitasking-Fähigkeit zu aktivieren.
Phase 3: Überwachtes Feintuning (72 Mrd. Token) —— Führt in großem Umfang menschliche Anweisungen ein, wobei der Schwerpunkt auf der Befolgung von Anweisungen und der Konsistenz der visuellen Identität liegt.
Phase 4: Verstärkendes Lernen (GRPO-Algorithmus) —— Nutzt gruppenbasierte relative Policy-Optimierung und setzt insbesondere PaddleOCR als Belohnungsmodell ein, um KI-Probleme wie ungenaue Textwiedergabe und Fehlausrichtung zwischen Text und Bildern gezielt anzugehen.
Hervorragende Ergebnisse: 3B-Modell schlägt 7B-Giganten in mehreren Domänen
Dank der aufgabenübergreifenden Datenzusammenarbeit (bei der das Modell sein Verständnis vertieft, während es das Generieren lernt, und die Generierung verbessert, während es das Verstehen lernt) erzielte das 3B-Modell „Lance“ bei verschiedenen Benchmarks bemerkenswerte Leistungen:
Videogenerierung (VBench): 85,11 Punkte! Es übertraf ähnliche All-in-One-Modelle wie TUNA (84,06) und schnitt besser ab als spezialisierte Videogenerierungsmodelle wie HunyuanVideo (83,33) und Wan2.1-T2V (83,69).
Bildgenerierung (GenEval): Erreichte 0,90 Punkte und sicherte sich damit einen Spitzenplatz unter den globalen Open-Source-Modellen.
Videoverstånd (MVBench): 62,0 Punkte – damit wurde das dedizierte Verständnismodell Show-o2 (7B, 55,7 Punkte), das doppelt so groß ist wie Lance, deutlich übertroffen.
Branchenumwälzung: Die Einsatzkosten für multimodale Anwendungen werden drastisch sinken
Die Open-Source-Veröffentlichung von Lance stellt eine bedeutende Umwälzung in der Branche dar, insbesondere für boomende Bereiche wie KI-Kurzfilme, die Zusammenarbeit mit intelligenten Agenten (Agent) und interaktive Medien.
Bisher erforderte die Entwicklung eines KI-Tools, das Drehbücher verstehen, Storyboards generieren und visuelle Elemente in Echtzeit anpassen kann, während gleichzeitig die Konsistenz der Charaktere gewahrt bleibt, den Einsatz, die Planung und die Verknüpfung mehrerer großer Modelle (eines für VLM-Semantik, eines für die Diffusions-Bildgenerierung und eines für zeitliche Videodaten). Dies führte nicht nur zu Systemlatenz, sondern machte auch die Abstimmung der Pipeline für Entwickler zu einem Albtraum.
Nun verwirklicht Lance3B mit einem einzigen Modell das Prinzip „Das linke Auge sieht, das rechte Auge bearbeitet, beide Hände gestalten“.
Verwandter Artikel
 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
Empfehlungen zu verwandten Spezialthemen
Schreiben
 Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

 Kommentare (0)
ByteDance Research hat „Lance“, sein natives, einheitliches multimodales Großmodell, offiziell als Open-Source-Projekt veröffentlicht.
Während die KI-Branche in der Regel auf Modelle mit Hunderten von Milliarden oder Billionen von Parametern setzt oder auf solche, die durch die Kombination separater Komponenten zusammengesetzt werden, stellt „Lance“ einen bedeutenden Durchbruch dar. Es bietet volle Funktionalität bei einer außergewöhnlich geringen Anzahl von Aktivierungsparametern von 3B (3 Milliarden) und überbrückt damit effektiv die technische Kluft zwischen „Verständnismodellen (VLM)“ und „generativen Modellen (DiT/Diffusion)“.
Wichtigste Highlights:
Von Grund auf einheitlich: Es wurde von Grund auf neu entwickelt und nicht aus einzelnen Komponenten zusammengesetzt. Das Modell integriert Bild- und Videoverstånd, -generierung sowie modalübergreifende Bearbeitung in einem einzigen System.
Umfassende Leistungsfähigkeit: Ein einziges Modell bewältigt nahtlos $X rightarrow T$ (Text-/Videoverstånd), $X rightarrow I$ (Bildgenerierung/-bearbeitung) und $X rightarrow V$ (Videogenerierung/-bearbeitung) – drei zentrale Ausgabeeinsätze.
Open Source & kostenlos: Veröffentlicht unter der äußerst freizügigen Apache-2.0-Lizenz. Die Gewichte sind auf Hugging Face vollständig verfügbar, und der gesamte Prozess lässt sich mit einem bescheidenen Budget von 128 A100-GPUs ausführen.
Technische Aufschlüsselung: Wie wird die „Synchronisation“ zwischen gegensätzlichen Anforderungen erreicht?
In traditionellen KI-Architekturen standen sich die Fähigkeiten des „Verstehens“ und der „Generierung“ oft entgegen: Verständnisaufgaben erfordern das Herausfiltern von Rauschen, um semantische Merkmale auf hoher Ebene zu extrahieren, während sich Generierungsaufgaben auf Texturen auf niedriger Ebene, geometrische Strukturen und zeitliche Dynamiken konzentrieren.
Um diese branchenweite Herausforderung zu bewältigen, setzt Lance auf ein cleveres Design mit „gemeinsamem Kontext und paralleler Entkopplung der Fähigkeiten“:
1. Einheitliche verschachtelte Sequenz und Dual-Stream-Expertenarchitektur
Alle Text-, Bild- und Videoeingaben werden zunächst tokenisiert und in eine einheitliche „verschachtelte Sequenz“ umgewandelt. Diese Sequenz wird anschließend von einer Dual-Stream-MoE-Architektur (Multi-Expert) verarbeitet, wodurch Experten für „Verstehen“ und „Generierung“ unabhängig voneinander arbeiten können, wodurch Kapazitätskonflikte effektiv gelöst werden.
Verständnisseite: Text-Token und visuelle Eingaben nutzen die Einbettungsschicht von Qwen2.5-VL und den ViT-Encoder, um hochrangige semantische visuelle Token präzise zu extrahieren.
Generierungsseite: Visuelle Eingaben werden durch das leistungsstarke 3D-Kausal-VAE von Wan2.2 komprimiert, wodurch eine räumliche Abtastungsreduktion um das $16-Fache$ und eine zeitliche Abtastungsreduktion um das $4-Fache$ erreicht wird, wodurch detaillierte, dynamische und kontinuierliche Darstellungen erhalten bleiben.
2. MaPE (Modal-Aware Rotational Position Encoding)
Gemischte visuelle Token (Bilder, Text und Videos) in langen Sequenzen können zu Halluzinationen in Form von „Grenzenverwirrung“ führen. Lance führt den MaPE-Mechanismus ein, der verschiedenen modalen Gruppen feste Zeitversätze hinzufügt. Dieses elegante Design ermöglicht eine starke räumliche und zeitliche Grenzerkennung, ohne die interne Struktur und zeitliche Reihenfolge von Bildern und Videos zu stören.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Vierphasiges Extremtraining: Ein „schlanker Kampf“ mit 128 GPUs
Im Gegensatz zur „Brute-Force-Ästhetik“ großer Unternehmen, die Tausende von GPUs einsetzen, zeichnet sich der Trainingsprozess von Lance durch hohe finanzielle Effizienz aus. Der gesamte Lebenszyklus ist streng auf ein maximales Budget von 128 GPUs begrenzt und durchläuft vier eng miteinander verzahnte Phasen:
Phase 1: Vortraining (1,5 T Tokens) – Verarbeitet 1 Mrd. Bild-Text-Paare und 140 Mio. Video-Text-Paare, um eine robuste Grundlage für multimodales Verständnis zu schaffen.
Phase 2: Kontinuierliches Training (300 Mrd. Token) —— Bezieht Daten zu Bearbeitung, themenorientierter Generierung und multimodalem Verständnis ein, um Synergien bei der Multitasking-Fähigkeit zu aktivieren.
Phase 3: Überwachtes Feintuning (72 Mrd. Token) —— Führt in großem Umfang menschliche Anweisungen ein, wobei der Schwerpunkt auf der Befolgung von Anweisungen und der Konsistenz der visuellen Identität liegt.
Phase 4: Verstärkendes Lernen (GRPO-Algorithmus) —— Nutzt gruppenbasierte relative Policy-Optimierung und setzt insbesondere PaddleOCR als Belohnungsmodell ein, um KI-Probleme wie ungenaue Textwiedergabe und Fehlausrichtung zwischen Text und Bildern gezielt anzugehen.
Hervorragende Ergebnisse: 3B-Modell schlägt 7B-Giganten in mehreren Domänen
Dank der aufgabenübergreifenden Datenzusammenarbeit (bei der das Modell sein Verständnis vertieft, während es das Generieren lernt, und die Generierung verbessert, während es das Verstehen lernt) erzielte das 3B-Modell „Lance“ bei verschiedenen Benchmarks bemerkenswerte Leistungen:
Videogenerierung (VBench): 85,11 Punkte! Es übertraf ähnliche All-in-One-Modelle wie TUNA (84,06) und schnitt besser ab als spezialisierte Videogenerierungsmodelle wie HunyuanVideo (83,33) und Wan2.1-T2V (83,69).
Bildgenerierung (GenEval): Erreichte 0,90 Punkte und sicherte sich damit einen Spitzenplatz unter den globalen Open-Source-Modellen.
Videoverstånd (MVBench): 62,0 Punkte – damit wurde das dedizierte Verständnismodell Show-o2 (7B, 55,7 Punkte), das doppelt so groß ist wie Lance, deutlich übertroffen.
Branchenumwälzung: Die Einsatzkosten für multimodale Anwendungen werden drastisch sinken
Die Open-Source-Veröffentlichung von Lance stellt eine bedeutende Umwälzung in der Branche dar, insbesondere für boomende Bereiche wie KI-Kurzfilme, die Zusammenarbeit mit intelligenten Agenten (Agent) und interaktive Medien.
Bisher erforderte die Entwicklung eines KI-Tools, das Drehbücher verstehen, Storyboards generieren und visuelle Elemente in Echtzeit anpassen kann, während gleichzeitig die Konsistenz der Charaktere gewahrt bleibt, den Einsatz, die Planung und die Verknüpfung mehrerer großer Modelle (eines für VLM-Semantik, eines für die Diffusions-Bildgenerierung und eines für zeitliche Videodaten). Dies führte nicht nur zu Systemlatenz, sondern machte auch die Abstimmung der Pipeline für Entwickler zu einem Albtraum.
Nun verwirklicht Lance3B mit einem einzigen Modell das Prinzip „Das linke Auge sieht, das rechte Auge bearbeitet, beide Hände gestalten“.








 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai












