


 Hogar
ByteDance presenta Lance 3B: un modelo unificado para la comprensión y la generación visual y lingüística
ByteDance Research ha publicado oficialmente en código abierto «Lance», su modelo grande multimodal unificado nativo.
Mientras que el sector de la IA suele basarse en modelos con cientos de miles de millones o billones de parámetros, o en aquellos ensamblados mediante la combinación de componentes independientes, Lance supone un gran avance. Ofrece una funcionalidad completa con un número de parámetros de activación excepcionalmente reducido, de 3.000 millones, lo que salva de forma efectiva la brecha técnica entre los «modelos de comprensión (VLM)» y los «modelos generativos (DiT/Diffusion)».
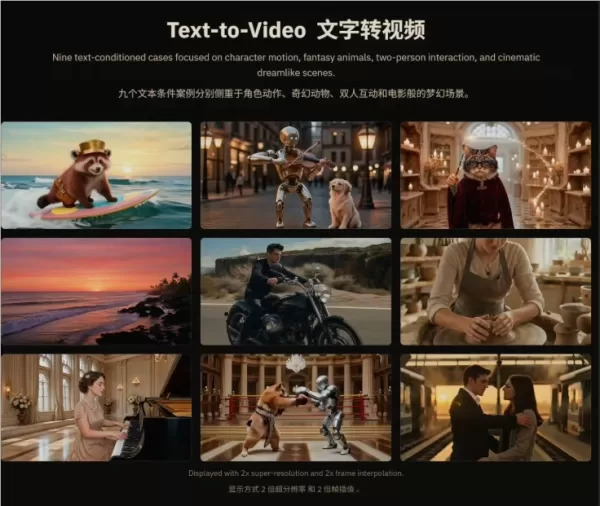
Aspectos destacados:
Unificado de forma nativa: creado desde cero en lugar de ser un ensamblaje de elementos, integra la comprensión de imágenes y vídeos, la generación y la edición multimodal en un único sistema.
Rendimiento integral: un único modelo gestiona a la perfección $X rightarrow T$ (comprensión de texto/vídeo), $X rightarrow I$ (generación/edición de imágenes) y $X rightarrow V$ (generación/edición de vídeo), las tres tareas de salida fundamentales.
Código abierto y gratuito: publicado bajo la licencia Apache 2.0, muy permisiva. Los pesos están totalmente disponibles en Hugging Face, y todo el proceso puede ejecutarse con un presupuesto modesto de 128 GPU A100.
Desglose técnico: ¿cómo logra la «sincronización» entre exigencias contrapuestas?
En las arquitecturas tradicionales de IA, las capacidades de «comprensión» y «generación» suelen estar en conflicto: las tareas de comprensión requieren filtrar el ruido para extraer características semánticas de alto nivel, mientras que las tareas de generación se centran en texturas de bajo nivel, estructuras geométricas y dinámicas temporales.
Para abordar este reto común a todo el sector, Lance emplea un ingenioso diseño de «contexto compartido + desacoplamiento paralelo de capacidades»:
1. Secuencia entrelazada unificada y arquitectura de expertos de doble flujo
Todas las entradas de texto, imagen y vídeo se tokenizan primero y se convierten en una «secuencia entrelazada» unificada. A continuación, esta secuencia es procesada por una arquitectura MoE (Multi-Expert) de doble flujo, lo que permite que los expertos dedicados a la «comprensión» y la «generación» operen de forma independiente, resolviendo así de manera eficaz los conflictos de capacidades.
Lado de la comprensión: Los tokens de texto y las entradas visuales utilizan la capa de incrustación de Qwen2.5-VL y el codificador ViT para extraer con precisión tokens visuales semánticos de alto nivel.
Lado de la generación: Las entradas visuales se comprimen mediante el potente VAE causal 3D de Wan2.2, lo que permite un submuestreo espacial de $16 veces$ y un submuestreo temporal de $4 veces$, conservando así representaciones continuas, dinámicas y detalladas.
2. MaPE (Codificación de posición rotacional sensible al modo)
Los tokens visuales mixtos (imágenes, texto y vídeos) en secuencias largas pueden dar lugar a alucinaciones de «confusión de límites». Lance introduce el mecanismo MaPE, que añade desplazamientos temporales fijos a diferentes grupos modales. Este elegante diseño permite una sólida identificación de los límites espaciales y temporales sin alterar la estructura interna ni el orden temporal de las imágenes y los vídeos.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Entrenamiento extremo en cuatro fases: una «batalla austera» con 128 GPU
En contraste con la «estética de la fuerza bruta» de las grandes empresas que utilizan miles de GPU, el proceso de entrenamiento de Lance demuestra una alta eficiencia financiera. Todo el ciclo de vida tiene un límite estricto de 128 GPU, y avanza a través de cuatro fases estrechamente integradas:
Fase 1: Preentrenamiento (1,5 T de tokens) —— Procesa 1.000 millones de pares imagen-texto y 140 millones de pares vídeo-texto para establecer una base sólida para la comprensión multimodal.
Fase 2: Entrenamiento continuo (300 000 millones de tokens) —— Incorpora datos de edición, generación basada en temas y comprensión multimodal para activar la sinergia multitarea.
Fase 3: Ajuste fino supervisado (72 000 millones de tokens) —— Inyecta de forma extensiva instrucciones humanas, centrándose en el cumplimiento de instrucciones y la coherencia de la identidad visual.
Fase 4: Aprendizaje por refuerzo (algoritmo GRPO) —— Utiliza la optimización de políticas relativas basada en grupos y, en particular, emplea PaddleOCR como modelo de recompensa para abordar específicamente problemas de la IA, como la representación inexacta del texto y la desalineación entre el texto y las imágenes.
Resultados sobresalientes: el modelo de 3 000 millones supera a los gigantes de 7 000 millones en múltiples ámbitos
Gracias a la colaboración de datos entre tareas (en la que el modelo profundiza en la comprensión mientras aprende a generar, y mejora la generación mientras aprende a comprender), el modelo Lance de 3B logró un rendimiento notable en diversas pruebas de referencia:
Generación de vídeo (VBench): ¡Obtuvo 85,11 puntos! Superó a modelos «todo en uno» similares, como TUNA (84,06), y obtuvo mejores resultados que modelos especializados en la generación de vídeo, como HunyuanVideo (83,33) y Wan2.1-T2V (83,69).
Generación de imágenes (GenEval): obtuvo una puntuación de 0,90, lo que le aseguró firmemente una posición de liderazgo entre los modelos de código abierto a nivel mundial.
Comprensión de vídeo (MVBench): ha obtenido 62,0 puntos, superando con creces al modelo dedicado a la comprensión Show-o2 (7B, 55,7 puntos), que duplica el tamaño de Lance.
Impacto en el sector: los costes de implementación de las aplicaciones multimodales se reducirán drásticamente
El código abierto de Lance supone una importante disrupción en el sector, especialmente en campos en auge como los cortometrajes de IA, la colaboración con agentes inteligentes (Agent) y los medios interactivos.
Anteriormente, desarrollar una herramienta de IA capaz de comprender guiones, generar storyboards y modificar elementos visuales en tiempo real, manteniendo al mismo tiempo la coherencia de los personajes, requería implementar, programar y unir múltiples modelos de gran tamaño (uno para la semántica VLM, otro para la generación de imágenes por difusión y otro para el vídeo temporal). Esto no solo provocaba latencia en el sistema, sino que también convertía la alineación del flujo de trabajo en una pesadilla para los desarrolladores.
Ahora, Lance3B logra que «el ojo izquierdo vea, el derecho edite y ambas manos creen» con un único modelo.
Artículo relacionado
 El lanzamiento global de la campaña de campus de Seed de ByteDance ofrece acciones virtuales para captar a los mejores talentos en modelos grandes
En el competitivo panorama de los modelos de lenguaje grandes, asegurar el talento de primer nivel sigue siendo el activo estratégico más crítico.El 1 de abril, ByteDance anunció el lanzamiento de su iniciativa global de reclutamiento de campus Seed
Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Herramientas de referencia de estilos visuales basadas en IA para fichas de personajes, moodboards y presentaciones
¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
 11 herramientas
 xix.ai
SEO
Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

 comentario (0)
0/500
ByteDance Research ha publicado oficialmente en código abierto «Lance», su modelo grande multimodal unificado nativo.
Mientras que el sector de la IA suele basarse en modelos con cientos de miles de millones o billones de parámetros, o en aquellos ensamblados mediante la combinación de componentes independientes, Lance supone un gran avance. Ofrece una funcionalidad completa con un número de parámetros de activación excepcionalmente reducido, de 3.000 millones, lo que salva de forma efectiva la brecha técnica entre los «modelos de comprensión (VLM)» y los «modelos generativos (DiT/Diffusion)».
Aspectos destacados:
Unificado de forma nativa: creado desde cero en lugar de ser un ensamblaje de elementos, integra la comprensión de imágenes y vídeos, la generación y la edición multimodal en un único sistema.
Rendimiento integral: un único modelo gestiona a la perfección $X rightarrow T$ (comprensión de texto/vídeo), $X rightarrow I$ (generación/edición de imágenes) y $X rightarrow V$ (generación/edición de vídeo), las tres tareas de salida fundamentales.
Código abierto y gratuito: publicado bajo la licencia Apache 2.0, muy permisiva. Los pesos están totalmente disponibles en Hugging Face, y todo el proceso puede ejecutarse con un presupuesto modesto de 128 GPU A100.
Desglose técnico: ¿cómo logra la «sincronización» entre exigencias contrapuestas?
En las arquitecturas tradicionales de IA, las capacidades de «comprensión» y «generación» suelen estar en conflicto: las tareas de comprensión requieren filtrar el ruido para extraer características semánticas de alto nivel, mientras que las tareas de generación se centran en texturas de bajo nivel, estructuras geométricas y dinámicas temporales.
Para abordar este reto común a todo el sector, Lance emplea un ingenioso diseño de «contexto compartido + desacoplamiento paralelo de capacidades»:
1. Secuencia entrelazada unificada y arquitectura de expertos de doble flujo
Todas las entradas de texto, imagen y vídeo se tokenizan primero y se convierten en una «secuencia entrelazada» unificada. A continuación, esta secuencia es procesada por una arquitectura MoE (Multi-Expert) de doble flujo, lo que permite que los expertos dedicados a la «comprensión» y la «generación» operen de forma independiente, resolviendo así de manera eficaz los conflictos de capacidades.
Lado de la comprensión: Los tokens de texto y las entradas visuales utilizan la capa de incrustación de Qwen2.5-VL y el codificador ViT para extraer con precisión tokens visuales semánticos de alto nivel.
Lado de la generación: Las entradas visuales se comprimen mediante el potente VAE causal 3D de Wan2.2, lo que permite un submuestreo espacial de $16 veces$ y un submuestreo temporal de $4 veces$, conservando así representaciones continuas, dinámicas y detalladas.
2. MaPE (Codificación de posición rotacional sensible al modo)
Los tokens visuales mixtos (imágenes, texto y vídeos) en secuencias largas pueden dar lugar a alucinaciones de «confusión de límites». Lance introduce el mecanismo MaPE, que añade desplazamientos temporales fijos a diferentes grupos modales. Este elegante diseño permite una sólida identificación de los límites espaciales y temporales sin alterar la estructura interna ni el orden temporal de las imágenes y los vídeos.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Entrenamiento extremo en cuatro fases: una «batalla austera» con 128 GPU
En contraste con la «estética de la fuerza bruta» de las grandes empresas que utilizan miles de GPU, el proceso de entrenamiento de Lance demuestra una alta eficiencia financiera. Todo el ciclo de vida tiene un límite estricto de 128 GPU, y avanza a través de cuatro fases estrechamente integradas:
Fase 1: Preentrenamiento (1,5 T de tokens) —— Procesa 1.000 millones de pares imagen-texto y 140 millones de pares vídeo-texto para establecer una base sólida para la comprensión multimodal.
Fase 2: Entrenamiento continuo (300 000 millones de tokens) —— Incorpora datos de edición, generación basada en temas y comprensión multimodal para activar la sinergia multitarea.
Fase 3: Ajuste fino supervisado (72 000 millones de tokens) —— Inyecta de forma extensiva instrucciones humanas, centrándose en el cumplimiento de instrucciones y la coherencia de la identidad visual.
Fase 4: Aprendizaje por refuerzo (algoritmo GRPO) —— Utiliza la optimización de políticas relativas basada en grupos y, en particular, emplea PaddleOCR como modelo de recompensa para abordar específicamente problemas de la IA, como la representación inexacta del texto y la desalineación entre el texto y las imágenes.
Resultados sobresalientes: el modelo de 3 000 millones supera a los gigantes de 7 000 millones en múltiples ámbitos
Gracias a la colaboración de datos entre tareas (en la que el modelo profundiza en la comprensión mientras aprende a generar, y mejora la generación mientras aprende a comprender), el modelo Lance de 3B logró un rendimiento notable en diversas pruebas de referencia:
Generación de vídeo (VBench): ¡Obtuvo 85,11 puntos! Superó a modelos «todo en uno» similares, como TUNA (84,06), y obtuvo mejores resultados que modelos especializados en la generación de vídeo, como HunyuanVideo (83,33) y Wan2.1-T2V (83,69).
Generación de imágenes (GenEval): obtuvo una puntuación de 0,90, lo que le aseguró firmemente una posición de liderazgo entre los modelos de código abierto a nivel mundial.
Comprensión de vídeo (MVBench): ha obtenido 62,0 puntos, superando con creces al modelo dedicado a la comprensión Show-o2 (7B, 55,7 puntos), que duplica el tamaño de Lance.
Impacto en el sector: los costes de implementación de las aplicaciones multimodales se reducirán drásticamente
El código abierto de Lance supone una importante disrupción en el sector, especialmente en campos en auge como los cortometrajes de IA, la colaboración con agentes inteligentes (Agent) y los medios interactivos.
Anteriormente, desarrollar una herramienta de IA capaz de comprender guiones, generar storyboards y modificar elementos visuales en tiempo real, manteniendo al mismo tiempo la coherencia de los personajes, requería implementar, programar y unir múltiples modelos de gran tamaño (uno para la semántica VLM, otro para la generación de imágenes por difusión y otro para el vídeo temporal). Esto no solo provocaba latencia en el sistema, sino que también convertía la alineación del flujo de trabajo en una pesadilla para los desarrolladores.
Ahora, Lance3B logra que «el ojo izquierdo vea, el derecho edite y ambas manos creen» con un único modelo.








 El lanzamiento global de la campaña de campus de Seed de ByteDance ofrece acciones virtuales para captar a los mejores talentos en modelos grandes
En el competitivo panorama de los modelos de lenguaje grandes, asegurar el talento de primer nivel sigue siendo el activo estratégico más crítico.El 1 de abril, ByteDance anunció el lanzamiento de su iniciativa global de reclutamiento de campus Seed
 Suno añade marcas de agua a las canciones en medio de batallas legales
Suno, la plataforma que permite a los usuarios generar música creada por inteligencia artificial, ha presentado nuevas funciones para etiquetar las pistas producidas en la plataforma, restringir las descargas y actualizar las normas de la comunidad c
 Musk admite que Grok filtró código de usuarios, promete borrar todos los datos históricos
Elon Musk abordó directamente la controversia por privacidad relacionada con Grok Build, comenzando con un simple "Verdadero" para confirmar la validez del incidente. Se comprometió a que todos los datos de usuario cargados previamente en SpaceXAI se

¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
11 herramientas
xix.ai

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai












