


 Maison
ByteDance dévoile Lance 3B : un modèle unifié pour la compréhension et la génération visuelles et linguistiques
ByteDance Research a officiellement mis en open source Lance, son grand modèle multimodal unifié natif.
Alors que le secteur de l’IA s’appuie généralement sur des modèles comportant des centaines de milliards, voire des milliers de milliards de paramètres, ou sur des modèles assemblés à partir de composants distincts, Lance représente une avancée majeure. Il offre toutes ses fonctionnalités avec un nombre de paramètres d'activation exceptionnellement réduit de 3 milliards, comblant ainsi efficacement le fossé technique entre les « modèles de compréhension (VLM) » et les « modèles génératifs (DiT/Diffusion) ».
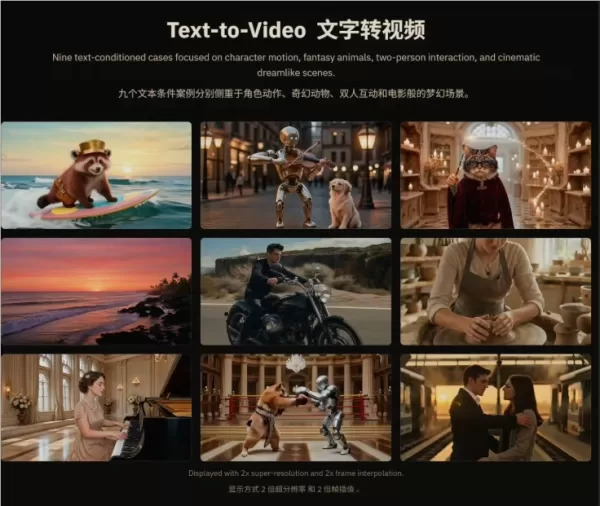
Points forts :
Unifié de manière native : conçu à partir de zéro plutôt qu’assemblé à partir d’éléments existants, il intègre la compréhension des images et des vidéos, la génération et l’édition intermodale au sein d’un seul et même système.
Performances complètes : un seul modèle gère de manière transparente $X rightarrow T$ (compréhension de texte/vidéo), $X rightarrow I$ (génération/édition d’images) et $X rightarrow V$ (génération/édition de vidéos) — trois tâches de sortie essentielles.
Open source et gratuit : publié sous la licence Apache 2.0, très permissive. Les poids sont entièrement disponibles sur Hugging Face, et l’ensemble du processus peut être exécuté avec un budget modeste de 128 GPU A100.
Analyse technique : comment parvient-il à « synchroniser » des exigences contradictoires ?
Dans les architectures d’IA traditionnelles, les capacités de « compréhension » et de « génération » ont souvent été en contradiction : les tâches de compréhension nécessitent de filtrer le bruit pour extraire des caractéristiques sémantiques de haut niveau, tandis que les tâches de génération se concentrent sur les textures de bas niveau, les structures géométriques et les dynamiques temporelles.
Pour relever ce défi commun à l’ensemble du secteur, Lance utilise une conception ingénieuse combinant « contexte partagé » et « découplage des capacités en parallèle » :
1. Séquence entrelacée unifiée et architecture à double flux d’experts
Toutes les entrées textuelles, image et vidéo sont d’abord tokenisées puis converties en une « séquence entrelacée » unifiée. Cette séquence est ensuite traitée par une architecture MoE (Multi-Expert) à double flux, permettant aux experts dédiés à la « compréhension » et à la « génération » de fonctionner indépendamment, ce qui résout efficacement les conflits de capacités.
Côté « compréhension » : les tokens textuels et les entrées visuelles utilisent la couche d’embedding de Qwen2.5-VL et l’encodeur ViT pour extraire avec précision des tokens visuels sémantiques de haut niveau.
Côté génération : les entrées visuelles sont compressées par le puissant VAE causal 3D de Wan2.2, permettant un sous-échantillonnage spatial $16 fois$ supérieur et un sous-échantillonnage temporel $4 fois$ supérieur, préservant ainsi des représentations continues, dynamiques et détaillées.
2. MaPE (encodage de position rotationnelle tenant compte des modalités)
Le mélange de tokens visuels (images, texte et vidéos) dans de longues séquences peut entraîner des hallucinations de type « confusion des limites ». Lance introduit le mécanisme MaPE, qui ajoute des décalages temporels fixes à différents groupes modaux. Cette conception élégante permet une identification solide des limites spatiales et temporelles sans perturber la structure interne ni l’ordre temporel des images et des vidéos.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Entraînement extrême en quatre phases : une « bataille allégée » avec 128 GPU
Contrairement à l’« esthétique de la force brute » des grandes entreprises utilisant des milliers de GPU, le processus d’entraînement de Lance fait preuve d’une grande efficacité financière. L’ensemble du cycle de vie est strictement plafonné à un budget maximal de 128 GPU, et se déroule en quatre phases étroitement intégrées :
Phase 1 : Pré-entraînement (1,5 T de tokens) —— Traite 1 milliard de paires image-texte et 140 millions de paires vidéo-texte afin d’établir une base solide pour la compréhension multimodale.
Phase 2 : Entraînement continu (300 milliards de tokens) —— Intègre des données d’édition, de génération axée sur un sujet et de compréhension multimodale afin d’activer la synergie multitâche.
Phase 3 : Ajustement supervisé (72 milliards de tokens) —— Intègre massivement des instructions humaines, en mettant l’accent sur le suivi des instructions et la cohérence de l’identité visuelle.
Phase 4 : Apprentissage par renforcement (algorithme GRPO) —— Utilise l’optimisation relative des politiques par groupes et, notamment, emploie PaddleOCR comme modèle de récompense pour traiter spécifiquement les problèmes liés à l’IA, tels que le rendu inexact du texte et le désalignement entre le texte et les images.
Des résultats exceptionnels : le modèle 3B surpasse les géants de 7B dans plusieurs domaines
Grâce à la collaboration inter-tâches des données (où le modèle approfondit sa compréhension tout en apprenant à générer, et améliore la génération tout en apprenant à comprendre), le modèle Lance de 3 milliards de paramètres a atteint des performances remarquables sur divers benchmarks :
Génération vidéo (VBench) : 85,11 points ! Il a surpassé des modèles « tout-en-un » similaires tels que TUNA (84,06) et a obtenu de meilleurs résultats que des modèles spécialisés dans la génération de vidéos, comme HunyuanVideo (83,33) et Wan2.1-T2V (83,69).
Génération d’images (GenEval) : a obtenu un score de 0,90, s’assurant ainsi une place de choix parmi les modèles open source mondiaux.
Compréhension vidéo (MVBench) : a obtenu un score de 62,0 points, dépassant largement le modèle dédié à la compréhension Show-o2 (7B, 55,7 points), dont la taille est deux fois supérieure à celle de Lance.
Bouleversement du secteur : les coûts de déploiement des applications multimodales vont chuter de manière spectaculaire
La mise en open source de Lance représente une disruption majeure pour le secteur, en particulier pour des domaines en plein essor tels que les courts-métrages en IA, la collaboration entre agents intelligents (Agent) et les médias interactifs.
Auparavant, le développement d’un outil d’IA capable de comprendre des scénarios, de générer des storyboards et de modifier les visuels en temps réel tout en préservant la cohérence des personnages nécessitait le déploiement, la planification et l’assemblage de plusieurs modèles volumineux (un pour la sémantique VLM, un pour la génération d’images par diffusion et un pour la vidéo temporelle). Cela entraînait non seulement une latence du système, mais transformait également l’alignement du pipeline en un véritable cauchemar pour les développeurs.
Désormais, Lance3B permet de « voir de l’œil gauche, éditer de l’œil droit et créer de ses deux mains » grâce à un seul modèle
Article connexe
 Le lancement par Seed de ByteDance d’une campagne mondiale de recrutement sur les campus, offrant des actions virtuelles pour attirer les meilleurs talents en grands modèles
Dans le paysage concurrentiel des grands modèles de langage, la sécurisation des talents de premier plan reste l’actif stratégique le plus critique.Le 1er avril, ByteDance a annoncé le lancement de son initiative de recrutement sur les campus mondiau
Suno appose des filigranes aux chansons dans le cadre de batailles juridiques
Suno, la plateforme permettant aux utilisateurs de générer de la musique créée par l’intelligence artificielle, a dévoilé de nouvelles fonctionnalités pour étiqueter les titres produits sur la plateforme, restreindre les téléchargements et mettre à j
Musk admet que la construction de Grok a divulgué le code utilisateur, promet d’effacer toutes les données historiques
Elon Musk a abordé directement la controverse sur la vie privée concernant Grok Build, en commençant par un simple « Vrai » pour confirmer la validité de l’incident. Il s’est engagé à ce que toutes les données utilisateur précédemment téléchargées su
Recommandations de sujets spéciaux liés
Conception et art
 Outils de référence stylistique basés sur l'IA pour les fiches de personnages, les moodboards et les présentations commerciales
Les meilleurs outils de référence en matière de style visuel généré par IA pour 2026, destinés aux fiches de personnages, aux moodboards et aux présentations, sont désormais disponibles sur XIX.AI ! Cette sélection triée sur le volet regroupe des outils puissants et révolutionnaires qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez une comparaison entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour vous aider à stimuler votre créativité et à optimiser votre flux de travail. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de booster votre productivité !
 11 outils
 xix.ai
Référencement
Les meilleurs outils d'analyse des SERP basés sur l'IA pour la stratégie de référencement
Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
13 outils
xix.ai
Analyse des données
Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

 commentaires (0)
ByteDance Research a officiellement mis en open source Lance, son grand modèle multimodal unifié natif.
Alors que le secteur de l’IA s’appuie généralement sur des modèles comportant des centaines de milliards, voire des milliers de milliards de paramètres, ou sur des modèles assemblés à partir de composants distincts, Lance représente une avancée majeure. Il offre toutes ses fonctionnalités avec un nombre de paramètres d'activation exceptionnellement réduit de 3 milliards, comblant ainsi efficacement le fossé technique entre les « modèles de compréhension (VLM) » et les « modèles génératifs (DiT/Diffusion) ».
Points forts :
Unifié de manière native : conçu à partir de zéro plutôt qu’assemblé à partir d’éléments existants, il intègre la compréhension des images et des vidéos, la génération et l’édition intermodale au sein d’un seul et même système.
Performances complètes : un seul modèle gère de manière transparente $X rightarrow T$ (compréhension de texte/vidéo), $X rightarrow I$ (génération/édition d’images) et $X rightarrow V$ (génération/édition de vidéos) — trois tâches de sortie essentielles.
Open source et gratuit : publié sous la licence Apache 2.0, très permissive. Les poids sont entièrement disponibles sur Hugging Face, et l’ensemble du processus peut être exécuté avec un budget modeste de 128 GPU A100.
Analyse technique : comment parvient-il à « synchroniser » des exigences contradictoires ?
Dans les architectures d’IA traditionnelles, les capacités de « compréhension » et de « génération » ont souvent été en contradiction : les tâches de compréhension nécessitent de filtrer le bruit pour extraire des caractéristiques sémantiques de haut niveau, tandis que les tâches de génération se concentrent sur les textures de bas niveau, les structures géométriques et les dynamiques temporelles.
Pour relever ce défi commun à l’ensemble du secteur, Lance utilise une conception ingénieuse combinant « contexte partagé » et « découplage des capacités en parallèle » :
1. Séquence entrelacée unifiée et architecture à double flux d’experts
Toutes les entrées textuelles, image et vidéo sont d’abord tokenisées puis converties en une « séquence entrelacée » unifiée. Cette séquence est ensuite traitée par une architecture MoE (Multi-Expert) à double flux, permettant aux experts dédiés à la « compréhension » et à la « génération » de fonctionner indépendamment, ce qui résout efficacement les conflits de capacités.
Côté « compréhension » : les tokens textuels et les entrées visuelles utilisent la couche d’embedding de Qwen2.5-VL et l’encodeur ViT pour extraire avec précision des tokens visuels sémantiques de haut niveau.
Côté génération : les entrées visuelles sont compressées par le puissant VAE causal 3D de Wan2.2, permettant un sous-échantillonnage spatial $16 fois$ supérieur et un sous-échantillonnage temporel $4 fois$ supérieur, préservant ainsi des représentations continues, dynamiques et détaillées.
2. MaPE (encodage de position rotationnelle tenant compte des modalités)
Le mélange de tokens visuels (images, texte et vidéos) dans de longues séquences peut entraîner des hallucinations de type « confusion des limites ». Lance introduit le mécanisme MaPE, qui ajoute des décalages temporels fixes à différents groupes modaux. Cette conception élégante permet une identification solide des limites spatiales et temporelles sans perturber la structure interne ni l’ordre temporel des images et des vidéos.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Entraînement extrême en quatre phases : une « bataille allégée » avec 128 GPU
Contrairement à l’« esthétique de la force brute » des grandes entreprises utilisant des milliers de GPU, le processus d’entraînement de Lance fait preuve d’une grande efficacité financière. L’ensemble du cycle de vie est strictement plafonné à un budget maximal de 128 GPU, et se déroule en quatre phases étroitement intégrées :
Phase 1 : Pré-entraînement (1,5 T de tokens) —— Traite 1 milliard de paires image-texte et 140 millions de paires vidéo-texte afin d’établir une base solide pour la compréhension multimodale.
Phase 2 : Entraînement continu (300 milliards de tokens) —— Intègre des données d’édition, de génération axée sur un sujet et de compréhension multimodale afin d’activer la synergie multitâche.
Phase 3 : Ajustement supervisé (72 milliards de tokens) —— Intègre massivement des instructions humaines, en mettant l’accent sur le suivi des instructions et la cohérence de l’identité visuelle.
Phase 4 : Apprentissage par renforcement (algorithme GRPO) —— Utilise l’optimisation relative des politiques par groupes et, notamment, emploie PaddleOCR comme modèle de récompense pour traiter spécifiquement les problèmes liés à l’IA, tels que le rendu inexact du texte et le désalignement entre le texte et les images.
Des résultats exceptionnels : le modèle 3B surpasse les géants de 7B dans plusieurs domaines
Grâce à la collaboration inter-tâches des données (où le modèle approfondit sa compréhension tout en apprenant à générer, et améliore la génération tout en apprenant à comprendre), le modèle Lance de 3 milliards de paramètres a atteint des performances remarquables sur divers benchmarks :
Génération vidéo (VBench) : 85,11 points ! Il a surpassé des modèles « tout-en-un » similaires tels que TUNA (84,06) et a obtenu de meilleurs résultats que des modèles spécialisés dans la génération de vidéos, comme HunyuanVideo (83,33) et Wan2.1-T2V (83,69).
Génération d’images (GenEval) : a obtenu un score de 0,90, s’assurant ainsi une place de choix parmi les modèles open source mondiaux.
Compréhension vidéo (MVBench) : a obtenu un score de 62,0 points, dépassant largement le modèle dédié à la compréhension Show-o2 (7B, 55,7 points), dont la taille est deux fois supérieure à celle de Lance.
Bouleversement du secteur : les coûts de déploiement des applications multimodales vont chuter de manière spectaculaire
La mise en open source de Lance représente une disruption majeure pour le secteur, en particulier pour des domaines en plein essor tels que les courts-métrages en IA, la collaboration entre agents intelligents (Agent) et les médias interactifs.
Auparavant, le développement d’un outil d’IA capable de comprendre des scénarios, de générer des storyboards et de modifier les visuels en temps réel tout en préservant la cohérence des personnages nécessitait le déploiement, la planification et l’assemblage de plusieurs modèles volumineux (un pour la sémantique VLM, un pour la génération d’images par diffusion et un pour la vidéo temporelle). Cela entraînait non seulement une latence du système, mais transformait également l’alignement du pipeline en un véritable cauchemar pour les développeurs.
Désormais, Lance3B permet de « voir de l’œil gauche, éditer de l’œil droit et créer de ses deux mains » grâce à un seul modèle








 Le lancement par Seed de ByteDance d’une campagne mondiale de recrutement sur les campus, offrant des actions virtuelles pour attirer les meilleurs talents en grands modèles
Dans le paysage concurrentiel des grands modèles de langage, la sécurisation des talents de premier plan reste l’actif stratégique le plus critique.Le 1er avril, ByteDance a annoncé le lancement de son initiative de recrutement sur les campus mondiau
 Suno appose des filigranes aux chansons dans le cadre de batailles juridiques
Suno, la plateforme permettant aux utilisateurs de générer de la musique créée par l’intelligence artificielle, a dévoilé de nouvelles fonctionnalités pour étiqueter les titres produits sur la plateforme, restreindre les téléchargements et mettre à j
 Musk admet que la construction de Grok a divulgué le code utilisateur, promet d’effacer toutes les données historiques
Elon Musk a abordé directement la controverse sur la vie privée concernant Grok Build, en commençant par un simple « Vrai » pour confirmer la validité de l’incident. Il s’est engagé à ce que toutes les données utilisateur précédemment téléchargées su

Les meilleurs outils de référence en matière de style visuel généré par IA pour 2026, destinés aux fiches de personnages, aux moodboards et aux présentations, sont désormais disponibles sur XIX.AI ! Cette sélection triée sur le volet regroupe des outils puissants et révolutionnaires qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez une comparaison entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour vous aider à stimuler votre créativité et à optimiser votre flux de travail. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de booster votre productivité !
11 outils
xix.ai

Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
13 outils
xix.ai

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai












