


 家
ByteDanceが「Lance 3B」を発表:視覚と言語の理解・生成を統合したモデル
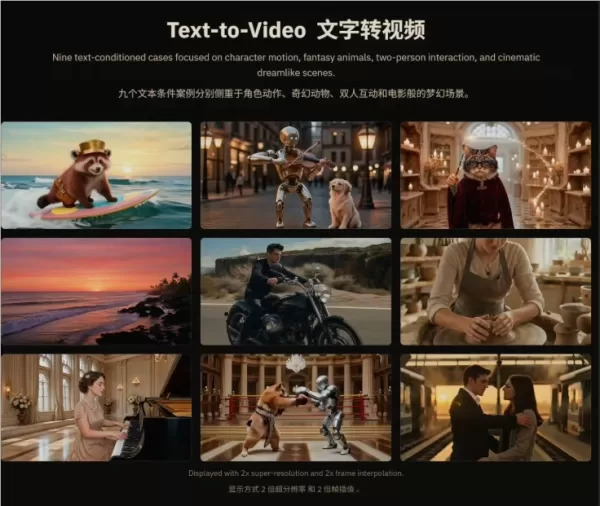
ByteDance Researchは、自社開発の統合型マルチモーダル大規模モデル「Lance」を正式にオープンソース化しました。
AI業界では通常、数百億から数兆のパラメータを持つモデルや、個別のコンポーネントを組み合わせて構築されたモデルが主流ですが、「Lance」は大きなブレークスルーとなります。 わずか30億(3B)という極めて軽量な活性化パラメータ数でありながら、完全な機能を実現しており、「理解モデル(VLM)」と「生成モデル(DiT/Diffusion)」の間の技術的な隔たりを効果的に埋めています。
主な特徴:
ネイティブに統合:既存のコンポーネントを寄せ集めたものではなく、ゼロから構築されており、画像および動画の理解、生成、クロスモーダル編集を単一のシステムに統合しています。
包括的な性能:単一のモデルが、$X rightarrow T$(テキスト/動画理解)、$X rightarrow I$(画像生成/編集)、$X rightarrow V$(動画生成/編集)という3つの主要な出力タスクをシームレスに処理します。
オープンソースかつ無料:非常に許容度の高いApache 2.0ライセンスの下で公開されています。重みデータはHugging Faceで完全に公開されており、128基のA100 GPUという手頃なリソースでプロセス全体を実行可能です。
技術的解説:相反する要求間の「同期」をどのように実現しているのか?
従来のAIアーキテクチャでは、「理解」と「生成」の能力はしばしば対立してきました。理解タスクではノイズをフィルタリングして高レベルの意味的特徴を抽出する必要がありますが、生成タスクは低レベルのテクスチャ、幾何学的構造、時間的ダイナミクスに焦点を当てています。
この業界全体の課題に対処するため、Lanceは巧妙な「共有コンテキスト+並列能力の分離」という設計を採用しています:
1. 統合されたインターリーブシーケンスとデュアルストリーム・エキスパートアーキテクチャ
すべてのテキスト、画像、動画の入力は、まずトークン化され、統一された「インターリーブされたシーケンス」に変換されます。このシーケンスは、デュアルストリームMoE(マルチエキスパート)アーキテクチャによって処理され、「理解」と「生成」に特化したエキスパートが独立して動作することで、機能間の競合を効果的に解決します。
理解側:テキストトークンおよび視覚入力は、Qwen2.5-VLの埋め込み層とViTエンコーダーを活用し、高レベルの意味論的視覚トークンを正確に抽出します。
生成側:視覚入力は、Wan2.2の強力な3D因果VAEによって圧縮され、空間方向で$16倍$、時間方向で$4倍$のダウンサンプリングを実現することで、詳細で動的な連続表現を保持します。
2. MaPE (Modal-Aware Rotational Position Encoding)
長いシーケンス内の混合視覚トークン(画像、テキスト、動画)は、「境界の混同」による幻覚を引き起こす可能性があります。Lanceは、異なるモーダルグループに固定の時間オフセットを追加するMaPEメカニズムを導入しています。この洗練された設計により、画像や動画の内部構造や時間的順序を損なうことなく、強力な空間的および時間的な境界識別が可能になります。
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
4段階のエクストリームトレーニング:128台のGPUによる「リーンな戦い」
数千台のGPUを使用する大手企業の「力業的なアプローチ」とは対照的に、Lanceのトレーニングプロセスは高い費用対効果を発揮します。ライフサイクル全体は最大128台のGPUという予算に厳格に制限されており、密接に連携した4つのフェーズを経て進行します:
フェーズ1:事前学習(1.5Tトークン) —— 10億組の画像・テキストペアと1億4000万組の動画・テキストペアを処理し、マルチモーダル理解のための強固な基盤を確立します。
フェーズ2:継続的学習(3,000億トークン) —— 編集、対象主導型生成、マルチモーダル理解のデータを組み込み、マルチタスクの相乗効果を引き出します。
フェーズ3:教師あり微調整(720億トークン) —— 人間の指示を幅広く取り入れ、指示の順守と視覚的同一性の一貫性に焦点を当てる。
フェーズ4:強化学習(GRPOアルゴリズム) —— グループベースの相対ポリシー最適化を活用し、特にPaddleOCRを報酬モデルとして採用することで、テキストのレンダリングの不正確さやテキストと画像のずれといったAI特有の課題に的を絞って対処します。
卓越した成果:3Bモデルが複数のドメインで7Bの巨人を打ち負かす
タスク間のデータ連携(生成を学習しながら理解を深め、理解を学習しながら生成能力を向上させる)により、3B規模の「Lance」は様々なベンチマークで目覚ましいパフォーマンスを発揮しました:
動画生成(VBench):85.11点を記録! TUNA(84.06)といった類似のオールインワンモデルを上回り、HunyuanVideo(83.33)やWan2.1-T2V(83.69)といった専用の動画生成モデルをも凌駕しました。
画像生成(GenEval):0.90点を記録し、世界のオープンソースモデルの中で確固たるトップの座を確保しました。
動画理解(MVBench):62.0ポイントを獲得し、Lanceの2倍の規模を持つ専用理解モデルShow-o2(7B、55.7ポイント)を大幅に上回りました。
業界に衝撃:マルチモーダルアプリケーションの導入コストが劇的に低下
Lanceのオープンソース化は、特にAI短編映画、インテリジェントエージェント(Agent)のコラボレーション、インタラクティブメディアといった急成長中の分野において、業界に大きな変革をもたらすものです。
これまで、脚本の理解、ストーリーボードの生成、キャラクターの一貫性を維持しながらリアルタイムで映像を修正できるAIツールを開発するには、複数の大規模モデル(VLMのセマンティクス用、Diffusionによる画像生成用、時系列動画用)をデプロイ、スケジューリングし、それらを統合する必要がありました。 これはシステムの遅延を引き起こすだけでなく、開発者にとってパイプラインの整合性を確保する作業を悪夢のようなものにしていた。
現在、Lance3Bは単一のモデルで「左目で見て、右目で編集し、両手で創造する」を実現しています
関連記事
 米国の株式市場が歴史的なマイルストーンに到達、AIと航空宇宙の巨人が1兆ドル規模のデビューに向けて準備を進める
エロン・マスク、サム・アルトマン、ダリオ・アモダイというテクノロジー業界の三巨頭が、それぞれの事業で初公開株式発行(IPO)に向けて進んでいる。スペースX、OpenAI、Anthropicという業界の巨人3社が1兆ドル規模の企業価値に近づき、上場準備を進める中、2026年は米国史上、新規株式発行が最も重要な年となる見込みだ。この歴史的な資金増強は世界の金融の注目を集めており、公的市場がこのような規模の資金を吸収する能力に対する重要なストレステストとなっている。これらの主要な資金調達が一斉に開始
スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
関連特集おすすめ
データ分析
 SaaSおよびEコマースチーム向けのKPIモニタリングにおけるベストなAI異常検知ツール
2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
 10 ツール
 xix.ai
書き込み
長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

 コメント (0)
0/500
ByteDance Researchは、自社開発の統合型マルチモーダル大規模モデル「Lance」を正式にオープンソース化しました。
AI業界では通常、数百億から数兆のパラメータを持つモデルや、個別のコンポーネントを組み合わせて構築されたモデルが主流ですが、「Lance」は大きなブレークスルーとなります。 わずか30億(3B)という極めて軽量な活性化パラメータ数でありながら、完全な機能を実現しており、「理解モデル(VLM)」と「生成モデル(DiT/Diffusion)」の間の技術的な隔たりを効果的に埋めています。
主な特徴:
ネイティブに統合:既存のコンポーネントを寄せ集めたものではなく、ゼロから構築されており、画像および動画の理解、生成、クロスモーダル編集を単一のシステムに統合しています。
包括的な性能:単一のモデルが、$X rightarrow T$(テキスト/動画理解)、$X rightarrow I$(画像生成/編集)、$X rightarrow V$(動画生成/編集)という3つの主要な出力タスクをシームレスに処理します。
オープンソースかつ無料:非常に許容度の高いApache 2.0ライセンスの下で公開されています。重みデータはHugging Faceで完全に公開されており、128基のA100 GPUという手頃なリソースでプロセス全体を実行可能です。
技術的解説:相反する要求間の「同期」をどのように実現しているのか?
従来のAIアーキテクチャでは、「理解」と「生成」の能力はしばしば対立してきました。理解タスクではノイズをフィルタリングして高レベルの意味的特徴を抽出する必要がありますが、生成タスクは低レベルのテクスチャ、幾何学的構造、時間的ダイナミクスに焦点を当てています。
この業界全体の課題に対処するため、Lanceは巧妙な「共有コンテキスト+並列能力の分離」という設計を採用しています:
1. 統合されたインターリーブシーケンスとデュアルストリーム・エキスパートアーキテクチャ
すべてのテキスト、画像、動画の入力は、まずトークン化され、統一された「インターリーブされたシーケンス」に変換されます。このシーケンスは、デュアルストリームMoE(マルチエキスパート)アーキテクチャによって処理され、「理解」と「生成」に特化したエキスパートが独立して動作することで、機能間の競合を効果的に解決します。
理解側:テキストトークンおよび視覚入力は、Qwen2.5-VLの埋め込み層とViTエンコーダーを活用し、高レベルの意味論的視覚トークンを正確に抽出します。
生成側:視覚入力は、Wan2.2の強力な3D因果VAEによって圧縮され、空間方向で$16倍$、時間方向で$4倍$のダウンサンプリングを実現することで、詳細で動的な連続表現を保持します。
2. MaPE (Modal-Aware Rotational Position Encoding)
長いシーケンス内の混合視覚トークン(画像、テキスト、動画)は、「境界の混同」による幻覚を引き起こす可能性があります。Lanceは、異なるモーダルグループに固定の時間オフセットを追加するMaPEメカニズムを導入しています。この洗練された設計により、画像や動画の内部構造や時間的順序を損なうことなく、強力な空間的および時間的な境界識別が可能になります。
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
4段階のエクストリームトレーニング:128台のGPUによる「リーンな戦い」
数千台のGPUを使用する大手企業の「力業的なアプローチ」とは対照的に、Lanceのトレーニングプロセスは高い費用対効果を発揮します。ライフサイクル全体は最大128台のGPUという予算に厳格に制限されており、密接に連携した4つのフェーズを経て進行します:
フェーズ1:事前学習(1.5Tトークン) —— 10億組の画像・テキストペアと1億4000万組の動画・テキストペアを処理し、マルチモーダル理解のための強固な基盤を確立します。
フェーズ2:継続的学習(3,000億トークン) —— 編集、対象主導型生成、マルチモーダル理解のデータを組み込み、マルチタスクの相乗効果を引き出します。
フェーズ3:教師あり微調整(720億トークン) —— 人間の指示を幅広く取り入れ、指示の順守と視覚的同一性の一貫性に焦点を当てる。
フェーズ4:強化学習(GRPOアルゴリズム) —— グループベースの相対ポリシー最適化を活用し、特にPaddleOCRを報酬モデルとして採用することで、テキストのレンダリングの不正確さやテキストと画像のずれといったAI特有の課題に的を絞って対処します。
卓越した成果:3Bモデルが複数のドメインで7Bの巨人を打ち負かす
タスク間のデータ連携(生成を学習しながら理解を深め、理解を学習しながら生成能力を向上させる)により、3B規模の「Lance」は様々なベンチマークで目覚ましいパフォーマンスを発揮しました:
動画生成(VBench):85.11点を記録! TUNA(84.06)といった類似のオールインワンモデルを上回り、HunyuanVideo(83.33)やWan2.1-T2V(83.69)といった専用の動画生成モデルをも凌駕しました。
画像生成(GenEval):0.90点を記録し、世界のオープンソースモデルの中で確固たるトップの座を確保しました。
動画理解(MVBench):62.0ポイントを獲得し、Lanceの2倍の規模を持つ専用理解モデルShow-o2(7B、55.7ポイント)を大幅に上回りました。
業界に衝撃:マルチモーダルアプリケーションの導入コストが劇的に低下
Lanceのオープンソース化は、特にAI短編映画、インテリジェントエージェント(Agent)のコラボレーション、インタラクティブメディアといった急成長中の分野において、業界に大きな変革をもたらすものです。
これまで、脚本の理解、ストーリーボードの生成、キャラクターの一貫性を維持しながらリアルタイムで映像を修正できるAIツールを開発するには、複数の大規模モデル(VLMのセマンティクス用、Diffusionによる画像生成用、時系列動画用)をデプロイ、スケジューリングし、それらを統合する必要がありました。 これはシステムの遅延を引き起こすだけでなく、開発者にとってパイプラインの整合性を確保する作業を悪夢のようなものにしていた。
現在、Lance3Bは単一のモデルで「左目で見て、右目で編集し、両手で創造する」を実現しています








 米国の株式市場が歴史的なマイルストーンに到達、AIと航空宇宙の巨人が1兆ドル規模のデビューに向けて準備を進める
エロン・マスク、サム・アルトマン、ダリオ・アモダイというテクノロジー業界の三巨頭が、それぞれの事業で初公開株式発行(IPO)に向けて進んでいる。スペースX、OpenAI、Anthropicという業界の巨人3社が1兆ドル規模の企業価値に近づき、上場準備を進める中、2026年は米国史上、新規株式発行が最も重要な年となる見込みだ。この歴史的な資金増強は世界の金融の注目を集めており、公的市場がこのような規模の資金を吸収する能力に対する重要なストレステストとなっている。これらの主要な資金調達が一斉に開始
 スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位

2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
10 ツール
xix.ai

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai












