


 Дом
ByteDance представляет Lance 3B: унифицированную модель для обработки изображений, понимания и генерации языка
ByteDance Research официально перевела в открытый доступ Lance — свою собственную унифицированную мультимодальную крупномасштабную модель.
В то время как в сфере искусственного интеллекта обычно используются модели с сотнями миллиардов или триллионами параметров, либо модели, собранные путем объединения отдельных компонентов, Lance представляет собой значительный прорыв. Она обеспечивает полную функциональность при исключительно небольшом количестве параметров активации — 3 млрд (3 миллиарда), эффективно преодолевая технический разрыв между «моделями понимания (VLM)» и «генеративными моделями (DiT/Diffusion)».
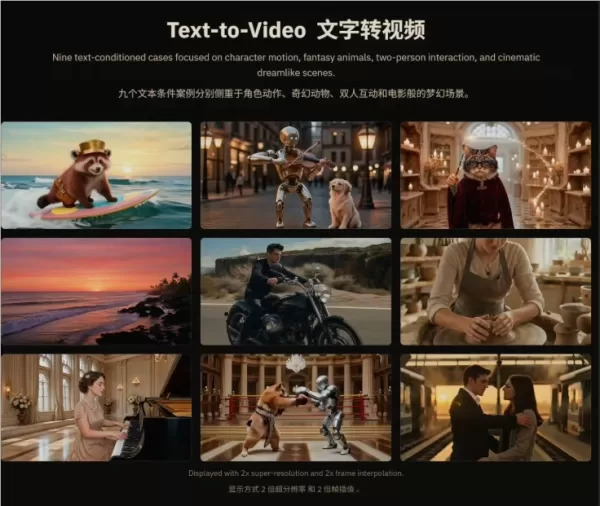
Ключевые особенности:
Нативное объединение: созданная с нуля, а не скомпонованная из отдельных частей, она объединяет понимание изображений и видео, генерацию и кросс-модальное редактирование в единую систему.
Всесторонняя производительность: одна модель беспрепятственно обрабатывает $X rightarrow T$ (понимание текста/видео), $X rightarrow I$ (генерация/редактирование изображений) и $X rightarrow V$ (генерация/редактирование видео) — три основные задачи вывода.
Открытый исходный код и бесплатный доступ: выпущена под очень либеральной лицензией Apache 2.0. Веса полностью доступны на Hugging Face, а весь процесс можно запустить с помощью скромного набора из 128 графических процессоров A100.
Технический анализ: как достигается «синхронизация» между противоречивыми требованиями?
В традиционных архитектурах ИИ возможности «понимания» и «генерации» часто противоречат друг другу: задачи понимания требуют фильтрации шума для извлечения высокоуровневых семантических признаков, тогда как задачи генерации сосредоточены на низкоуровневых текстурах, геометрических структурах и временной динамике.
Чтобы решить эту общеотраслевую проблему, Lance использует продуманную архитектуру «общий контекст + параллельное развязывание возможностей»:
1. Единая чередующаяся последовательность и архитектура с двумя потоками экспертов
Все входные данные — текст, изображения и видео — сначала токенизируются и преобразуются в единую «чередующуюся последовательность». Затем эта последовательность обрабатывается архитектурой Dual-Stream MoE (Multi-Expert), что позволяет экспертам, специализирующимся на «понимании» и «генерации», работать независимо друг от друга, эффективно устраняя конфликты возможностей.
Сторона «понимания»: текстовые токены и визуальные входные данные используют слой вложения Qwen2.5-VL и кодер ViT для точного извлечения высокоуровневых семантических визуальных токенов.
Сторона генерации: визуальные входные данные сжимаются с помощью мощного 3D-каузального VAE модели Wan2.2, что позволяет добиться 16-кратного пространственного и 4-кратного временного понижения разрешения, сохраняя при этом детализированные динамические непрерывные представления.
2. MaPE (кодирование положения вращения с учётом модальности)
Смешанные визуальные токены (изображения, текст и видео) в длинных последовательностях могут приводить к галлюцинациям типа «путаницы границ». В Lance внедрен механизм MaPE, который добавляет фиксированные временные смещения к различным модальным группам. Эта элегантная конструкция обеспечивает надежную идентификацию пространственных и временных границ без нарушения внутренней структуры и временного порядка изображений и видео.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Четырёхфазное экстремальное обучение: «экономная битва» со 128 графическими процессорами
В отличие от «эстетики грубой силы», характерной для крупных компаний, использующих тысячи графических процессоров, процесс обучения Лэнса демонстрирует высокую финансовую эффективность. Весь жизненный цикл строго ограничен максимальным бюджетом в 128 графических процессоров и проходит через четыре тесно интегрированные фазы:
Фаза 1: Предварительное обучение (1,5 Т токенов) —— Обрабатывает 1 млрд пар «изображение-текст» и 140 млн пар «видео-текст» для создания прочной основы мультимодального понимания.
Этап 2: Непрерывное обучение (300 млрд токенов) —— Включает данные по редактированию, генерации на основе темы и мультимодальному пониманию для активизации синергии между различными задачами.
Этап 3: Наблюдаемая тонкая настройка (72 млрд токенов) —— Массивное внедрение инструкций, сданных человеком, с акцентом на выполнение инструкций и согласованность визуальной идентичности.
Этап 4: Обучение с подкреплением (алгоритм GRPO) —— Использует групповую оптимизацию относительной политики и, что особенно важно, применяет PaddleOCR в качестве модели вознаграждения для целенаправленного решения таких проблем ИИ, как неточное отображение текста и несовпадение текста и изображений.
Впечатляющие результаты: модель объёмом 3 млрд токенов превосходит гигантов объёмом 7 млрд токенов в нескольких областях
Благодаря межзадачному взаимодействию данных (когда модель углубляет понимание, обучаясь генерации, и совершенствует генерацию, обучаясь пониманию) модель Lance размером 3B продемонстрировала замечательные результаты в различных тестах:
Генерация видео (VBench): набрала 85,11 баллов! Она превзошла аналогичные универсальные модели, такие как TUNA (84,06), и показала лучшие результаты, чем специализированные модели генерации видео, например HunyuanVideo (83,33) и Wan2.1-T2V (83,69).
Генерация изображений (GenEval): набрала 0,90 балла, прочно закрепившись на лидирующей позиции среди глобальных моделей с открытым исходным кодом.
Понимание видео (MVBench): набрала 62,0 балла, значительно превзойдя специализированную модель понимания Show-o2 (7B, 55,7 балла), размер которой в два раза превышает размер Lance.
Прорыв в отрасли: затраты на развертывание мультимодальных приложений резко снизятся
Открытый исходный код Lance представляет собой значительный прорыв в отрасли, особенно для таких бурно развивающихся областей, как короткометражные фильмы с ИИ, сотрудничество интеллектуальных агентов (Agent) и интерактивные медиа.
Ранее разработка инструмента ИИ, способного понимать сценарии, генерировать раскадровки и модифицировать визуальные элементы в режиме реального времени при сохранении целостности персонажей, требовала развертывания, планирования и объединения нескольких крупных моделей (одной для семантики VLM, одной для генерации изображений методом диффузии и одной для временных видеоданных). Это не только приводило к задержкам в работе системы, но и превращало согласование этапов рабочего процесса в настоящий кошмар для разработчиков.
Теперь Lance3B реализует принцип «левый глаз видит, правый глаз редактирует, обе руки создают» с помощью одной единственной модели
Связанная статья
 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Рекомендации по связанным специальным темам
Анализ данных
 Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
 10 инструментов
 xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

 Комментарии (0)
ByteDance Research официально перевела в открытый доступ Lance — свою собственную унифицированную мультимодальную крупномасштабную модель.
В то время как в сфере искусственного интеллекта обычно используются модели с сотнями миллиардов или триллионами параметров, либо модели, собранные путем объединения отдельных компонентов, Lance представляет собой значительный прорыв. Она обеспечивает полную функциональность при исключительно небольшом количестве параметров активации — 3 млрд (3 миллиарда), эффективно преодолевая технический разрыв между «моделями понимания (VLM)» и «генеративными моделями (DiT/Diffusion)».
Ключевые особенности:
Нативное объединение: созданная с нуля, а не скомпонованная из отдельных частей, она объединяет понимание изображений и видео, генерацию и кросс-модальное редактирование в единую систему.
Всесторонняя производительность: одна модель беспрепятственно обрабатывает $X rightarrow T$ (понимание текста/видео), $X rightarrow I$ (генерация/редактирование изображений) и $X rightarrow V$ (генерация/редактирование видео) — три основные задачи вывода.
Открытый исходный код и бесплатный доступ: выпущена под очень либеральной лицензией Apache 2.0. Веса полностью доступны на Hugging Face, а весь процесс можно запустить с помощью скромного набора из 128 графических процессоров A100.
Технический анализ: как достигается «синхронизация» между противоречивыми требованиями?
В традиционных архитектурах ИИ возможности «понимания» и «генерации» часто противоречат друг другу: задачи понимания требуют фильтрации шума для извлечения высокоуровневых семантических признаков, тогда как задачи генерации сосредоточены на низкоуровневых текстурах, геометрических структурах и временной динамике.
Чтобы решить эту общеотраслевую проблему, Lance использует продуманную архитектуру «общий контекст + параллельное развязывание возможностей»:
1. Единая чередующаяся последовательность и архитектура с двумя потоками экспертов
Все входные данные — текст, изображения и видео — сначала токенизируются и преобразуются в единую «чередующуюся последовательность». Затем эта последовательность обрабатывается архитектурой Dual-Stream MoE (Multi-Expert), что позволяет экспертам, специализирующимся на «понимании» и «генерации», работать независимо друг от друга, эффективно устраняя конфликты возможностей.
Сторона «понимания»: текстовые токены и визуальные входные данные используют слой вложения Qwen2.5-VL и кодер ViT для точного извлечения высокоуровневых семантических визуальных токенов.
Сторона генерации: визуальные входные данные сжимаются с помощью мощного 3D-каузального VAE модели Wan2.2, что позволяет добиться 16-кратного пространственного и 4-кратного временного понижения разрешения, сохраняя при этом детализированные динамические непрерывные представления.
2. MaPE (кодирование положения вращения с учётом модальности)
Смешанные визуальные токены (изображения, текст и видео) в длинных последовательностях могут приводить к галлюцинациям типа «путаницы границ». В Lance внедрен механизм MaPE, который добавляет фиксированные временные смещения к различным модальным группам. Эта элегантная конструкция обеспечивает надежную идентификацию пространственных и временных границ без нарушения внутренней структуры и временного порядка изображений и видео.
[Unified Interleaved Sequence] ──► [MaPE Modal Boundary Isolation] ──► [Dual-Stream Expert Architecture (MoE)]
Четырёхфазное экстремальное обучение: «экономная битва» со 128 графическими процессорами
В отличие от «эстетики грубой силы», характерной для крупных компаний, использующих тысячи графических процессоров, процесс обучения Лэнса демонстрирует высокую финансовую эффективность. Весь жизненный цикл строго ограничен максимальным бюджетом в 128 графических процессоров и проходит через четыре тесно интегрированные фазы:
Фаза 1: Предварительное обучение (1,5 Т токенов) —— Обрабатывает 1 млрд пар «изображение-текст» и 140 млн пар «видео-текст» для создания прочной основы мультимодального понимания.
Этап 2: Непрерывное обучение (300 млрд токенов) —— Включает данные по редактированию, генерации на основе темы и мультимодальному пониманию для активизации синергии между различными задачами.
Этап 3: Наблюдаемая тонкая настройка (72 млрд токенов) —— Массивное внедрение инструкций, сданных человеком, с акцентом на выполнение инструкций и согласованность визуальной идентичности.
Этап 4: Обучение с подкреплением (алгоритм GRPO) —— Использует групповую оптимизацию относительной политики и, что особенно важно, применяет PaddleOCR в качестве модели вознаграждения для целенаправленного решения таких проблем ИИ, как неточное отображение текста и несовпадение текста и изображений.
Впечатляющие результаты: модель объёмом 3 млрд токенов превосходит гигантов объёмом 7 млрд токенов в нескольких областях
Благодаря межзадачному взаимодействию данных (когда модель углубляет понимание, обучаясь генерации, и совершенствует генерацию, обучаясь пониманию) модель Lance размером 3B продемонстрировала замечательные результаты в различных тестах:
Генерация видео (VBench): набрала 85,11 баллов! Она превзошла аналогичные универсальные модели, такие как TUNA (84,06), и показала лучшие результаты, чем специализированные модели генерации видео, например HunyuanVideo (83,33) и Wan2.1-T2V (83,69).
Генерация изображений (GenEval): набрала 0,90 балла, прочно закрепившись на лидирующей позиции среди глобальных моделей с открытым исходным кодом.
Понимание видео (MVBench): набрала 62,0 балла, значительно превзойдя специализированную модель понимания Show-o2 (7B, 55,7 балла), размер которой в два раза превышает размер Lance.
Прорыв в отрасли: затраты на развертывание мультимодальных приложений резко снизятся
Открытый исходный код Lance представляет собой значительный прорыв в отрасли, особенно для таких бурно развивающихся областей, как короткометражные фильмы с ИИ, сотрудничество интеллектуальных агентов (Agent) и интерактивные медиа.
Ранее разработка инструмента ИИ, способного понимать сценарии, генерировать раскадровки и модифицировать визуальные элементы в режиме реального времени при сохранении целостности персонажей, требовала развертывания, планирования и объединения нескольких крупных моделей (одной для семантики VLM, одной для генерации изображений методом диффузии и одной для временных видеоданных). Это не только приводило к задержкам в работе системы, но и превращало согласование этапов рабочего процесса в настоящий кошмар для разработчиков.
Теперь Lance3B реализует принцип «левый глаз видит, правый глаз редактирует, обе руки создают» с помощью одной единственной модели








 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai












