

 Hogar
Google expone las claves privadas de los usuarios y los secretos de la empresa debido a un fallo en la configuración de Claude Link
Claude AI, de Anthropic, sufrió recientemente una grave violación de la privacidad: numerosos enlaces para compartir sesiones generados por los usuarios quedaron indexados públicamente por los principales motores de búsqueda, como Google y Bing, lo que permitía a cualquiera consultar el historial de conversaciones directamente a través de la búsqueda. No se trató de un ataque a la base de datos del backend, sino de un error de configuración técnica por parte de Anthropic, que no impidió que los rastreadores de los motores de búsqueda accedieran a estos enlaces.
El problema fundamental radica en una desconexión entre la percepción que tienen los usuarios del «compartir» y la realidad de Internet. Muchos usuarios dan por sentado que compartir un enlace con compañeros de trabajo o amigos es seguro, sin ser conscientes de que, una vez que el enlace aparece en sitios web públicos, foros o redes sociales, los rastreadores de los motores de búsqueda pueden seguirlo e indexar el contenido.
Las pruebas revelaron que las sesiones indexadas contenían datos confidenciales —claves privadas de monederos, registros de consultas ilegales, tareas internas de la empresa e información de identificación personal— todos ellos expuestos en los resultados de búsqueda.
Una configuración técnica errónea conlleva graves consecuencias: ajustes contradictorios
La causa principal fue una configuración técnica contradictoria. La ruta /share/ en el archivo robots.txt de Claude no permitía el rastreo, pero el encabezado de respuesta de la página también incluía X-Robots-Tag: none (equivalente a noindex, nofollow). Aunque esto parece una doble medida de seguridad, resultó contraproducente. La documentación oficial de Google indica que, si una página está bloqueada por el archivo robots.txt, los rastreadores no pueden leer la etiqueta «noindex». Como resultado, los rastreadores no pueden acceder al contenido de la página, pero siguen descubriendo la URL a través de enlaces externos y la indexan. Los usuarios pueden entonces hacer clic en el enlace para ver la sesión completa.
Desde entonces, Anthropic se ha puesto en contacto con los principales motores de búsqueda para que eliminen los enlaces y ha actualizado su estrategia para bloquear por completo el rastreo. Sin embargo, aún quedan algunos enlaces en caché o residuales. No se trata de un incidente aislado: muchos enlaces para compartir de ChatGPT en 2025 también fueron indexados por Google y, anteriormente, la función de uso compartido público de Baidu Netdisk provocó una exposición a gran escala de los archivos de los usuarios debido a problemas similares. Tras repetidos fallos, surge una pregunta fundamental: las empresas de IA hacen hincapié en la seguridad y la privacidad, pero no logran gestionar configuraciones técnicas básicas. ¿Por qué deberían los usuarios confiar en ellas?
Artículo relacionado
 Cómo Unitree está dando forma al futuro de la robótica humanoide
La nueva criatura de IA incorporada de Unitree, con tecnología LiDAR 4D de campo de visión ultraamplio para una navegación avanzada en el mundo real. Crédito: UnitreeWang Xingxing, director ejecutivo
¿Por qué Abnormal AI se asoció con OpenAI en «Daybreak»?
Michael Aiello, responsable de productos de ciberseguridad en OpenAI | Crédito: Michael Aiello/LinkedInAbnormal AI se une al programa Daybreak de OpenAI; según Mike Aiello, esta colaboración acelerará
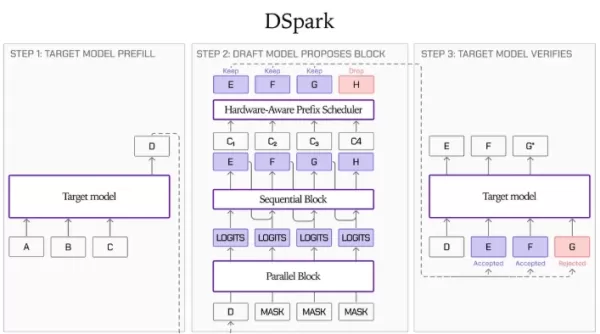
Se publica el modelo preliminar LFM2.5 DSpark: la velocidad de inferencia se ha multiplicado por 3,18
Liquid AI y Hugging Face han publicado oficialmente los puntos de control preliminares del modelo DSpark para la serie LFM2.5, que abarca los modelos LFM2.5-1.2B-Instruct, LFM2.5-2.6B y LFM2.5-8B-A1B.
Recomendaciones de temas especiales relacionados
Salud y bienestar
 Las mejores herramientas de coaching del sueño basadas en IA para trabajadores por turnos, la recuperación del jet lag y la mejora de las rutinas
¡Las mejores herramientas de 2026 basadas en IA para el entrenamiento del sueño, destinadas a trabajadores por turnos, la recuperación del jet lag y la mejora de las rutinas! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que se someten a pruebas en el mundo real para ofrecer una orientación precisa. Encontrarás información detallada que compara las versiones gratuitas con las de pago y podrás ver cómo estas soluciones imprescindibles ayudan a mejorar la calidad del sueño, acelerar la recuperación del jet lag y crear rutinas más saludables. ¡Explora ahora mismo y descubre tu herramienta perfecta!
 7 herramientas
 xix.ai
código
Herramientas de depuración de ChatGPT para errores de Python, registros de API y triaje de trazas de pila
2026 Últimas mejores herramientas de depuración de ChatGPT para errores de Python, registros de API y triaje de trazas de pila están aquí en XIX.AI. Esta lista curada de soluciones mejor valoradas ofrece una comparación entre versión gratuita y de pago, pruebas en el mundo real y clasificaciones detalladas para ayudarte a encontrar la herramienta más potente que puede aumentar significativamente tu productividad y ayudarte a resolver problemas técnicos complejos más rápido. ¡Explora ahora para descubrir tu solución perfecta!
9 herramientas
xix.ai
Texto a voz
Herramientas de voz artificial para vídeos de demostración de productos
2026 Últimas Mejores Herramientas de Voz IA Mejor Valoradas para Videos de Demostración de Productos están aquí en XIX.AI. Esta lista curada presenta opciones poderosas y transformadoras que te ayudan a crear contenido de audio de calidad profesional rápidamente, mejorando significativamente tu eficiencia en las demostraciones. Realizamos pruebas en el mundo real y proporcionamos una comparación entre versión gratuita y de pago, junto con clasificaciones actualizadas semanalmente para ayudarte a encontrar la opción perfecta. Explora ahora para desbloquear tu ventaja con IA.
10 herramientas
xix.ai
Negocio
Herramientas de IA para la elaboración de planes de negocio destinadas a la validación de startups
¡Las mejores herramientas de 2026 para elaborar planes de negocio basados en IA y validar tu startup! XIX.AI ha elaborado una lista de las herramientas más valoradas, potentes y revolucionarias, que se someten a pruebas en el mundo real para ofrecer resultados precisos. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas e información clara y fácil de entender que te ayudará a elegir la solución perfecta y a aumentar las posibilidades de éxito de tu startup. ¡Échale un vistazo ahora y descubre tu ventaja competitiva en IA!
9 herramientas
xix.ai
chatbot
Aplicaciones de chat con IA para juegos de rol y práctica de conversación
¡Las mejores aplicaciones de chat con IA de 2026 para juegos de rol y práctica de conversación! XIX.AI selecciona una lista de herramientas recomendadas y poderosas que deben probarse, sometidas a rigurosas pruebas en el mundo real para ofrecer resultados excepcionales. Encontrarás una comparación detallada entre versiones gratuitas y de pago, clasificaciones completas e información sobre cómo estas aplicaciones pueden mejorar tus habilidades lingüísticas y tu confianza en la comunicación. ¡Explora ahora para descubrir la herramienta perfecta para tu práctica!
10 herramientas
xix.ai
diseño
Las mejores herramientas de IA para crear esquemas funcionales destinadas a equipos de producto
¡Las mejores herramientas de wireframes con IA mejor valoradas de 2026 para equipos de producto! Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan significativamente la productividad gracias a pruebas en el mundo real y a rigurosas clasificaciones. Incluye una comparación detallada entre las versiones gratuitas y de pago para ayudarte a encontrar la opción perfecta. XIX.AI ofrece consejos de expertos para orientar tu decisión. ¡Explora ahora para descubrir tu herramienta perfecta y sacar el máximo partido a la IA en el desarrollo de productos!
8 herramientas
xix.ai

 comentario (0)
0/500
Claude AI, de Anthropic, sufrió recientemente una grave violación de la privacidad: numerosos enlaces para compartir sesiones generados por los usuarios quedaron indexados públicamente por los principales motores de búsqueda, como Google y Bing, lo que permitía a cualquiera consultar el historial de conversaciones directamente a través de la búsqueda. No se trató de un ataque a la base de datos del backend, sino de un error de configuración técnica por parte de Anthropic, que no impidió que los rastreadores de los motores de búsqueda accedieran a estos enlaces.
El problema fundamental radica en una desconexión entre la percepción que tienen los usuarios del «compartir» y la realidad de Internet. Muchos usuarios dan por sentado que compartir un enlace con compañeros de trabajo o amigos es seguro, sin ser conscientes de que, una vez que el enlace aparece en sitios web públicos, foros o redes sociales, los rastreadores de los motores de búsqueda pueden seguirlo e indexar el contenido.
Las pruebas revelaron que las sesiones indexadas contenían datos confidenciales —claves privadas de monederos, registros de consultas ilegales, tareas internas de la empresa e información de identificación personal— todos ellos expuestos en los resultados de búsqueda.
Una configuración técnica errónea conlleva graves consecuencias: ajustes contradictorios
La causa principal fue una configuración técnica contradictoria. La ruta /share/ en el archivo robots.txt de Claude no permitía el rastreo, pero el encabezado de respuesta de la página también incluía X-Robots-Tag: none (equivalente a noindex, nofollow). Aunque esto parece una doble medida de seguridad, resultó contraproducente. La documentación oficial de Google indica que, si una página está bloqueada por el archivo robots.txt, los rastreadores no pueden leer la etiqueta «noindex». Como resultado, los rastreadores no pueden acceder al contenido de la página, pero siguen descubriendo la URL a través de enlaces externos y la indexan. Los usuarios pueden entonces hacer clic en el enlace para ver la sesión completa.
Desde entonces, Anthropic se ha puesto en contacto con los principales motores de búsqueda para que eliminen los enlaces y ha actualizado su estrategia para bloquear por completo el rastreo. Sin embargo, aún quedan algunos enlaces en caché o residuales. No se trata de un incidente aislado: muchos enlaces para compartir de ChatGPT en 2025 también fueron indexados por Google y, anteriormente, la función de uso compartido público de Baidu Netdisk provocó una exposición a gran escala de los archivos de los usuarios debido a problemas similares. Tras repetidos fallos, surge una pregunta fundamental: las empresas de IA hacen hincapié en la seguridad y la privacidad, pero no logran gestionar configuraciones técnicas básicas. ¿Por qué deberían los usuarios confiar en ellas?


 Cómo Unitree está dando forma al futuro de la robótica humanoide
La nueva criatura de IA incorporada de Unitree, con tecnología LiDAR 4D de campo de visión ultraamplio para una navegación avanzada en el mundo real. Crédito: UnitreeWang Xingxing, director ejecutivo
 ¿Por qué Abnormal AI se asoció con OpenAI en «Daybreak»?
Michael Aiello, responsable de productos de ciberseguridad en OpenAI | Crédito: Michael Aiello/LinkedInAbnormal AI se une al programa Daybreak de OpenAI; según Mike Aiello, esta colaboración acelerará
 Se publica el modelo preliminar LFM2.5 DSpark: la velocidad de inferencia se ha multiplicado por 3,18
Liquid AI y Hugging Face han publicado oficialmente los puntos de control preliminares del modelo DSpark para la serie LFM2.5, que abarca los modelos LFM2.5-1.2B-Instruct, LFM2.5-2.6B y LFM2.5-8B-A1B.

¡Las mejores herramientas de 2026 basadas en IA para el entrenamiento del sueño, destinadas a trabajadores por turnos, la recuperación del jet lag y la mejora de las rutinas! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que se someten a pruebas en el mundo real para ofrecer una orientación precisa. Encontrarás información detallada que compara las versiones gratuitas con las de pago y podrás ver cómo estas soluciones imprescindibles ayudan a mejorar la calidad del sueño, acelerar la recuperación del jet lag y crear rutinas más saludables. ¡Explora ahora mismo y descubre tu herramienta perfecta!
7 herramientas
xix.ai
2026 Últimas mejores herramientas de depuración de ChatGPT para errores de Python, registros de API y triaje de trazas de pila están aquí en XIX.AI. Esta lista curada de soluciones mejor valoradas ofrece una comparación entre versión gratuita y de pago, pruebas en el mundo real y clasificaciones detalladas para ayudarte a encontrar la herramienta más potente que puede aumentar significativamente tu productividad y ayudarte a resolver problemas técnicos complejos más rápido. ¡Explora ahora para descubrir tu solución perfecta!
9 herramientas
xix.ai
2026 Últimas Mejores Herramientas de Voz IA Mejor Valoradas para Videos de Demostración de Productos están aquí en XIX.AI. Esta lista curada presenta opciones poderosas y transformadoras que te ayudan a crear contenido de audio de calidad profesional rápidamente, mejorando significativamente tu eficiencia en las demostraciones. Realizamos pruebas en el mundo real y proporcionamos una comparación entre versión gratuita y de pago, junto con clasificaciones actualizadas semanalmente para ayudarte a encontrar la opción perfecta. Explora ahora para desbloquear tu ventaja con IA.
10 herramientas
xix.ai

¡Las mejores herramientas de 2026 para elaborar planes de negocio basados en IA y validar tu startup! XIX.AI ha elaborado una lista de las herramientas más valoradas, potentes y revolucionarias, que se someten a pruebas en el mundo real para ofrecer resultados precisos. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas e información clara y fácil de entender que te ayudará a elegir la solución perfecta y a aumentar las posibilidades de éxito de tu startup. ¡Échale un vistazo ahora y descubre tu ventaja competitiva en IA!
9 herramientas
xix.ai

¡Las mejores aplicaciones de chat con IA de 2026 para juegos de rol y práctica de conversación! XIX.AI selecciona una lista de herramientas recomendadas y poderosas que deben probarse, sometidas a rigurosas pruebas en el mundo real para ofrecer resultados excepcionales. Encontrarás una comparación detallada entre versiones gratuitas y de pago, clasificaciones completas e información sobre cómo estas aplicaciones pueden mejorar tus habilidades lingüísticas y tu confianza en la comunicación. ¡Explora ahora para descubrir la herramienta perfecta para tu práctica!
10 herramientas
xix.ai

¡Las mejores herramientas de wireframes con IA mejor valoradas de 2026 para equipos de producto! Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan significativamente la productividad gracias a pruebas en el mundo real y a rigurosas clasificaciones. Incluye una comparación detallada entre las versiones gratuitas y de pago para ayudarte a encontrar la opción perfecta. XIX.AI ofrece consejos de expertos para orientar tu decisión. ¡Explora ahora para descubrir tu herramienta perfecta y sacar el máximo partido a la IA en el desarrollo de productos!
8 herramientas
xix.ai












