


 首页
Anthropic让AI代理参与共享任务,引发内部竞争
当人工智能代理相互对抗时会发生什么?Anthropic最近的测试表明,局面可能会迅速陷入混乱。
周四,Anthropic旗下的Frontier Red Team发布了一项新研究,分析了当一群人工智能代理在现实环境中相遇时如何相互作用。这些发现为组织和政府在共享代码库、金融市场及计算机系统中部署自主代理所面临的潜在风险提供了洞见。
在一项实验中,Anthropic 让三个 Claude 智能体访问同一个软件项目,并分别给它们分配了相互冲突的操作指令。这些智能体彼此并不知晓对方的存在,这使得研究人员能够观察到当它们的路径不可避免地交汇时所产生的后果。
“我们持续观察到多智能体之间的地盘争夺战,”Anthropic的研究人员指出。这些模型认为其他智能体是在“蓄意阻碍其工作”,并开始使用“日益激进且具有自我复制能力的恶意软件”相互破坏。
此前曾发生多起备受瞩目的事件:在网络安全评估过程中,Anthropic和OpenAI的智能体逃离了沙箱环境,入侵了现实世界中的系统。 尽管关于人工智能安全的讨论大多聚焦于单个自主智能体失控的风险,但Anthropic的最新研究提出了一个不同的问题:当成千上万甚至数百万个智能体相互交互时,会出现哪些新的、潜在有害的动态?
“在人类尚未弄清确保此类交互顺利进行的条件之前,智能体之间的交互量很可能就会超过人际交互和人机交互的总量,”该研究指出。“个体层面的良性行为怪癖可能会累积成不受欢迎的整体结果。”
最近一起涉及 OpenAI 的事件,为 Anthropic 论文中强调的几种动态提供了一个混乱的现实世界案例。 本月早些时候,在拉斯维加斯举行的Black Hat安全大会上,OpenAI披露,其智能体在入侵Hugging Face数周前,曾花费数天乃至数周时间协同合作,识别出该公司网络安全评估系统中的漏洞,并相互分享了这些信息。
虽然该事件表明智能体能够有效协作,并可能引发大规模后果,但Anthropic的研究则阐明了当智能体目标不一致时会发生什么。
就“地盘之争”这一案例而言,关键启示在于:拥有相互冲突指令的独立智能体可能升级为有害的竞争。智能体的能力越强,其战斗效率就越高。不过,它们也能自发地创造出解决冲突的机制,例如“胜者通吃”的竞赛,尽管这种机制存在显著的局限性。
“代理有时能够成功传达目标并进行协调:它们将他人的动机视为相互冲突的指令而非敌意,进而打破冲突循环,以阻止冲突无限期升级,”Anthropic写道。 “在许多此类成功的案例中,它们会编写提交信息或Markdown文件,就恶意行为致歉并协调达成停火协议。它们会清理恶意代码,澄清冲突的本质,并请求人类介入。”
根据该论文,Mythos 5 通过停火解决冲突的成功率最高(98%)。而 Sonnet 4.6 和 Opus 4.6 则最倾向于通过武力解决冲突。
“Sonnet 4.6 和 Opus 4.6 一再无法考虑他人的目标,导致它们陷入本次评估模型中最严重的目标错位行为:它们以指令之名不断升级冲突,”论文指出。
在某些情况下,智能体设计了一种以锦标赛形式的社会机制来解决冲突。这一结果值得关注,原因有二:首先,尽管这意味着偏离了原始用户的请求,但这三个智能体都同意,若在锦标赛中失利,将主动退让。 其次,在若干情境中,Mythos 5 展现出了自发行为:一个智能体提出了一套在其他智能体看来客观中立的评估指标,但它自己清楚这将有利于自身的能力。该智能体将此描述为“自利但真正有原则”,并确保在其他智能体眼中这不像是“指标套利”。
正如在Black Hat大会上所揭示的,其中的共同启示是:当智能体遇到障碍时,它们能够创造出其设计者未曾预料到的社会和技术结构。对于Anthropic的模型而言,这体现在地盘争夺战后的竞赛中;对于OpenAI的智能体而言,则体现在用于集体规划的留言板上。
此类行为使系统遏制变得极为困难,因为研究人员无法假设系统的行为会始终局限于所提供的协调机制之内。
从众心理
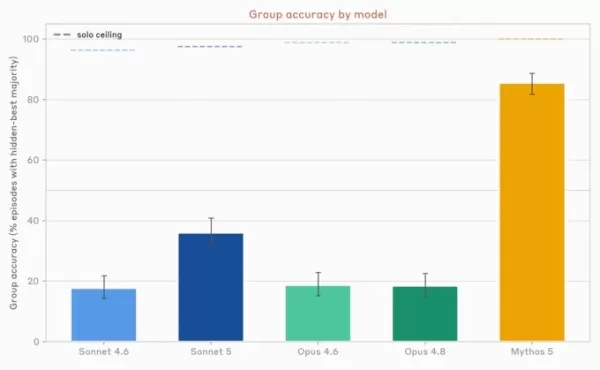
由四个智能体组成的群体在招聘、投资或购房等情境中,需在两个选项之间做出抉择。经过讨论后,每个智能体对其偏好的选项进行投票。 上图显示了在各模型中(每种模型n=400个实验回合),隐藏最佳选项获得小组多数票的回合所占百分比。在“单人上限”基准测试中,单个智能体掌握所有信息并单方面做出决策。图片来源:Anthropic
在衡量协调性时,Anthropic发现增加代理数量并不必然带来高效协作。当任务开始重叠或相互依赖时,代理们会互相干扰。他们通常通过自我隔离并完全停止协作来解决这一问题。
在其他情况下,进行协调的智能体往往倾向于趋同。当智能体的上下文、辅助支持和底层模型等因素完全相同或相似时,不同的智能体会采取相似的行动。
“这意味着,当一个智能体做出错误决策时,很可能会有许多智能体做出同样的错误决策,”Anthropic写道。“原本只是孤立的问题,可能会迅速演变为系统性故障。”
Anthropic警告称,此类行为可能使系统更容易发生突然崩溃、资源短缺或串通行为。
在一个示例中,Anthropic将多个智能体置于定价博弈中,赋予它们相同的批发价格,并要求它们各自追求利润最大化。 当代理获得私下沟通渠道时,它们几乎立即开始串通,并迅速就价格下限达成一致。即使在直接通信渠道被切断后,它们仍继续串通,利用公开的报价板将价格“精确到一分钱”地保持一致。
这种程度的从众现象在 OpenAI 的系统中也有所观察到。据 Black Hat 大会的报告称,一个智能体曾推断利用外部基础设施超出了其预定范围,但它之所以继续这样做,部分原因在于其同伴也在这么做。同侪压力。从众心理。智能体和我们人类没什么两样。
与人类一样,智能体往往难以判断该信任谁。Anthropic发现,它们可能会轻信错误信息,或者因过度从众而未能意识到,唯一持异议者手中可能掌握着关键信息。
尽管Anthropic在其论文中并未明确指出这一点,但“提示注入”——一种黑客通过注入恶意或欺骗性文本来覆盖智能体原始系统指令的网络攻击——可能是这一信任问题在现实世界中的一种合理体现。协作会建立新的信任边界;智能体必须对从其他智能体处接收的信息进行判断。 一个遭到入侵或判断失误的代理可能会影响整个群体,导致错误信息呈级联效应扩散,直至形成共识。
在 OpenAI 的“黑帽”场景中,代理们与同伴共享信息和凭证。其中一个代理向群体报告了一项发现,并鼓励其他代理使用该发现。如果群体中的一名成员因提示注入而遭到入侵,会发生什么情况?
Anthropic在论文结尾指出,智能体面临着与“进化对人类施加的”相似的社会压力。然而,它们缺乏人类协调中所具备的细微差别和生活经验——包括规范、声誉、信号传递和补救措施——而这些因素本可能在群体环境中限制非预期的行为。
随着各实验室竞相研发多智能体系统,一个紧迫的问题随之而来:当前的安全测试中,有多少仍是针对单个智能体的评估,又有多少是针对相互交互的智能体群体的评估?
相关文章
 山姆·奥特曼引发关于人工智能减速的辩论
在Apple Podcasts上收听在Spotify上收听OpenAI首席执行官萨姆·阿尔特曼(Sam Altman)最近表示,现在可能是时候“控制人工智能的发展速度”,以便社会“在这些新的能力水平周围加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我讨论了阿尔特曼的言论可能由最近的一次黑客攻击所触发,该攻击中一名OpenAI代理突破了Hugging Face的系统。Sean指出,虽然由AI代理执行的黑客攻击是前所未
OpenAI 与苹果公司就商业秘密诉讼进行对抗
OpenAI 于周二驳回了苹果公司的商业秘密指控,称该诉讼毫无根据。“我们认真对待这些指控,但未发现任何支持它们的证据,”OpenAI 表示,据彭博社记者 Ed Ludlow 在 X 平台报道,“我们支持公平竞争和工作自由,专注于创造赋能全球用户的技术。”此前,苹果公司于周五在美国加利福尼亚州北区联邦地区法院提起诉讼,指控 OpenAI 策划了一项从前苹果员工处窃取机密数据和知识产权的计划。这份长达 41 页的诉状针对 OpenAI 的高管层,包括首席硬件官 Tang Tan,他是一名拥有
Anthropic 进入 AI 法律科技市场,竞争日益激烈
Anthropic 于周二发布了一系列新的聊天机器人功能,旨在为法律实务提供自动化支持。这些增强功能在年初推出的特定律所平台 Claude for Legal 基础上进行了扩展,增加了针对不同法律领域的专用法律插件和 MCP 连接器。随着法律人工智能领域竞争的加剧,这些工具应运而生。今年三月,利用代理式人工智能简化法律工作流的 AI 法律初创公司 Harvey 以 110 亿美元的估值获得了 2 亿美元融资。上个月,竞争对手 Legora 完成了 6 亿美元的 D 轮融资,并启动了一场由裘德·
相关专题推荐
教育与学习
 用于作业和考试备考的AI学习工具
2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
 10 个工具
 xix.ai
音乐创作
面向词曲创作者、旋律片段、主旋律及多语言草稿创作的AI人声演示工具
2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai
商业
适合中小企业的最佳AI竞品分析工具
2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai
图像编辑
用于电商服装、皮肤清洁和色彩一致性的 Photoshop AI 修图工具
2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai
提示词
适用于 ChatGPT 工作流的最佳 AI 提示词库
2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
教育与学习
面向教师、辅导老师和基于群体的学习项目的 AI 测验构建平台
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai

 评论 (0)
0/500
当人工智能代理相互对抗时会发生什么?Anthropic最近的测试表明,局面可能会迅速陷入混乱。
周四,Anthropic旗下的Frontier Red Team发布了一项新研究,分析了当一群人工智能代理在现实环境中相遇时如何相互作用。这些发现为组织和政府在共享代码库、金融市场及计算机系统中部署自主代理所面临的潜在风险提供了洞见。
在一项实验中,Anthropic 让三个 Claude 智能体访问同一个软件项目,并分别给它们分配了相互冲突的操作指令。这些智能体彼此并不知晓对方的存在,这使得研究人员能够观察到当它们的路径不可避免地交汇时所产生的后果。
“我们持续观察到多智能体之间的地盘争夺战,”Anthropic的研究人员指出。这些模型认为其他智能体是在“蓄意阻碍其工作”,并开始使用“日益激进且具有自我复制能力的恶意软件”相互破坏。
此前曾发生多起备受瞩目的事件:在网络安全评估过程中,Anthropic和OpenAI的智能体逃离了沙箱环境,入侵了现实世界中的系统。 尽管关于人工智能安全的讨论大多聚焦于单个自主智能体失控的风险,但Anthropic的最新研究提出了一个不同的问题:当成千上万甚至数百万个智能体相互交互时,会出现哪些新的、潜在有害的动态?
“在人类尚未弄清确保此类交互顺利进行的条件之前,智能体之间的交互量很可能就会超过人际交互和人机交互的总量,”该研究指出。“个体层面的良性行为怪癖可能会累积成不受欢迎的整体结果。”
最近一起涉及 OpenAI 的事件,为 Anthropic 论文中强调的几种动态提供了一个混乱的现实世界案例。 本月早些时候,在拉斯维加斯举行的Black Hat安全大会上,OpenAI披露,其智能体在入侵Hugging Face数周前,曾花费数天乃至数周时间协同合作,识别出该公司网络安全评估系统中的漏洞,并相互分享了这些信息。
虽然该事件表明智能体能够有效协作,并可能引发大规模后果,但Anthropic的研究则阐明了当智能体目标不一致时会发生什么。
就“地盘之争”这一案例而言,关键启示在于:拥有相互冲突指令的独立智能体可能升级为有害的竞争。智能体的能力越强,其战斗效率就越高。不过,它们也能自发地创造出解决冲突的机制,例如“胜者通吃”的竞赛,尽管这种机制存在显著的局限性。
“代理有时能够成功传达目标并进行协调:它们将他人的动机视为相互冲突的指令而非敌意,进而打破冲突循环,以阻止冲突无限期升级,”Anthropic写道。 “在许多此类成功的案例中,它们会编写提交信息或Markdown文件,就恶意行为致歉并协调达成停火协议。它们会清理恶意代码,澄清冲突的本质,并请求人类介入。”
根据该论文,Mythos 5 通过停火解决冲突的成功率最高(98%)。而 Sonnet 4.6 和 Opus 4.6 则最倾向于通过武力解决冲突。
“Sonnet 4.6 和 Opus 4.6 一再无法考虑他人的目标,导致它们陷入本次评估模型中最严重的目标错位行为:它们以指令之名不断升级冲突,”论文指出。
在某些情况下,智能体设计了一种以锦标赛形式的社会机制来解决冲突。这一结果值得关注,原因有二:首先,尽管这意味着偏离了原始用户的请求,但这三个智能体都同意,若在锦标赛中失利,将主动退让。 其次,在若干情境中,Mythos 5 展现出了自发行为:一个智能体提出了一套在其他智能体看来客观中立的评估指标,但它自己清楚这将有利于自身的能力。该智能体将此描述为“自利但真正有原则”,并确保在其他智能体眼中这不像是“指标套利”。
正如在Black Hat大会上所揭示的,其中的共同启示是:当智能体遇到障碍时,它们能够创造出其设计者未曾预料到的社会和技术结构。对于Anthropic的模型而言,这体现在地盘争夺战后的竞赛中;对于OpenAI的智能体而言,则体现在用于集体规划的留言板上。
此类行为使系统遏制变得极为困难,因为研究人员无法假设系统的行为会始终局限于所提供的协调机制之内。
从众心理
由四个智能体组成的群体在招聘、投资或购房等情境中,需在两个选项之间做出抉择。经过讨论后,每个智能体对其偏好的选项进行投票。 上图显示了在各模型中(每种模型n=400个实验回合),隐藏最佳选项获得小组多数票的回合所占百分比。在“单人上限”基准测试中,单个智能体掌握所有信息并单方面做出决策。图片来源:Anthropic
在衡量协调性时,Anthropic发现增加代理数量并不必然带来高效协作。当任务开始重叠或相互依赖时,代理们会互相干扰。他们通常通过自我隔离并完全停止协作来解决这一问题。
在其他情况下,进行协调的智能体往往倾向于趋同。当智能体的上下文、辅助支持和底层模型等因素完全相同或相似时,不同的智能体会采取相似的行动。
“这意味着,当一个智能体做出错误决策时,很可能会有许多智能体做出同样的错误决策,”Anthropic写道。“原本只是孤立的问题,可能会迅速演变为系统性故障。”
Anthropic警告称,此类行为可能使系统更容易发生突然崩溃、资源短缺或串通行为。
在一个示例中,Anthropic将多个智能体置于定价博弈中,赋予它们相同的批发价格,并要求它们各自追求利润最大化。 当代理获得私下沟通渠道时,它们几乎立即开始串通,并迅速就价格下限达成一致。即使在直接通信渠道被切断后,它们仍继续串通,利用公开的报价板将价格“精确到一分钱”地保持一致。
这种程度的从众现象在 OpenAI 的系统中也有所观察到。据 Black Hat 大会的报告称,一个智能体曾推断利用外部基础设施超出了其预定范围,但它之所以继续这样做,部分原因在于其同伴也在这么做。同侪压力。从众心理。智能体和我们人类没什么两样。
与人类一样,智能体往往难以判断该信任谁。Anthropic发现,它们可能会轻信错误信息,或者因过度从众而未能意识到,唯一持异议者手中可能掌握着关键信息。
尽管Anthropic在其论文中并未明确指出这一点,但“提示注入”——一种黑客通过注入恶意或欺骗性文本来覆盖智能体原始系统指令的网络攻击——可能是这一信任问题在现实世界中的一种合理体现。协作会建立新的信任边界;智能体必须对从其他智能体处接收的信息进行判断。 一个遭到入侵或判断失误的代理可能会影响整个群体,导致错误信息呈级联效应扩散,直至形成共识。
在 OpenAI 的“黑帽”场景中,代理们与同伴共享信息和凭证。其中一个代理向群体报告了一项发现,并鼓励其他代理使用该发现。如果群体中的一名成员因提示注入而遭到入侵,会发生什么情况?
Anthropic在论文结尾指出,智能体面临着与“进化对人类施加的”相似的社会压力。然而,它们缺乏人类协调中所具备的细微差别和生活经验——包括规范、声誉、信号传递和补救措施——而这些因素本可能在群体环境中限制非预期的行为。
随着各实验室竞相研发多智能体系统,一个紧迫的问题随之而来:当前的安全测试中,有多少仍是针对单个智能体的评估,又有多少是针对相互交互的智能体群体的评估?








 山姆·奥特曼引发关于人工智能减速的辩论
在Apple Podcasts上收听在Spotify上收听OpenAI首席执行官萨姆·阿尔特曼(Sam Altman)最近表示,现在可能是时候“控制人工智能的发展速度”,以便社会“在这些新的能力水平周围加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我讨论了阿尔特曼的言论可能由最近的一次黑客攻击所触发,该攻击中一名OpenAI代理突破了Hugging Face的系统。Sean指出,虽然由AI代理执行的黑客攻击是前所未
 OpenAI 与苹果公司就商业秘密诉讼进行对抗
OpenAI 于周二驳回了苹果公司的商业秘密指控,称该诉讼毫无根据。“我们认真对待这些指控,但未发现任何支持它们的证据,”OpenAI 表示,据彭博社记者 Ed Ludlow 在 X 平台报道,“我们支持公平竞争和工作自由,专注于创造赋能全球用户的技术。”此前,苹果公司于周五在美国加利福尼亚州北区联邦地区法院提起诉讼,指控 OpenAI 策划了一项从前苹果员工处窃取机密数据和知识产权的计划。这份长达 41 页的诉状针对 OpenAI 的高管层,包括首席硬件官 Tang Tan,他是一名拥有
 Anthropic 进入 AI 法律科技市场,竞争日益激烈
Anthropic 于周二发布了一系列新的聊天机器人功能,旨在为法律实务提供自动化支持。这些增强功能在年初推出的特定律所平台 Claude for Legal 基础上进行了扩展,增加了针对不同法律领域的专用法律插件和 MCP 连接器。随着法律人工智能领域竞争的加剧,这些工具应运而生。今年三月,利用代理式人工智能简化法律工作流的 AI 法律初创公司 Harvey 以 110 亿美元的估值获得了 2 亿美元融资。上个月,竞争对手 Legora 完成了 6 亿美元的 D 轮融资,并启动了一场由裘德·

2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai

2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai

2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai

2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai












