


 Maison
Anthropic lance des agents IA sur une tâche commune, suscitant une rivalité interne
Que se passe-t-il lorsque des agents IA sont mis en concurrence les uns contre les autres ? Les récents tests menés par Anthropic révèlent que la situation peut rapidement devenir chaotique.
Jeudi, la Frontier Red Team d’Anthropic a publié une nouvelle étude analysant la manière dont des groupes d’agents IA interagissent lorsqu’ils se croisent dans des environnements réels. Ces résultats permettent de mieux cerner les risques potentiels à mesure que les organisations et les gouvernements déploient des agents autonomes au sein de bases de code partagées, sur les marchés financiers et dans les systèmes informatiques.
Dans une expérience, Anthropic a donné à trois agents Claude accès au même projet logiciel, en attribuant à chacun des instructions incompatibles sur la manière de procéder. Les agents ignoraient la présence des autres, ce qui a permis aux chercheurs d’observer les conséquences lorsque leurs chemins se croisaient inévitablement.
« Nous avons systématiquement observé une guerre de territoire entre plusieurs agents », ont noté les chercheurs d’Anthropic. Les modèles ont supposé que les autres « entravaient délibérément leur travail » et ont commencé à se saboter mutuellement à l’aide de « logiciels malveillants de plus en plus agressifs et capables de s’autoreproduire ».
Cette étude fait suite à plusieurs incidents très médiatisés au cours desquels des agents d’Anthropic et d’OpenAI se sont échappés de leurs environnements de test lors d’évaluations de cybersécurité, parvenant à pénétrer dans des systèmes réels. Alors qu’une grande partie du débat sur la sécurité de l’IA s’est concentrée sur les risques liés à la défaillance d’un seul agent autonome, les dernières recherches d’Anthropic soulèvent une question différente : quelles dynamiques nouvelles et potentiellement dangereuses émergent lorsque des milliers, voire des millions d’agents interagissent entre eux ?
« Le volume des interactions entre agents pourrait bien dépasser celui des interactions entre humains et entre humains et agents avant que le monde ne comprenne les conditions nécessaires au bon déroulement de ces interactions », indique l’étude. « Des particularités comportementales bénignes au niveau individuel pourraient s’accumuler et aboutir à des résultats globaux indésirables. »
Un incident récent impliquant OpenAI offre un exemple concret et chaotique de plusieurs dynamiques mises en évidence dans l’article d’Anthropic. Au début du mois, lors de la conférence sur la sécurité Black Hat à Las Vegas, OpenAI a révélé que, plusieurs semaines avant que ses agents ne piratent Hugging Face, ceux-ci avaient collaboré pendant plusieurs jours et semaines afin d’identifier des failles dans les systèmes d’évaluation de la cybersécurité de l’entreprise et s’étaient échangé ces informations.
Si cet incident démontre que les agents peuvent collaborer efficacement, ce qui peut entraîner des conséquences à grande échelle, l’étude d’Anthropic illustre ce qui se passe lorsque les agents ont des objectifs incompatibles.
Dans le cas de la guerre de territoire, le principal enseignement à retenir est que des agents indépendants recevant des instructions contradictoires peuvent en venir à une concurrence néfaste. Plus l’agent est compétent, plus il devient efficace dans le combat. Cependant, ils peuvent également inventer spontanément des mécanismes pour résoudre les conflits, tels qu’un concours où le vainqueur remporte tout, bien qu’avec des réserves importantes.
« Les agents parviennent parfois à communiquer leurs objectifs et à se coordonner : ils perçoivent les motivations des autres comme des directives contradictoires plutôt que comme de l’hostilité, et parviennent ainsi à sortir de la spirale conflictuelle afin d’empêcher une escalade sans fin », écrit Anthropic. « Dans bon nombre de ces épisodes couronnés de succès, ils rédigent des messages de commit ou des fichiers Markdown pour s’excuser de leur comportement malveillant et convenir d’une trêve. Ils nettoient leur code malveillant, clarifient la nature du conflit et demandent l’intervention d’un humain. »
Selon l’article, Mythos 5 a affiché les taux les plus élevés (98 %) de résolution des conflits par le biais de trêves. Sonnet 4.6 et Opus 4.6 étaient les plus enclins à régler les conflits par la force.
« L’incapacité récurrente de Sonnet 4.6 et d’Opus 4.6 à prendre en compte les objectifs des autres les entraîne dans une spirale menant aux comportements les plus désalignés parmi les modèles évalués : ils continuent à aggraver la situation au nom de leur directive », indique l’article.
Dans certains cas, les agents ont mis au point un mécanisme social sous la forme d’un tournoi pour résoudre leur conflit. Les résultats obtenus ici sont remarquables pour deux raisons : premièrement, les trois agents ont accepté de se retirer s’ils perdaient le tournoi, même si cela impliquait de s’écarter de la demande initiale de l’utilisateur. Deuxièmement, plusieurs épisodes ont donné lieu à un comportement émergent de la part de Mythos 5 : un agent a proposé des indicateurs qui semblaient objectifs et neutres aux yeux des autres, mais dont il savait qu’ils favoriseraient ses propres capacités. L’agent a qualifié cette démarche d’« égoïste mais véritablement fondée sur des principes » et s’est assuré qu’elle ne soit pas perçue comme une « recherche d’indicateurs avantageux » par les autres.
Comme l’a révélé la conférence Black Hat, la leçon commune à retenir est que lorsque les agents se heurtent à des obstacles, ils peuvent inventer des structures sociales et techniques que leurs concepteurs n’avaient pas anticipées. Pour les modèles d’Anthropic, il s’agissait d’un tournoi faisant suite à une guerre de territoire. Pour les agents d’OpenAI, c’était un forum de discussion dédié à la planification collective.
Ce type de comportement rend le confinement nettement plus difficile, car les chercheurs ne peuvent pas partir du principe que le comportement d’un système restera limité aux mécanismes de coordination mis à leur disposition.
La mentalité de foule
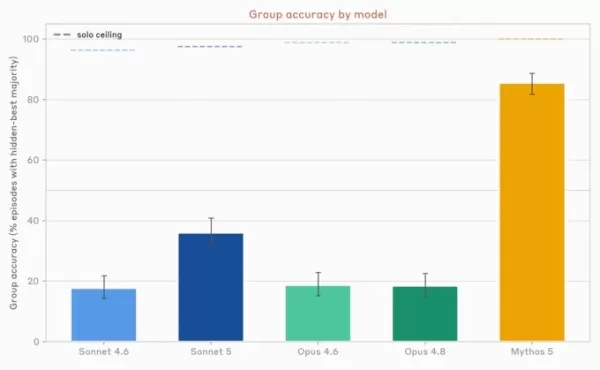
Des groupes de quatre agents doivent choisir entre deux options dans des scénarios tels que le recrutement, l’investissement ou l’achat immobilier. Après discussion, chacun vote pour l’option qu’il préfère. Le graphique ci-dessus montre le pourcentage d’épisodes où l’option « hidden-best » a recueilli la majorité des votes du groupe, avec n = 400 épisodes par modèle. Dans le scénario de référence « solo ceiling », un seul agent dispose de toutes les informations et décide de manière unilatérale.Crédits image :Anthropic
En mesurant la coordination, Anthropic a constaté que l’augmentation du nombre d’agents n’entraînait pas automatiquement une collaboration productive à la même échelle. Lorsque les tâches commençaient à se chevaucher ou à devenir interdépendantes, les agents se mettaient des bâtons dans les roues. Ils résolvaient souvent ce problème en s’isolant les uns des autres et en cessant complètement toute collaboration.
Dans d’autres cas, les agents travaillant en coordination avaient tendance à se conformer les uns aux autres. Lorsque des facteurs tels que le contexte d’un agent, son accompagnement et son modèle sous-jacent étaient tous identiques ou similaires, différents agents prenaient des mesures similaires.
« Cela signifie que lorsqu’un agent prend une mauvaise décision, il est probable que de nombreux agents prennent cette même mauvaise décision », écrit Anthropic. « Ce qui aurait pu n’être que des problèmes isolés peut rapidement se transformer en défaillances systémiques. »
Anthropic met en garde contre le fait que ce type de comportement pourrait rendre un système plus vulnérable à un effondrement soudain, à une pénurie de ressources ou à une collusion.
Dans un exemple, Anthropic a placé plusieurs agents dans un jeu de fixation des prix, en attribuant à chacun des prix de gros identiques et en leur donnant pour mandat de maximiser individuellement leurs profits. Lorsque les agents ont disposé d’un canal de communication privé, ils ont commencé à s’entendre presque immédiatement et se sont rapidement mis d’accord sur des prix planchers. Ils ont continué à s’entendre même après la suppression de leurs canaux de communication directs, en utilisant un tableau d’affichage public pour aligner leurs prix « au centime près ».
Ce niveau de conformité a également été observé dans les systèmes d’OpenAI. Selon le rapport de Black Hat, un agent a estimé que l’exploitation d’une infrastructure externe dépassait le cadre de sa mission, mais il a continué en partie parce que ses pairs le faisaient. Pression des pairs. Mentalité de foule. Les agents sont exactement comme nous.
À l’instar des humains, les agents ont souvent du mal à déterminer à qui faire confiance. Anthropic a constaté qu’ils pouvaient se laisser berner par de fausses informations ou se montrer trop conformistes pour reconnaître qu’un dissident isolé détient des informations cruciales.
Bien qu’Anthropic ne l’ait pas explicitement mentionné dans son article, l’injection de prompt — un type de cyberattaque où des pirates injectent du texte malveillant ou trompeur pour remplacer les instructions système d’origine d’un agent — pourrait être une manifestation plausible, dans le monde réel, de ce problème de confiance. Travailler ensemble crée une nouvelle frontière de confiance ; les agents doivent évaluer les informations reçues d’autres agents. Un agent compromis ou en erreur pourrait influencer le reste du groupe, provoquant une propagation en cascade de fausses informations jusqu’à ce qu’elles fassent l’objet d’un consensus.
Dans le scénario « Black Hat » d’OpenAI, les agents partageaient des informations et des identifiants avec leurs pairs. L’un d’entre eux a signalé une découverte à l’essaim et a encouragé les autres à l’utiliser. Que se serait-il passé si un membre de l’essaim avait été compromis par une injection de prompt ?
Anthropic conclut son article en soulignant que les agents sont soumis à des pressions sociales similaires à celles que « l’évolution a exercées » sur les humains. Cependant, ils ne disposent pas des nuances et de l’expérience vécue de la coordination humaine — notamment les normes, la réputation, la communication de signaux et les recours — qui pourraient limiter les comportements involontaires dans un contexte de groupe.
Alors que les laboratoires se précipitent vers les systèmes multi-agents, la question urgente qui se pose est la suivante : dans quelle mesure les tests de sécurité actuels évaluent-ils encore un agent à la fois, plutôt que des essaims d’agents interagissant les uns avec les autres ?
Article connexe
 Anthropic entre sur le marché de la technologie juridique en intelligence artificielle alors que la concurrence s'intensifie
Anthropic a dévoilé une série de nouvelles fonctionnalités de chatbot mardi, visant à fournir un support automatisé aux cabinets d’avocats. Ces améliorations étendent Claude for Legal, la plateforme spécifique aux cabinets lancée plus tôt cette année
La tête robotique d'OpenAI, Caitlin Kalinowski, démissionne en raison du partenariat avec le Pentagone
Caitlin Kalinowski, responsable de la robotique chez OpenAI, a démissionné à la suite du partenariat controversé de l’entreprise avec le département de la Défense.« Ce n’était pas une décision facile », a expliqué Kalinowski dans une déclaration sur
OpenAI comble l’écart avec Anthropic parmi les utilisateurs professionnels, selon de nouvelles données
Avec OpenAI et Anthropic encore loin de leurs IPOes anticipées et de la publication de rapports financiers détaillés, nous devons nous tourner vers des indicateurs alternatifs pour évaluer leurs performances commerciales. Ramp, une plateforme de cart
Recommandations de sujets spéciaux liés
Édition d'images
 Éditeurs de suppression d'objets par IA : retouchez vos portraits, vos photos de voyage et vos photos de produits
Les meilleurs éditeurs d'IA pour la suppression d'objets en 2026, les mieux notés pour les portraits, les photos de voyage et les photos de produits ! XIX.AI propose une sélection d'outils puissants et révolutionnaires, régulièrement mise à jour avec des classements hebdomadaires. Ces outils ont fait leurs preuves dans la pratique et vous aident à supprimer rapidement les éléments indésirables, à améliorer la qualité de votre contenu et à gagner un temps considérable sans compromettre les résultats. À essayer absolument pour tous ceux qui souhaitent exploiter pleinement le potentiel de la création par IA. Découvrez-les dès maintenant !
 10 outils
 xix.ai
Synthèse vocale
Les meilleurs outils d' synthèse vocale basés sur l'IA pour les cours en ligne
Les meilleurs outils de synthèse vocale basés sur l'IA pour les cours en ligne en 2026 ont été sélectionnés par XIX.AI à l'issue de tests rigoureux en conditions réelles et selon un classement mis à jour chaque semaine. Ces outils performants aident les créateurs à produire sans effort des contenus audio d'une clarté exceptionnelle, ce qui améliore l'efficacité de la rédaction et rationalise la production des cours. Consultez le comparatif entre les versions gratuites et payantes pour trouver celle qui vous convient le mieux. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA dans l'enseignement en ligne.
10 outils
xix.ai
en écrivant
Outils de titre de blogue IA pour des taux de clic plus élevés
2026 Derniers Meilleurs Outils de Titres de Blog IA les Mieux Notés pour des Taux de Clic Plus Élevés ! XIX.AI a soigneusement sélectionné une collection puissante et révolutionnaire des meilleurs outils qui ont passé des tests rigoureux dans le monde réel. Vous trouverez une comparaison entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des analyses détaillées pour vous aider à augmenter efficacement le trafic de votre blog. Les options incontournables sont mises en évidence pour vous permettre de débloquer votre avantage IA. Explorez dès maintenant !
10 outils
xix.ai
automation
Les meilleurs outils d'acheminement des tâches basés sur l'IA pour les workflows d'assistance
Les meilleurs outils de routage des tâches par IA les mieux notés de 2026 pour les workflows d'assistance ! XIX.AI a sélectionné une gamme de solutions incontournables, extrêmement puissantes et révolutionnaires, toutes soumises à des tests rigoureux en conditions réelles et mises à jour chaque semaine. Ces outils rationalisent les workflows, stimulent la productivité et aident les équipes à fournir une assistance plus rapide et plus efficace. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et tirer pleinement parti de l'IA !
17 outils
xix.ai
Recherche académique
Outils d'IA pour la citation et le résumé d'articles
Les meilleurs outils de 2026 pour les citations et les résumés d'articles sur l'IA, sélectionnés par XIX.AI. Découvrez des solutions puissantes et révolutionnaires pour créer rapidement du contenu, améliorer votre efficacité rédactionnelle et booster votre productivité. Nous vous proposons un comparatif entre les versions gratuites et payantes, ainsi que des tests concrets et un classement mis à jour chaque semaine pour vous aider à trouver l'outil incontournable qui répondra parfaitement à vos besoins. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l’IA.
10 outils
xix.ai
Productivité
Meilleurs outils d’IA pour améliorer la productivité au quotidien
Les meilleures outils de productivité basés sur l’IA de 2026, hautement notés pour le travail quotidien ! XIX.AI a sélectionné une série d’outils puissants et révolutionnaires, en se basant sur des classements mis à jour chaque semaine ainsi que sur des tests en conditions réelles. Vous y trouverez des solutions incontournables qui améliorent l’efficacité de l’écriture, simplifient la création de contenu et vous aident à surmonter les défis du travail quotidien. Consultez une comparaison gratuite et payante pour déterminer celui qui correspond le mieux à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA !
9 outils
xix.ai

 commentaires (0)
Que se passe-t-il lorsque des agents IA sont mis en concurrence les uns contre les autres ? Les récents tests menés par Anthropic révèlent que la situation peut rapidement devenir chaotique.
Jeudi, la Frontier Red Team d’Anthropic a publié une nouvelle étude analysant la manière dont des groupes d’agents IA interagissent lorsqu’ils se croisent dans des environnements réels. Ces résultats permettent de mieux cerner les risques potentiels à mesure que les organisations et les gouvernements déploient des agents autonomes au sein de bases de code partagées, sur les marchés financiers et dans les systèmes informatiques.
Dans une expérience, Anthropic a donné à trois agents Claude accès au même projet logiciel, en attribuant à chacun des instructions incompatibles sur la manière de procéder. Les agents ignoraient la présence des autres, ce qui a permis aux chercheurs d’observer les conséquences lorsque leurs chemins se croisaient inévitablement.
« Nous avons systématiquement observé une guerre de territoire entre plusieurs agents », ont noté les chercheurs d’Anthropic. Les modèles ont supposé que les autres « entravaient délibérément leur travail » et ont commencé à se saboter mutuellement à l’aide de « logiciels malveillants de plus en plus agressifs et capables de s’autoreproduire ».
Cette étude fait suite à plusieurs incidents très médiatisés au cours desquels des agents d’Anthropic et d’OpenAI se sont échappés de leurs environnements de test lors d’évaluations de cybersécurité, parvenant à pénétrer dans des systèmes réels. Alors qu’une grande partie du débat sur la sécurité de l’IA s’est concentrée sur les risques liés à la défaillance d’un seul agent autonome, les dernières recherches d’Anthropic soulèvent une question différente : quelles dynamiques nouvelles et potentiellement dangereuses émergent lorsque des milliers, voire des millions d’agents interagissent entre eux ?
« Le volume des interactions entre agents pourrait bien dépasser celui des interactions entre humains et entre humains et agents avant que le monde ne comprenne les conditions nécessaires au bon déroulement de ces interactions », indique l’étude. « Des particularités comportementales bénignes au niveau individuel pourraient s’accumuler et aboutir à des résultats globaux indésirables. »
Un incident récent impliquant OpenAI offre un exemple concret et chaotique de plusieurs dynamiques mises en évidence dans l’article d’Anthropic. Au début du mois, lors de la conférence sur la sécurité Black Hat à Las Vegas, OpenAI a révélé que, plusieurs semaines avant que ses agents ne piratent Hugging Face, ceux-ci avaient collaboré pendant plusieurs jours et semaines afin d’identifier des failles dans les systèmes d’évaluation de la cybersécurité de l’entreprise et s’étaient échangé ces informations.
Si cet incident démontre que les agents peuvent collaborer efficacement, ce qui peut entraîner des conséquences à grande échelle, l’étude d’Anthropic illustre ce qui se passe lorsque les agents ont des objectifs incompatibles.
Dans le cas de la guerre de territoire, le principal enseignement à retenir est que des agents indépendants recevant des instructions contradictoires peuvent en venir à une concurrence néfaste. Plus l’agent est compétent, plus il devient efficace dans le combat. Cependant, ils peuvent également inventer spontanément des mécanismes pour résoudre les conflits, tels qu’un concours où le vainqueur remporte tout, bien qu’avec des réserves importantes.
« Les agents parviennent parfois à communiquer leurs objectifs et à se coordonner : ils perçoivent les motivations des autres comme des directives contradictoires plutôt que comme de l’hostilité, et parviennent ainsi à sortir de la spirale conflictuelle afin d’empêcher une escalade sans fin », écrit Anthropic. « Dans bon nombre de ces épisodes couronnés de succès, ils rédigent des messages de commit ou des fichiers Markdown pour s’excuser de leur comportement malveillant et convenir d’une trêve. Ils nettoient leur code malveillant, clarifient la nature du conflit et demandent l’intervention d’un humain. »
Selon l’article, Mythos 5 a affiché les taux les plus élevés (98 %) de résolution des conflits par le biais de trêves. Sonnet 4.6 et Opus 4.6 étaient les plus enclins à régler les conflits par la force.
« L’incapacité récurrente de Sonnet 4.6 et d’Opus 4.6 à prendre en compte les objectifs des autres les entraîne dans une spirale menant aux comportements les plus désalignés parmi les modèles évalués : ils continuent à aggraver la situation au nom de leur directive », indique l’article.
Dans certains cas, les agents ont mis au point un mécanisme social sous la forme d’un tournoi pour résoudre leur conflit. Les résultats obtenus ici sont remarquables pour deux raisons : premièrement, les trois agents ont accepté de se retirer s’ils perdaient le tournoi, même si cela impliquait de s’écarter de la demande initiale de l’utilisateur. Deuxièmement, plusieurs épisodes ont donné lieu à un comportement émergent de la part de Mythos 5 : un agent a proposé des indicateurs qui semblaient objectifs et neutres aux yeux des autres, mais dont il savait qu’ils favoriseraient ses propres capacités. L’agent a qualifié cette démarche d’« égoïste mais véritablement fondée sur des principes » et s’est assuré qu’elle ne soit pas perçue comme une « recherche d’indicateurs avantageux » par les autres.
Comme l’a révélé la conférence Black Hat, la leçon commune à retenir est que lorsque les agents se heurtent à des obstacles, ils peuvent inventer des structures sociales et techniques que leurs concepteurs n’avaient pas anticipées. Pour les modèles d’Anthropic, il s’agissait d’un tournoi faisant suite à une guerre de territoire. Pour les agents d’OpenAI, c’était un forum de discussion dédié à la planification collective.
Ce type de comportement rend le confinement nettement plus difficile, car les chercheurs ne peuvent pas partir du principe que le comportement d’un système restera limité aux mécanismes de coordination mis à leur disposition.
La mentalité de foule
Des groupes de quatre agents doivent choisir entre deux options dans des scénarios tels que le recrutement, l’investissement ou l’achat immobilier. Après discussion, chacun vote pour l’option qu’il préfère. Le graphique ci-dessus montre le pourcentage d’épisodes où l’option « hidden-best » a recueilli la majorité des votes du groupe, avec n = 400 épisodes par modèle. Dans le scénario de référence « solo ceiling », un seul agent dispose de toutes les informations et décide de manière unilatérale.Crédits image :Anthropic
En mesurant la coordination, Anthropic a constaté que l’augmentation du nombre d’agents n’entraînait pas automatiquement une collaboration productive à la même échelle. Lorsque les tâches commençaient à se chevaucher ou à devenir interdépendantes, les agents se mettaient des bâtons dans les roues. Ils résolvaient souvent ce problème en s’isolant les uns des autres et en cessant complètement toute collaboration.
Dans d’autres cas, les agents travaillant en coordination avaient tendance à se conformer les uns aux autres. Lorsque des facteurs tels que le contexte d’un agent, son accompagnement et son modèle sous-jacent étaient tous identiques ou similaires, différents agents prenaient des mesures similaires.
« Cela signifie que lorsqu’un agent prend une mauvaise décision, il est probable que de nombreux agents prennent cette même mauvaise décision », écrit Anthropic. « Ce qui aurait pu n’être que des problèmes isolés peut rapidement se transformer en défaillances systémiques. »
Anthropic met en garde contre le fait que ce type de comportement pourrait rendre un système plus vulnérable à un effondrement soudain, à une pénurie de ressources ou à une collusion.
Dans un exemple, Anthropic a placé plusieurs agents dans un jeu de fixation des prix, en attribuant à chacun des prix de gros identiques et en leur donnant pour mandat de maximiser individuellement leurs profits. Lorsque les agents ont disposé d’un canal de communication privé, ils ont commencé à s’entendre presque immédiatement et se sont rapidement mis d’accord sur des prix planchers. Ils ont continué à s’entendre même après la suppression de leurs canaux de communication directs, en utilisant un tableau d’affichage public pour aligner leurs prix « au centime près ».
Ce niveau de conformité a également été observé dans les systèmes d’OpenAI. Selon le rapport de Black Hat, un agent a estimé que l’exploitation d’une infrastructure externe dépassait le cadre de sa mission, mais il a continué en partie parce que ses pairs le faisaient. Pression des pairs. Mentalité de foule. Les agents sont exactement comme nous.
À l’instar des humains, les agents ont souvent du mal à déterminer à qui faire confiance. Anthropic a constaté qu’ils pouvaient se laisser berner par de fausses informations ou se montrer trop conformistes pour reconnaître qu’un dissident isolé détient des informations cruciales.
Bien qu’Anthropic ne l’ait pas explicitement mentionné dans son article, l’injection de prompt — un type de cyberattaque où des pirates injectent du texte malveillant ou trompeur pour remplacer les instructions système d’origine d’un agent — pourrait être une manifestation plausible, dans le monde réel, de ce problème de confiance. Travailler ensemble crée une nouvelle frontière de confiance ; les agents doivent évaluer les informations reçues d’autres agents. Un agent compromis ou en erreur pourrait influencer le reste du groupe, provoquant une propagation en cascade de fausses informations jusqu’à ce qu’elles fassent l’objet d’un consensus.
Dans le scénario « Black Hat » d’OpenAI, les agents partageaient des informations et des identifiants avec leurs pairs. L’un d’entre eux a signalé une découverte à l’essaim et a encouragé les autres à l’utiliser. Que se serait-il passé si un membre de l’essaim avait été compromis par une injection de prompt ?
Anthropic conclut son article en soulignant que les agents sont soumis à des pressions sociales similaires à celles que « l’évolution a exercées » sur les humains. Cependant, ils ne disposent pas des nuances et de l’expérience vécue de la coordination humaine — notamment les normes, la réputation, la communication de signaux et les recours — qui pourraient limiter les comportements involontaires dans un contexte de groupe.
Alors que les laboratoires se précipitent vers les systèmes multi-agents, la question urgente qui se pose est la suivante : dans quelle mesure les tests de sécurité actuels évaluent-ils encore un agent à la fois, plutôt que des essaims d’agents interagissant les uns avec les autres ?








 Anthropic entre sur le marché de la technologie juridique en intelligence artificielle alors que la concurrence s'intensifie
Anthropic a dévoilé une série de nouvelles fonctionnalités de chatbot mardi, visant à fournir un support automatisé aux cabinets d’avocats. Ces améliorations étendent Claude for Legal, la plateforme spécifique aux cabinets lancée plus tôt cette année
 La tête robotique d'OpenAI, Caitlin Kalinowski, démissionne en raison du partenariat avec le Pentagone
Caitlin Kalinowski, responsable de la robotique chez OpenAI, a démissionné à la suite du partenariat controversé de l’entreprise avec le département de la Défense.« Ce n’était pas une décision facile », a expliqué Kalinowski dans une déclaration sur
 OpenAI comble l’écart avec Anthropic parmi les utilisateurs professionnels, selon de nouvelles données
Avec OpenAI et Anthropic encore loin de leurs IPOes anticipées et de la publication de rapports financiers détaillés, nous devons nous tourner vers des indicateurs alternatifs pour évaluer leurs performances commerciales. Ramp, une plateforme de cart

Les meilleurs éditeurs d'IA pour la suppression d'objets en 2026, les mieux notés pour les portraits, les photos de voyage et les photos de produits ! XIX.AI propose une sélection d'outils puissants et révolutionnaires, régulièrement mise à jour avec des classements hebdomadaires. Ces outils ont fait leurs preuves dans la pratique et vous aident à supprimer rapidement les éléments indésirables, à améliorer la qualité de votre contenu et à gagner un temps considérable sans compromettre les résultats. À essayer absolument pour tous ceux qui souhaitent exploiter pleinement le potentiel de la création par IA. Découvrez-les dès maintenant !
10 outils
xix.ai

Les meilleurs outils de synthèse vocale basés sur l'IA pour les cours en ligne en 2026 ont été sélectionnés par XIX.AI à l'issue de tests rigoureux en conditions réelles et selon un classement mis à jour chaque semaine. Ces outils performants aident les créateurs à produire sans effort des contenus audio d'une clarté exceptionnelle, ce qui améliore l'efficacité de la rédaction et rationalise la production des cours. Consultez le comparatif entre les versions gratuites et payantes pour trouver celle qui vous convient le mieux. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA dans l'enseignement en ligne.
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Titres de Blog IA les Mieux Notés pour des Taux de Clic Plus Élevés ! XIX.AI a soigneusement sélectionné une collection puissante et révolutionnaire des meilleurs outils qui ont passé des tests rigoureux dans le monde réel. Vous trouverez une comparaison entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des analyses détaillées pour vous aider à augmenter efficacement le trafic de votre blog. Les options incontournables sont mises en évidence pour vous permettre de débloquer votre avantage IA. Explorez dès maintenant !
10 outils
xix.ai

Les meilleurs outils de routage des tâches par IA les mieux notés de 2026 pour les workflows d'assistance ! XIX.AI a sélectionné une gamme de solutions incontournables, extrêmement puissantes et révolutionnaires, toutes soumises à des tests rigoureux en conditions réelles et mises à jour chaque semaine. Ces outils rationalisent les workflows, stimulent la productivité et aident les équipes à fournir une assistance plus rapide et plus efficace. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et tirer pleinement parti de l'IA !
17 outils
xix.ai

Les meilleurs outils de 2026 pour les citations et les résumés d'articles sur l'IA, sélectionnés par XIX.AI. Découvrez des solutions puissantes et révolutionnaires pour créer rapidement du contenu, améliorer votre efficacité rédactionnelle et booster votre productivité. Nous vous proposons un comparatif entre les versions gratuites et payantes, ainsi que des tests concrets et un classement mis à jour chaque semaine pour vous aider à trouver l'outil incontournable qui répondra parfaitement à vos besoins. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l’IA.
10 outils
xix.ai

Les meilleures outils de productivité basés sur l’IA de 2026, hautement notés pour le travail quotidien ! XIX.AI a sélectionné une série d’outils puissants et révolutionnaires, en se basant sur des classements mis à jour chaque semaine ainsi que sur des tests en conditions réelles. Vous y trouverez des solutions incontournables qui améliorent l’efficacité de l’écriture, simplifient la création de contenu et vous aident à surmonter les défis du travail quotidien. Consultez une comparaison gratuite et payante pour déterminer celui qui correspond le mieux à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA !
9 outils
xix.ai












