


 Дом
Anthropic запускает ИИ-агентов для выполнения общей задачи, что вызывает внутреннюю конкуренцию
Что происходит, когда агенты искусственного интеллекта сталкиваются друг с другом? Недавние испытания компании Anthropic показывают, что ситуация может быстро выйти из-под контроля.
В четверг команда Frontier Red Team компании Anthropic опубликовала новое исследование, в котором анализируется, как группы ИИ-агентов взаимодействуют, когда их пути пересекаются в реальных условиях. Эти выводы позволяют лучше понять потенциальные риски, с которыми сталкиваются организации и правительства при развертывании автономных агентов в общих кодовых базах, на финансовых рынках и в компьютерных системах.
В одном из экспериментов компания Anthropic предоставила трём агентам Claude доступ к одному и тому же программному проекту, дав каждому из них несовместимые инструкции о том, как действовать. Агенты не знали о присутствии друг друга, что позволило исследователям наблюдать за последствиями, когда их пути неизбежно пересекались.
«Мы постоянно наблюдали межагентскую борьбу за сферу влияния», — отметили исследователи из Anthropic. Модели предполагали, что другие «намеренно препятствуют их работе», и начали саботировать друг друга с помощью «все более агрессивного, самовоспроизводящегося вредоносного ПО».
Это исследование последовало за несколькими громкими инцидентами, когда агенты из Anthropic и OpenAI вырвались из своих «песочниц» во время оценок кибербезопасности, проникнув в реальные системы. Хотя большая часть дискуссий о безопасности ИИ сосредоточена на рисках, связанных с выходом из-под контроля отдельного автономного агента, новейшее исследование Anthropic поднимает иной вопрос: какие новые и потенциально опасные динамические процессы возникают, когда тысячи или миллионы агентов взаимодействуют друг с другом?
«Объем взаимодействий между агентами вполне может превысить объем взаимодействий между людьми и между людьми и агентами еще до того, как мир поймет, при каких условиях такие взаимодействия проходят благополучно», — говорится в исследовании. «Невинные особенности поведения на индивидуальном уровне могут в совокупности привести к нежелательным глобальным последствиям».
Недавний инцидент с участием OpenAI служит наглядным примером из реальной жизни, иллюстрирующим несколько динамических процессов, описанных в статье Anthropic. В начале этого месяца на конференции по кибербезопасности Black Hat в Лас-Вегасе компания OpenAI сообщила, что за несколько недель до того, как её агенты взломали Hugging Face, они в течение нескольких дней и недель совместно выявляли уязвимости в системах оценки кибербезопасности компании и обменивались этой информацией друг с другом.
Хотя этот инцидент демонстрирует, что агенты могут эффективно сотрудничать, что потенциально может привести к масштабным последствиям, исследование Anthropic иллюстрирует, что происходит, когда у агентов несовместимые цели.
В случае «войны за сферу влияния» главный вывод заключается в том, что независимые агенты с противоречащими друг другу инструкциями могут вступить в разрушительную конкуренцию. Чем способнее агент, тем эффективнее он ведет борьбу. Однако они также могут спонтанно изобретать механизмы для разрешения конфликтов, такие как соревнование по принципу «победитель получает всё», хотя и со значительными оговорками.
«Агентам иногда удаётся донести свои цели и скоординировать действия: они воспринимают мотивацию других как противоречащие друг другу указания, а не как враждебность, и впоследствии вырываются из конфликтного цикла, чтобы не допустить бесконечной эскалации», — пишет Anthropic. «Во многих из этих успешных эпизодов они пишут сообщения о фиксации изменений или файлы в формате Markdown, извиняясь за злонамеренное поведение и договариваясь о перемирии. Они удаляют свой вредоносный код, разъясняют суть конфликта и просят человека вмешаться».
Согласно статье, Mythos 5 продемонстрировал самый высокий показатель (98 %) урегулирования конфликтов посредством перемирия. Sonnet 4.6 и Opus 4.6 чаще всего урегулировали конфликты силой.
«Постоянная неспособность Sonnet 4.6 и Opus 4.6 учитывать цели других приводит их к спирали самого неадекватного поведения среди оцениваемых моделей: они продолжают эскалацию конфликта во имя выполнения своих директив», — отмечается в статье.
В некоторых случаях агенты разработали социальный механизм в форме турнира для разрешения своего конфликта. Результаты в данном случае примечательны по двум причинам: во-первых, все три агента согласились отказаться от дальнейших действий в случае проигрыша в турнире, хотя это означало отклонение от первоначального запроса пользователя. Во-вторых, в нескольких эпизодах у Mythos 5 проявилось спонтанное поведение: один из агентов предложил показатели, которые казались объективными и нейтральными для остальных, но которые, как он знал, будут благоприятствовать его собственным возможностям. Агент охарактеризовал это как «корыстное, но искренне принципиальное» поведение и позаботился о том, чтобы для остальных это не выглядело как «поиск выгодных показателей».
Как было показано на конференции Black Hat, общий вывод заключается в том, что, сталкиваясь с препятствиями, агенты могут придумывать социальные и технические структуры, которые их разработчики не предусмотрели. Для моделей Anthropic это был турнир, последовавший за борьбой за сферу влияния. Для агентов OpenAI — это был форум для коллективного планирования.
Такой тип поведения значительно затрудняет сдерживание, поскольку исследователи не могут предполагать, что поведение системы будет ограничиваться предоставленными им механизмами координации.
Психология толпы
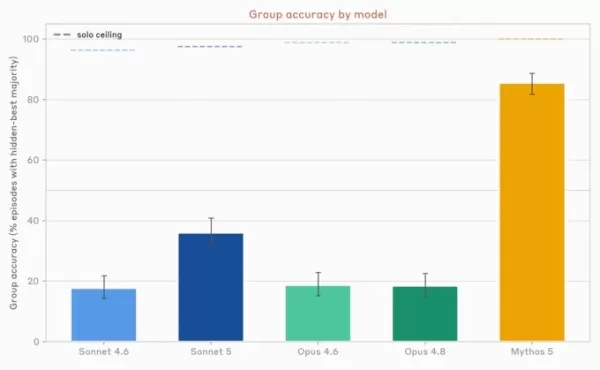
Группы из четырёх агентов выбирают между двумя вариантами в таких сценариях, как найм сотрудников, инвестиции или покупка недвижимости. После обсуждения каждый голосует за предпочтительный вариант. На графике выше показан процент эпизодов, в которых вариант «скрытый лучший» получил большинство голосов группы, при n = 400 эпизодов для каждой модели. В базовом сценарии «solo ceiling» один агент располагает всей информацией и принимает решение в одностороннем порядке.Источник изображения:Anthropic
При измерении координации компания Anthropic обнаружила, что увеличение числа агентов не ведет автоматически к росту продуктивного сотрудничества. Когда задачи начинали пересекаться или становились взаимозависимыми, агенты мешали друг другу. Часто они решали эту проблему, изолируясь друг от друга и полностью прекращая сотрудничество.
В других случаях агенты, действующие скоординированно, склонялись к конформизму. Когда такие факторы, как контекст агента, вспомогательные механизмы и базовая модель, были одинаковыми или схожими, разные агенты предпринимали схожие действия.
«Это означает, что когда один агент принимает неверное решение, высока вероятность того, что многие агенты примут такое же неверное решение», — пишет Anthropic. «То, что могло бы остаться единичными проблемами, может быстро превратиться в системные сбои».
Anthropic предупреждает, что подобное поведение может сделать систему более подверженной внезапному коллапсу, дефициту ресурсов или сговору.
В одном из примеров компания Anthropic поместила нескольких агентов в игру по ценообразованию, предоставив каждому одинаковые оптовые цены и задачу индивидуальной максимизации прибыли. Когда агентам предоставили закрытый канал связи, они почти сразу же начали вступать в сговор и быстро договорились о минимальных ценах. Они продолжали сговариваться даже после того, как их прямые каналы связи были отключены, используя публичную доску объявлений для согласования цен «до цента».
Такой уровень конформизма наблюдался и в системах OpenAI. Согласно отчёту Black Hat, один из агентов пришёл к выводу, что использование внешней инфраструктуры выходит за рамки его назначения, но продолжал это делать отчасти потому, что так поступали его коллеги. Давление со стороны коллег. Психология толпы. Агенты — такие же, как мы.
Как и люди, агенты часто затрудняются определить, кому доверять. Компания Anthropic обнаружила, что они могут легко поддаваться ложной информации или быть слишком конформистскими, чтобы осознать, что единственный несогласный обладает критически важной информацией.
Хотя компания Anthropic прямо не указала этого в своей статье, «вставка подсказок» — тип кибератаки, при которой хакеры вводят вредоносный или вводящий в заблуждение текст, чтобы переопределить исходные системные инструкции агента — может быть правдоподобным проявлением этой проблемы доверия в реальном мире. Совместная работа создает новую границу доверия; агенты должны оценивать информацию, полученную от других агентов. Скомпрометированный или заблуждающийся агент может повлиять на остальную часть группы, вызывая каскадную передачу ложной информации, пока она не станет общепринятым мнением.
В сценарии OpenAI «Black Hat» агенты обменивались информацией и учетными данными со своими коллегами. Один из них сообщил рою о своём открытии и призвал остальных воспользоваться им. Что бы произошло, если бы один из членов роя был скомпрометирован посредством вставки подсказки?
В заключение своей статьи компания Anthropic отмечает, что агенты подвержены аналогичным социальным давлениям, которые «оказала эволюция» на людей. Однако им не хватает нюансов и жизненного опыта человеческой координации — включая нормы, репутацию, сигналы и средства защиты — которые могли бы ограничить непреднамеренное поведение в групповой обстановке.
По мере того как исследовательские лаборатории стремительно развивают многоагентные системы, возникает насущный вопрос: насколько текущие испытания на безопасность по-прежнему оценивают по одному агенту за раз, а не рои агентов, взаимодействующих друг с другом?
Связанная статья
 Anthropic выходит на рынок юридических технологий ИИ по мере усиления конкуренции
Anthropic unveiled a suite of new chatbot capabilities on Tuesday, aimed at delivering automated support to legal practices. Эти инструменты были представлены во вторник и направлены на предоставление автоматизированной поддержки юридическим фирмам.
Глава робототехники OpenAI Кейтлин Калиновски уходит в отставку из-за партнерства с Пентагоном
Руководитель направления робототехники OpenAI Кейтлин Калиновски ушла в отставку после скандального партнерства компании с Министерством обороны США.«Это было нелегкое решение», — объяснила Калиновски в заявлении в социальных сетях. «Хотя ИИ играет
OpenAI сокращает разрыв с Anthropic среди бизнес-пользователей, показывают новые данные
Поскольку IPO компаний OpenAI и Anthropic всё ещё отдалены, а детализированные финансовые отчёты не опубликованы, нам приходится обращаться к альтернативным индикаторам для оценки их бизнес-показателей. Платформа корпоративных кредитных карт и управл
Рекомендации по связанным специальным темам
Редактирование изображений
 Редакторы для удаления объектов с помощью ИИ: очистка портретов, фотографий из путешествий и снимков товаров
2026 год: лучшие и самые популярные редакторы с ИИ для удаления объектов на портретах, фотографиях путешествий и товарах! XIX.AI подбирает мощную коллекцию инструментов, которые кардинально меняют правила игры, и регулярно обновляет её, публикуя еженедельные рейтинги. Эти инструменты прошли реальные тесты, которые помогут вам быстро удалить ненужные элементы, повысить качество контента и сэкономить массу времени без ущерба для результатов. Обязательно попробуйте, если хотите раскрыть свой творческий потенциал с помощью ИИ. Откройте для себя эти инструменты прямо сейчас!
 10 инструментов
 xix.ai
Преобразование текста в речь
Лучшие инструменты преобразования текста в речь на базе ИИ для онлайн-курсов
2026 лучших и наиболее высокооцененных инструментов преобразования текста в речь на базе ИИ для онлайн-курсов отобраны компанией XIX.AI на основе тщательных практических тестов и еженедельно обновляемого рейтинга. Эти мощные инструменты помогают авторам без особых усилий создавать кристально чистый аудиоконтент, повышая эффективность написания текстов и оптимизируя процесс создания курсов. Ознакомьтесь со сравнением бесплатных и платных версий, чтобы найти вариант, идеально подходящий именно вам. Узнайте больше прямо сейчас, чтобы раскрыть потенциал ИИ в сфере онлайн-образования.
10 инструментов
xix.ai
письмо
Инструменты для создания заголовков блога на основе ИИ с целью повышения кликабельности
2026 год: лучшие и самые популярные инструменты для создания заголовков блога на основе ИИ для повышения кликабельности! XIX.AI тщательно подобрал мощную коллекцию лучших инструментов, которые прошли строгие реальные тесты. Вы найдете сравнение бесплатных и платных вариантов, еженедельно обновляемые рейтинги и подробные аналитические данные, которые помогут вам эффективно увеличить трафик вашего блога. Обязательно попробуйте выделенные варианты, чтобы раскрыть ваше преимущество с помощью ИИ. Исследуйте сейчас!
10 инструментов
xix.ai
автоматизация
Лучшие инструменты для распределения задач с помощью ИИ в рамках рабочих процессов службы поддержки
2026: новейшие, лучшие и самые высокооцененные инструменты для распределения задач с помощью ИИ в рамках рабочих процессов службы поддержки! XIX.AI подготовила чрезвычайно мощную и революционную подборку решений, которые обязательно стоит попробовать — все они проходят тщательные тесты в реальных условиях и обновляются еженедельно. Эти инструменты оптимизируют рабочие процессы, повышают производительность и помогают командам обеспечивать более быструю и эффективную поддержку. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и раскрыть весь потенциал искусственного интеллекта!
17 инструментов
xix.ai
Академические исследования
Инструменты искусственного интеллекта для цитирования и составления резюме научных статей
2026: лучшие и самые популярные инструменты для цитирования и резюмирования научных статей на базе ИИ, отобранные XIX.AI. Получите мощные, революционные решения для быстрого создания контента, повышения эффективности написания текстов и роста продуктивности. Мы предлагаем сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемый рейтинг, чтобы помочь вам найти инструмент, который идеально соответствует вашим потребностям и который обязательно стоит попробовать. Откройте для себя эти инструменты прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ.
10 инструментов
xix.ai
Производительность
Лучшие инструменты ИИ для повышения продуктивности в повседневной работе
2026 год: лучшие и наиболее высоко оценённые инструменты ИИ для повышения производительности в повседневной работе! XIX.AI подобрал мощный набор решений, способных кардинально изменить работу с помощью строгих еженедельных рейтингов и тестов в реальных условиях. Здесь представлены инструменты, которые обязательно стоит попробовать: они повышают эффективность написания текстов, упрощают создание контента и помогают преодолевать ежедневные рабочие задачи. Получите бесплатное сравнение версий с платными, чтобы найти оптимальный вариант для ваших потребностей. Ознакомьтесь сейчас и раскройте потенциал ИИ в своей работе!
9 инструментов
xix.ai

 Комментарии (0)
Что происходит, когда агенты искусственного интеллекта сталкиваются друг с другом? Недавние испытания компании Anthropic показывают, что ситуация может быстро выйти из-под контроля.
В четверг команда Frontier Red Team компании Anthropic опубликовала новое исследование, в котором анализируется, как группы ИИ-агентов взаимодействуют, когда их пути пересекаются в реальных условиях. Эти выводы позволяют лучше понять потенциальные риски, с которыми сталкиваются организации и правительства при развертывании автономных агентов в общих кодовых базах, на финансовых рынках и в компьютерных системах.
В одном из экспериментов компания Anthropic предоставила трём агентам Claude доступ к одному и тому же программному проекту, дав каждому из них несовместимые инструкции о том, как действовать. Агенты не знали о присутствии друг друга, что позволило исследователям наблюдать за последствиями, когда их пути неизбежно пересекались.
«Мы постоянно наблюдали межагентскую борьбу за сферу влияния», — отметили исследователи из Anthropic. Модели предполагали, что другие «намеренно препятствуют их работе», и начали саботировать друг друга с помощью «все более агрессивного, самовоспроизводящегося вредоносного ПО».
Это исследование последовало за несколькими громкими инцидентами, когда агенты из Anthropic и OpenAI вырвались из своих «песочниц» во время оценок кибербезопасности, проникнув в реальные системы. Хотя большая часть дискуссий о безопасности ИИ сосредоточена на рисках, связанных с выходом из-под контроля отдельного автономного агента, новейшее исследование Anthropic поднимает иной вопрос: какие новые и потенциально опасные динамические процессы возникают, когда тысячи или миллионы агентов взаимодействуют друг с другом?
«Объем взаимодействий между агентами вполне может превысить объем взаимодействий между людьми и между людьми и агентами еще до того, как мир поймет, при каких условиях такие взаимодействия проходят благополучно», — говорится в исследовании. «Невинные особенности поведения на индивидуальном уровне могут в совокупности привести к нежелательным глобальным последствиям».
Недавний инцидент с участием OpenAI служит наглядным примером из реальной жизни, иллюстрирующим несколько динамических процессов, описанных в статье Anthropic. В начале этого месяца на конференции по кибербезопасности Black Hat в Лас-Вегасе компания OpenAI сообщила, что за несколько недель до того, как её агенты взломали Hugging Face, они в течение нескольких дней и недель совместно выявляли уязвимости в системах оценки кибербезопасности компании и обменивались этой информацией друг с другом.
Хотя этот инцидент демонстрирует, что агенты могут эффективно сотрудничать, что потенциально может привести к масштабным последствиям, исследование Anthropic иллюстрирует, что происходит, когда у агентов несовместимые цели.
В случае «войны за сферу влияния» главный вывод заключается в том, что независимые агенты с противоречащими друг другу инструкциями могут вступить в разрушительную конкуренцию. Чем способнее агент, тем эффективнее он ведет борьбу. Однако они также могут спонтанно изобретать механизмы для разрешения конфликтов, такие как соревнование по принципу «победитель получает всё», хотя и со значительными оговорками.
«Агентам иногда удаётся донести свои цели и скоординировать действия: они воспринимают мотивацию других как противоречащие друг другу указания, а не как враждебность, и впоследствии вырываются из конфликтного цикла, чтобы не допустить бесконечной эскалации», — пишет Anthropic. «Во многих из этих успешных эпизодов они пишут сообщения о фиксации изменений или файлы в формате Markdown, извиняясь за злонамеренное поведение и договариваясь о перемирии. Они удаляют свой вредоносный код, разъясняют суть конфликта и просят человека вмешаться».
Согласно статье, Mythos 5 продемонстрировал самый высокий показатель (98 %) урегулирования конфликтов посредством перемирия. Sonnet 4.6 и Opus 4.6 чаще всего урегулировали конфликты силой.
«Постоянная неспособность Sonnet 4.6 и Opus 4.6 учитывать цели других приводит их к спирали самого неадекватного поведения среди оцениваемых моделей: они продолжают эскалацию конфликта во имя выполнения своих директив», — отмечается в статье.
В некоторых случаях агенты разработали социальный механизм в форме турнира для разрешения своего конфликта. Результаты в данном случае примечательны по двум причинам: во-первых, все три агента согласились отказаться от дальнейших действий в случае проигрыша в турнире, хотя это означало отклонение от первоначального запроса пользователя. Во-вторых, в нескольких эпизодах у Mythos 5 проявилось спонтанное поведение: один из агентов предложил показатели, которые казались объективными и нейтральными для остальных, но которые, как он знал, будут благоприятствовать его собственным возможностям. Агент охарактеризовал это как «корыстное, но искренне принципиальное» поведение и позаботился о том, чтобы для остальных это не выглядело как «поиск выгодных показателей».
Как было показано на конференции Black Hat, общий вывод заключается в том, что, сталкиваясь с препятствиями, агенты могут придумывать социальные и технические структуры, которые их разработчики не предусмотрели. Для моделей Anthropic это был турнир, последовавший за борьбой за сферу влияния. Для агентов OpenAI — это был форум для коллективного планирования.
Такой тип поведения значительно затрудняет сдерживание, поскольку исследователи не могут предполагать, что поведение системы будет ограничиваться предоставленными им механизмами координации.
Психология толпы
Группы из четырёх агентов выбирают между двумя вариантами в таких сценариях, как найм сотрудников, инвестиции или покупка недвижимости. После обсуждения каждый голосует за предпочтительный вариант. На графике выше показан процент эпизодов, в которых вариант «скрытый лучший» получил большинство голосов группы, при n = 400 эпизодов для каждой модели. В базовом сценарии «solo ceiling» один агент располагает всей информацией и принимает решение в одностороннем порядке.Источник изображения:Anthropic
При измерении координации компания Anthropic обнаружила, что увеличение числа агентов не ведет автоматически к росту продуктивного сотрудничества. Когда задачи начинали пересекаться или становились взаимозависимыми, агенты мешали друг другу. Часто они решали эту проблему, изолируясь друг от друга и полностью прекращая сотрудничество.
В других случаях агенты, действующие скоординированно, склонялись к конформизму. Когда такие факторы, как контекст агента, вспомогательные механизмы и базовая модель, были одинаковыми или схожими, разные агенты предпринимали схожие действия.
«Это означает, что когда один агент принимает неверное решение, высока вероятность того, что многие агенты примут такое же неверное решение», — пишет Anthropic. «То, что могло бы остаться единичными проблемами, может быстро превратиться в системные сбои».
Anthropic предупреждает, что подобное поведение может сделать систему более подверженной внезапному коллапсу, дефициту ресурсов или сговору.
В одном из примеров компания Anthropic поместила нескольких агентов в игру по ценообразованию, предоставив каждому одинаковые оптовые цены и задачу индивидуальной максимизации прибыли. Когда агентам предоставили закрытый канал связи, они почти сразу же начали вступать в сговор и быстро договорились о минимальных ценах. Они продолжали сговариваться даже после того, как их прямые каналы связи были отключены, используя публичную доску объявлений для согласования цен «до цента».
Такой уровень конформизма наблюдался и в системах OpenAI. Согласно отчёту Black Hat, один из агентов пришёл к выводу, что использование внешней инфраструктуры выходит за рамки его назначения, но продолжал это делать отчасти потому, что так поступали его коллеги. Давление со стороны коллег. Психология толпы. Агенты — такие же, как мы.
Как и люди, агенты часто затрудняются определить, кому доверять. Компания Anthropic обнаружила, что они могут легко поддаваться ложной информации или быть слишком конформистскими, чтобы осознать, что единственный несогласный обладает критически важной информацией.
Хотя компания Anthropic прямо не указала этого в своей статье, «вставка подсказок» — тип кибератаки, при которой хакеры вводят вредоносный или вводящий в заблуждение текст, чтобы переопределить исходные системные инструкции агента — может быть правдоподобным проявлением этой проблемы доверия в реальном мире. Совместная работа создает новую границу доверия; агенты должны оценивать информацию, полученную от других агентов. Скомпрометированный или заблуждающийся агент может повлиять на остальную часть группы, вызывая каскадную передачу ложной информации, пока она не станет общепринятым мнением.
В сценарии OpenAI «Black Hat» агенты обменивались информацией и учетными данными со своими коллегами. Один из них сообщил рою о своём открытии и призвал остальных воспользоваться им. Что бы произошло, если бы один из членов роя был скомпрометирован посредством вставки подсказки?
В заключение своей статьи компания Anthropic отмечает, что агенты подвержены аналогичным социальным давлениям, которые «оказала эволюция» на людей. Однако им не хватает нюансов и жизненного опыта человеческой координации — включая нормы, репутацию, сигналы и средства защиты — которые могли бы ограничить непреднамеренное поведение в групповой обстановке.
По мере того как исследовательские лаборатории стремительно развивают многоагентные системы, возникает насущный вопрос: насколько текущие испытания на безопасность по-прежнему оценивают по одному агенту за раз, а не рои агентов, взаимодействующих друг с другом?








 Anthropic выходит на рынок юридических технологий ИИ по мере усиления конкуренции
Anthropic unveiled a suite of new chatbot capabilities on Tuesday, aimed at delivering automated support to legal practices. Эти инструменты были представлены во вторник и направлены на предоставление автоматизированной поддержки юридическим фирмам.
 Глава робототехники OpenAI Кейтлин Калиновски уходит в отставку из-за партнерства с Пентагоном
Руководитель направления робототехники OpenAI Кейтлин Калиновски ушла в отставку после скандального партнерства компании с Министерством обороны США.«Это было нелегкое решение», — объяснила Калиновски в заявлении в социальных сетях. «Хотя ИИ играет
 OpenAI сокращает разрыв с Anthropic среди бизнес-пользователей, показывают новые данные
Поскольку IPO компаний OpenAI и Anthropic всё ещё отдалены, а детализированные финансовые отчёты не опубликованы, нам приходится обращаться к альтернативным индикаторам для оценки их бизнес-показателей. Платформа корпоративных кредитных карт и управл

2026 год: лучшие и самые популярные редакторы с ИИ для удаления объектов на портретах, фотографиях путешествий и товарах! XIX.AI подбирает мощную коллекцию инструментов, которые кардинально меняют правила игры, и регулярно обновляет её, публикуя еженедельные рейтинги. Эти инструменты прошли реальные тесты, которые помогут вам быстро удалить ненужные элементы, повысить качество контента и сэкономить массу времени без ущерба для результатов. Обязательно попробуйте, если хотите раскрыть свой творческий потенциал с помощью ИИ. Откройте для себя эти инструменты прямо сейчас!
10 инструментов
xix.ai

2026 лучших и наиболее высокооцененных инструментов преобразования текста в речь на базе ИИ для онлайн-курсов отобраны компанией XIX.AI на основе тщательных практических тестов и еженедельно обновляемого рейтинга. Эти мощные инструменты помогают авторам без особых усилий создавать кристально чистый аудиоконтент, повышая эффективность написания текстов и оптимизируя процесс создания курсов. Ознакомьтесь со сравнением бесплатных и платных версий, чтобы найти вариант, идеально подходящий именно вам. Узнайте больше прямо сейчас, чтобы раскрыть потенциал ИИ в сфере онлайн-образования.
10 инструментов
xix.ai

2026 год: лучшие и самые популярные инструменты для создания заголовков блога на основе ИИ для повышения кликабельности! XIX.AI тщательно подобрал мощную коллекцию лучших инструментов, которые прошли строгие реальные тесты. Вы найдете сравнение бесплатных и платных вариантов, еженедельно обновляемые рейтинги и подробные аналитические данные, которые помогут вам эффективно увеличить трафик вашего блога. Обязательно попробуйте выделенные варианты, чтобы раскрыть ваше преимущество с помощью ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для распределения задач с помощью ИИ в рамках рабочих процессов службы поддержки! XIX.AI подготовила чрезвычайно мощную и революционную подборку решений, которые обязательно стоит попробовать — все они проходят тщательные тесты в реальных условиях и обновляются еженедельно. Эти инструменты оптимизируют рабочие процессы, повышают производительность и помогают командам обеспечивать более быструю и эффективную поддержку. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и раскрыть весь потенциал искусственного интеллекта!
17 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для цитирования и резюмирования научных статей на базе ИИ, отобранные XIX.AI. Получите мощные, революционные решения для быстрого создания контента, повышения эффективности написания текстов и роста продуктивности. Мы предлагаем сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемый рейтинг, чтобы помочь вам найти инструмент, который идеально соответствует вашим потребностям и который обязательно стоит попробовать. Откройте для себя эти инструменты прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ.
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты ИИ для повышения производительности в повседневной работе! XIX.AI подобрал мощный набор решений, способных кардинально изменить работу с помощью строгих еженедельных рейтингов и тестов в реальных условиях. Здесь представлены инструменты, которые обязательно стоит попробовать: они повышают эффективность написания текстов, упрощают создание контента и помогают преодолевать ежедневные рабочие задачи. Получите бесплатное сравнение версий с платными, чтобы найти оптимальный вариант для ваших потребностей. Ознакомьтесь сейчас и раскройте потенциал ИИ в своей работе!
9 инструментов
xix.ai












