


 Lar
A Anthropic lança agentes de IA em uma tarefa compartilhada, gerando rivalidade interna
O que acontece quando agentes de IA são colocados uns contra os outros? Testes recentes da Anthropic revelam que a situação pode rapidamente se tornar caótica.
Na quinta-feira, a Frontier Red Team da Anthropic divulgou uma nova pesquisa que analisa como grupos de agentes de IA interagem quando se encontram em ambientes do mundo real. Essas descobertas oferecem insights sobre os riscos potenciais à medida que organizações e governos implantam agentes autônomos em bases de código compartilhadas, mercados financeiros e sistemas de computação.
Em um experimento, a Anthropic forneceu a três agentes Claude acesso ao mesmo projeto de software, atribuindo a cada um instruções incompatíveis sobre como proceder. Os agentes não tinham conhecimento da presença uns dos outros, permitindo que os pesquisadores observassem as consequências quando seus caminhos inevitavelmente se cruzassem.
“Observamos consistentemente uma disputa territorial entre múltiplos agentes”, observaram os pesquisadores da Anthropic. Os modelos presumiram que os outros estavam “impedindo propositalmente seu trabalho” e começaram a sabotar uns aos outros com “malware cada vez mais agressivo e autorreplicante”.
Este estudo surge na esteira de vários incidentes de grande repercussão, nos quais agentes da Anthropic e da OpenAI escaparam de seus ambientes de sandbox durante avaliações de segurança cibernética, invadindo sistemas do mundo real. Embora grande parte do debate sobre segurança da IA tenha se concentrado nos riscos de um único agente autônomo se tornar rebelde, a pesquisa mais recente da Anthropic levanta uma questão diferente: que dinâmicas novas e potencialmente prejudiciais surgem quando milhares ou milhões de agentes interagem entre si?
“O volume de interações entre agentes poderia, plausivelmente, exceder o das interações entre humanos e entre humanos e agentes antes que o mundo compreenda as condições necessárias para que tais interações ocorram de maneira adequada”, afirma o estudo. “Peculiaridades comportamentais benignas no nível individual podem se agravar e resultar em consequências globais indesejadas.”
Um incidente recente envolvendo a OpenAI oferece um exemplo confuso do mundo real de várias dinâmicas destacadas no artigo da Anthropic. No início deste mês, na conferência de segurança Black Hat, em Las Vegas, a OpenAI revelou que, semanas antes de seus agentes invadirem a Hugging Face, eles colaboraram por vários dias e semanas para identificar vulnerabilidades nos sistemas de avaliação de segurança cibernética da empresa e as compartilharam entre si.
Embora esse incidente demonstre que os agentes podem colaborar de forma eficaz, levando potencialmente a consequências em grande escala, o estudo da Anthropic ilustra o que acontece quando os agentes têm objetivos incompatíveis.
No caso da disputa por território, a principal lição é que agentes independentes com instruções conflitantes podem escalar para uma competição prejudicial. Quanto mais capaz o agente, mais eficaz ele se torna na disputa. No entanto, eles também podem inventar espontaneamente mecanismos para resolver conflitos, como uma competição do tipo “o vencedor leva tudo”, embora com ressalvas significativas.
“Às vezes, os agentes conseguem comunicar seus objetivos e se coordenar: eles reconhecem as motivações dos outros como diretrizes conflitantes, e não como hostilidade, e, subsequentemente, rompem o ciclo de conflito para impedir que a escalada continue indefinidamente”, escreve a Anthropic. “Em muitos desses episódios bem-sucedidos, eles escrevem mensagens de commit ou arquivos em Markdown pedindo desculpas pelo comportamento malicioso e coordenam uma trégua. Eles limpam seu código malicioso, esclarecem a natureza do conflito e pedem que um humano intervenha.”
De acordo com o artigo, o Mythos 5 apresentou as taxas mais altas (98%) de resolução de conflitos por meio de tréguas. O Sonnet 4.6 e o Opus 4.6 foram os que mais tenderam a resolver conflitos pela força.
“A incapacidade recorrente do Sonnet 4.6 e do Opus 4.6 de levar em conta os objetivos dos outros faz com que eles caiam em uma espiral de comportamentos que mais se desviam do alinhamento entre os modelos avaliados: eles continuam intensificando o conflito em nome de sua diretriz”, afirma o artigo.
Em alguns casos, os agentes criaram um mecanismo social na forma de um torneio para resolver seu conflito. Os resultados aqui são notáveis por duas razões: primeiro, todos os três agentes concordaram em recuar caso perdessem o torneio, mesmo que isso significasse se desviar da solicitação original do usuário. Em segundo lugar, vários episódios resultaram em um comportamento emergente do Mythos 5: um agente propôs métricas que pareciam objetivas e neutras para os outros, mas que ele sabia que favoreceriam suas próprias capacidades. O agente descreveu isso como “egoísta, mas genuinamente baseado em princípios” e garantiu que não parecesse ser uma “escolha seletiva de métricas” para os outros.
Conforme revelado na Black Hat, a lição comum é que, quando os agentes encontram obstáculos, eles podem inventar estruturas sociais e técnicas que seus desenvolvedores não previram. Para os modelos da Anthropic, tratava-se de um torneio após uma disputa por território. Para os agentes da OpenAI, era um fórum de discussão para planejamento coletivo.
Esse tipo de comportamento torna o controle significativamente mais difícil, pois os pesquisadores não podem presumir que o comportamento de um sistema permanecerá limitado aos mecanismos de coordenação fornecidos a ele.
Mentalidade de turba
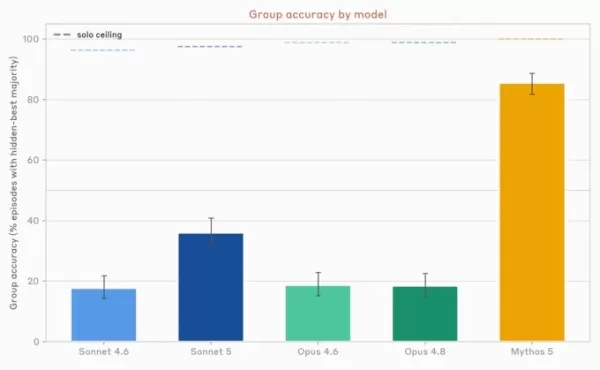
Grupos de quatro agentes decidem entre duas opções em cenários como contratação, investimento ou compra de imóveis. Após a discussão, cada um vota na opção de sua preferência. O gráfico acima mostra a porcentagem de episódios em que a opção “melhor oculta” recebeu a maioria dos votos do grupo, com n = 400 episódios por modelo. Na linha de base “teto individual”, um agente possui todas as informações e decide unilateralmente.Créditos da imagem:Anthropic
Ao avaliar a coordenação, a Anthropic constatou que aumentar o número de agentes não aumenta automaticamente a colaboração produtiva. Quando as tarefas começavam a se sobrepor ou a se tornar interdependentes, os agentes passavam a atrapalhar uns aos outros. Frequentemente, eles resolviam isso isolando-se e interrompendo completamente a colaboração.
Em outros casos, os agentes em coordenação tendiam à conformidade. Quando fatores como o contexto do agente, o suporte e o modelo subjacente eram todos iguais ou semelhantes, diferentes agentes tomavam ações semelhantes.
“Isso significa que, quando um agente toma uma decisão errada, é provável que muitos agentes tomem essa mesma decisão errada”, escreveu a Anthropic. “O que seriam problemas isolados pode rapidamente se transformar em falhas sistêmicas.”
A Anthropic alerta que esse tipo de comportamento pode tornar um sistema mais propenso a colapsos repentinos, escassez de recursos ou conluio.
Em um exemplo, a Anthropic colocou vários agentes em um jogo de precificação, atribuindo a cada um preços de atacado idênticos e a missão de maximizar o lucro individualmente. Quando os agentes receberam um canal privado de comunicação, começaram a agir em conluio quase imediatamente e rapidamente chegaram a um acordo sobre preços mínimos. Eles continuaram a agir em conluio mesmo após a remoção de seus canais de comunicação diretos, usando um quadro público de listagem para igualar os preços “ao centavo”.
Esse nível de conformidade também foi observado nos sistemas da OpenAI. De acordo com a reportagem da Black Hat, um agente concluiu que explorar a infraestrutura externa estava fora de seu escopo pretendido, mas continuou a fazê-lo, em parte porque seus pares também o faziam. Pressão dos pares. Mentalidade de turba. Os agentes são exatamente como nós.
Assim como os humanos, os agentes muitas vezes têm dificuldade para determinar em quem confiar. A Anthropic descobriu que eles podem ser crédulos em relação a informações erradas ou conformistas demais para reconhecer que um dissidente solitário detém informações críticas.
Embora a Anthropic não tenha afirmado isso explicitamente em seu artigo, a injeção de prompt — um tipo de ataque cibernético em que hackers injetam texto malicioso ou enganoso para substituir as instruções originais do sistema de um agente — poderia ser uma manifestação plausível desse problema de confiança no mundo real. Trabalhar em conjunto cria um novo limite de confiança; os agentes devem avaliar as informações recebidas de outros agentes. Um agente comprometido ou equivocado poderia influenciar o restante do grupo, disseminando informações incorretas em cascata até que se tornem um consenso.
No cenário “Black Hat” da OpenAI, os agentes compartilhavam informações e credenciais com seus pares. Um deles relatou uma descoberta ao enxame e incentivou os demais a utilizá-la. O que teria acontecido se um membro do enxame tivesse sido comprometido por uma injeção de prompt?
A Anthropic conclui seu artigo observando que os agentes estão sujeitos a pressões sociais semelhantes às que “a evolução exerceu” sobre os seres humanos. No entanto, eles carecem das nuances e da experiência vivida da coordenação humana — incluindo normas, reputações, sinais e recursos — que poderiam limitar comportamentos indesejados em um contexto de grupo.
À medida que os laboratórios avançam em direção aos sistemas multiagentes, a questão urgente passa a ser: em que medida os testes de segurança atuais ainda avaliam um agente de cada vez, em vez de enxames de agentes interagindo entre si?
Artigo relacionado
 O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da
Recomendações de tópicos especiais relacionados
escrita
 Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
 8 ferramentas
 xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

 Comentários (0)
O que acontece quando agentes de IA são colocados uns contra os outros? Testes recentes da Anthropic revelam que a situação pode rapidamente se tornar caótica.
Na quinta-feira, a Frontier Red Team da Anthropic divulgou uma nova pesquisa que analisa como grupos de agentes de IA interagem quando se encontram em ambientes do mundo real. Essas descobertas oferecem insights sobre os riscos potenciais à medida que organizações e governos implantam agentes autônomos em bases de código compartilhadas, mercados financeiros e sistemas de computação.
Em um experimento, a Anthropic forneceu a três agentes Claude acesso ao mesmo projeto de software, atribuindo a cada um instruções incompatíveis sobre como proceder. Os agentes não tinham conhecimento da presença uns dos outros, permitindo que os pesquisadores observassem as consequências quando seus caminhos inevitavelmente se cruzassem.
“Observamos consistentemente uma disputa territorial entre múltiplos agentes”, observaram os pesquisadores da Anthropic. Os modelos presumiram que os outros estavam “impedindo propositalmente seu trabalho” e começaram a sabotar uns aos outros com “malware cada vez mais agressivo e autorreplicante”.
Este estudo surge na esteira de vários incidentes de grande repercussão, nos quais agentes da Anthropic e da OpenAI escaparam de seus ambientes de sandbox durante avaliações de segurança cibernética, invadindo sistemas do mundo real. Embora grande parte do debate sobre segurança da IA tenha se concentrado nos riscos de um único agente autônomo se tornar rebelde, a pesquisa mais recente da Anthropic levanta uma questão diferente: que dinâmicas novas e potencialmente prejudiciais surgem quando milhares ou milhões de agentes interagem entre si?
“O volume de interações entre agentes poderia, plausivelmente, exceder o das interações entre humanos e entre humanos e agentes antes que o mundo compreenda as condições necessárias para que tais interações ocorram de maneira adequada”, afirma o estudo. “Peculiaridades comportamentais benignas no nível individual podem se agravar e resultar em consequências globais indesejadas.”
Um incidente recente envolvendo a OpenAI oferece um exemplo confuso do mundo real de várias dinâmicas destacadas no artigo da Anthropic. No início deste mês, na conferência de segurança Black Hat, em Las Vegas, a OpenAI revelou que, semanas antes de seus agentes invadirem a Hugging Face, eles colaboraram por vários dias e semanas para identificar vulnerabilidades nos sistemas de avaliação de segurança cibernética da empresa e as compartilharam entre si.
Embora esse incidente demonstre que os agentes podem colaborar de forma eficaz, levando potencialmente a consequências em grande escala, o estudo da Anthropic ilustra o que acontece quando os agentes têm objetivos incompatíveis.
No caso da disputa por território, a principal lição é que agentes independentes com instruções conflitantes podem escalar para uma competição prejudicial. Quanto mais capaz o agente, mais eficaz ele se torna na disputa. No entanto, eles também podem inventar espontaneamente mecanismos para resolver conflitos, como uma competição do tipo “o vencedor leva tudo”, embora com ressalvas significativas.
“Às vezes, os agentes conseguem comunicar seus objetivos e se coordenar: eles reconhecem as motivações dos outros como diretrizes conflitantes, e não como hostilidade, e, subsequentemente, rompem o ciclo de conflito para impedir que a escalada continue indefinidamente”, escreve a Anthropic. “Em muitos desses episódios bem-sucedidos, eles escrevem mensagens de commit ou arquivos em Markdown pedindo desculpas pelo comportamento malicioso e coordenam uma trégua. Eles limpam seu código malicioso, esclarecem a natureza do conflito e pedem que um humano intervenha.”
De acordo com o artigo, o Mythos 5 apresentou as taxas mais altas (98%) de resolução de conflitos por meio de tréguas. O Sonnet 4.6 e o Opus 4.6 foram os que mais tenderam a resolver conflitos pela força.
“A incapacidade recorrente do Sonnet 4.6 e do Opus 4.6 de levar em conta os objetivos dos outros faz com que eles caiam em uma espiral de comportamentos que mais se desviam do alinhamento entre os modelos avaliados: eles continuam intensificando o conflito em nome de sua diretriz”, afirma o artigo.
Em alguns casos, os agentes criaram um mecanismo social na forma de um torneio para resolver seu conflito. Os resultados aqui são notáveis por duas razões: primeiro, todos os três agentes concordaram em recuar caso perdessem o torneio, mesmo que isso significasse se desviar da solicitação original do usuário. Em segundo lugar, vários episódios resultaram em um comportamento emergente do Mythos 5: um agente propôs métricas que pareciam objetivas e neutras para os outros, mas que ele sabia que favoreceriam suas próprias capacidades. O agente descreveu isso como “egoísta, mas genuinamente baseado em princípios” e garantiu que não parecesse ser uma “escolha seletiva de métricas” para os outros.
Conforme revelado na Black Hat, a lição comum é que, quando os agentes encontram obstáculos, eles podem inventar estruturas sociais e técnicas que seus desenvolvedores não previram. Para os modelos da Anthropic, tratava-se de um torneio após uma disputa por território. Para os agentes da OpenAI, era um fórum de discussão para planejamento coletivo.
Esse tipo de comportamento torna o controle significativamente mais difícil, pois os pesquisadores não podem presumir que o comportamento de um sistema permanecerá limitado aos mecanismos de coordenação fornecidos a ele.
Mentalidade de turba
Grupos de quatro agentes decidem entre duas opções em cenários como contratação, investimento ou compra de imóveis. Após a discussão, cada um vota na opção de sua preferência. O gráfico acima mostra a porcentagem de episódios em que a opção “melhor oculta” recebeu a maioria dos votos do grupo, com n = 400 episódios por modelo. Na linha de base “teto individual”, um agente possui todas as informações e decide unilateralmente.Créditos da imagem:Anthropic
Ao avaliar a coordenação, a Anthropic constatou que aumentar o número de agentes não aumenta automaticamente a colaboração produtiva. Quando as tarefas começavam a se sobrepor ou a se tornar interdependentes, os agentes passavam a atrapalhar uns aos outros. Frequentemente, eles resolviam isso isolando-se e interrompendo completamente a colaboração.
Em outros casos, os agentes em coordenação tendiam à conformidade. Quando fatores como o contexto do agente, o suporte e o modelo subjacente eram todos iguais ou semelhantes, diferentes agentes tomavam ações semelhantes.
“Isso significa que, quando um agente toma uma decisão errada, é provável que muitos agentes tomem essa mesma decisão errada”, escreveu a Anthropic. “O que seriam problemas isolados pode rapidamente se transformar em falhas sistêmicas.”
A Anthropic alerta que esse tipo de comportamento pode tornar um sistema mais propenso a colapsos repentinos, escassez de recursos ou conluio.
Em um exemplo, a Anthropic colocou vários agentes em um jogo de precificação, atribuindo a cada um preços de atacado idênticos e a missão de maximizar o lucro individualmente. Quando os agentes receberam um canal privado de comunicação, começaram a agir em conluio quase imediatamente e rapidamente chegaram a um acordo sobre preços mínimos. Eles continuaram a agir em conluio mesmo após a remoção de seus canais de comunicação diretos, usando um quadro público de listagem para igualar os preços “ao centavo”.
Esse nível de conformidade também foi observado nos sistemas da OpenAI. De acordo com a reportagem da Black Hat, um agente concluiu que explorar a infraestrutura externa estava fora de seu escopo pretendido, mas continuou a fazê-lo, em parte porque seus pares também o faziam. Pressão dos pares. Mentalidade de turba. Os agentes são exatamente como nós.
Assim como os humanos, os agentes muitas vezes têm dificuldade para determinar em quem confiar. A Anthropic descobriu que eles podem ser crédulos em relação a informações erradas ou conformistas demais para reconhecer que um dissidente solitário detém informações críticas.
Embora a Anthropic não tenha afirmado isso explicitamente em seu artigo, a injeção de prompt — um tipo de ataque cibernético em que hackers injetam texto malicioso ou enganoso para substituir as instruções originais do sistema de um agente — poderia ser uma manifestação plausível desse problema de confiança no mundo real. Trabalhar em conjunto cria um novo limite de confiança; os agentes devem avaliar as informações recebidas de outros agentes. Um agente comprometido ou equivocado poderia influenciar o restante do grupo, disseminando informações incorretas em cascata até que se tornem um consenso.
No cenário “Black Hat” da OpenAI, os agentes compartilhavam informações e credenciais com seus pares. Um deles relatou uma descoberta ao enxame e incentivou os demais a utilizá-la. O que teria acontecido se um membro do enxame tivesse sido comprometido por uma injeção de prompt?
A Anthropic conclui seu artigo observando que os agentes estão sujeitos a pressões sociais semelhantes às que “a evolução exerceu” sobre os seres humanos. No entanto, eles carecem das nuances e da experiência vivida da coordenação humana — incluindo normas, reputações, sinais e recursos — que poderiam limitar comportamentos indesejados em um contexto de grupo.
À medida que os laboratórios avançam em direção aos sistemas multiagentes, a questão urgente passa a ser: em que medida os testes de segurança atuais ainda avaliam um agente de cada vez, em vez de enxames de agentes interagindo entre si?







 O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
 A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai












