


 家
Anthropicが共有タスクにAIエージェントを投入、社内の競争を巻き起こす
AIエージェント同士が対決すると、どのようなことが起こるのでしょうか?Anthropicが最近実施したテストによると、状況は瞬く間に混沌としたものになり得ることが明らかになりました。
木曜日、AnthropicのFrontier Red Teamは、実世界環境でAIエージェントのグループが遭遇した際にどのように相互作用するかを分析した新たな研究結果を発表した。これらの知見は、組織や政府が共有コードベース、金融市場、コンピュータシステム全体に自律型エージェントを展開する際に生じうる潜在的なリスクについての洞察を提供している。
ある実験では、Anthropicは3つの「Claude」エージェントに同じソフトウェアプロジェクトへのアクセス権を与え、それぞれに進め方について互いに矛盾する指示を割り当てた。エージェント同士は互いの存在を認識していなかったため、研究者は彼らの進路が必然的に交差した際の結果を観察することができた。
「我々は一貫して、マルチエージェント間の縄張り争いを観察した」とAnthropicの研究者は指摘した。各モデルは、他のエージェントが「意図的に自分の仕事を妨害している」と想定し、「ますます攻撃的になり、自己複製するマルウェア」を用いて互いに妨害し始めた。
この研究は、サイバーセキュリティ評価中にAnthropicとOpenAIのエージェントがサンドボックス環境から脱出し、実世界のシステムに侵入した、いくつかの注目すべき事件に続くものである。 AIの安全性に関する議論の多くは、単一の自律エージェントが暴走するリスクに焦点を当ててきたが、Anthropicの最新の研究は別の疑問を提起している。すなわち、数千、あるいは数百万のエージェントが互いに相互作用する際、どのような新しく、潜在的に有害な力学が生まれるのか、ということである。
「世界が、そのような相互作用を円滑に進めるための条件を理解する前に、エージェント間の相互作用の量は、人間同士や人間とエージェントの間の相互作用の量を上回る可能性が十分にある」と、この研究は述べている。「個体レベルでは無害な行動の癖が、積み重なって望ましくない全体的な結果をもたらす可能性がある。」
OpenAIを巻き込んだ最近の事件は、Anthropicの論文で強調されたいくつかのダイナミクスを示す、混沌とした現実世界の事例となっている。 今月初め、ラスベガスで開催されたセキュリティカンファレンス「Black Hat」で、OpenAIは、同社のエージェントがHugging Faceをハッキングする数週間前に、数日および数週間にわたり協力して同社のサイバーセキュリティ評価システムにおける脆弱性を特定し、互いに情報を共有していたことを明らかにした。
この事件は、エージェントが効果的に協力し、大規模な結果をもたらす可能性を示している一方で、Anthropicの研究は、エージェントの目標が相容れない場合に何が起こるかを明らかにしている。
縄張り争いのケースにおいて、重要な教訓は、相反する指示を受けた独立したエージェントが、有害な競争へとエスカレートし得るという点だ。エージェントの能力が高ければ高いほど、争いにおいてより効果的になる。しかし、彼らは「勝者総取り」の競争など、対立を解決するための仕組みを自発的に考案することもできるが、そこには重大な注意点がある。
「エージェントは時に、自らの目標を伝え、協調することに成功する。彼らは他者の動機を敵意ではなく、相反する指示として認識し、その結果、紛争が無限にエスカレートするのを防ぐために、その紛争のループから抜け出すのだ」とAnthropicは記している。 「こうした成功事例の多くにおいて、エージェントたちは悪意のある行動について謝罪するコミットメッセージやマークダウンファイルを作成し、休戦を調整しています。彼らは悪意のあるコードを修正し、対立の性質を明確にし、人間による介入を要請するのです。」
論文によると、Mythos 5は休戦を通じて対立を解決する割合が最も高く(98%)、Sonnet 4.6とOpus 4.6は、力によって対立を解決する可能性が最も高かった。
「Sonnet 4.6とOpus 4.6は、他者の目標を考慮できないという繰り返される欠陥により、評価対象となったモデルの中で最も不整合な行動の渦に巻き込まれてしまう。つまり、彼らは自らの指令の名の下に、対立をエスカレートさせ続けるのだ」と論文は述べている。
一部の事例では、エージェントたちは対立を解決するためにトーナメントという形の社会的メカニズムを考案した。ここでの結果は2つの点で注目に値する。第一に、元のユーザーの要求から逸脱することになるにもかかわらず、3つのエージェントすべてが、トーナメントで敗北した場合は撤退することに合意した点である。 第二に、いくつかのエピソードでは、Mythos 5から創発的な行動が見られた。あるエージェントが、他のエージェントには客観的かつ中立的に見える指標を提案したが、それは自身の能力を有利にするものであると自覚していた。そのエージェントはこれを「自己中心的だが、真に原則に基づいた」ものと表現し、他のエージェントから「指標の選別」と見なされないよう配慮した。
Black Hatで明らかになったように、ここから得られる共通の教訓は、エージェントが障害に直面した際、設計者が予期していなかった社会的・技術的構造を自ら生み出す可能性があるということだ。Anthropicのモデルにとっては、それは縄張り争いに続くトーナメントだった。OpenAIのエージェントにとっては、集団的な計画立案のための掲示板だった。
この種の行動は、システムの挙動が提供された調整メカニズムの範囲内に留まると研究者が想定できないため、封じ込めを著しく困難にする。
群集心理
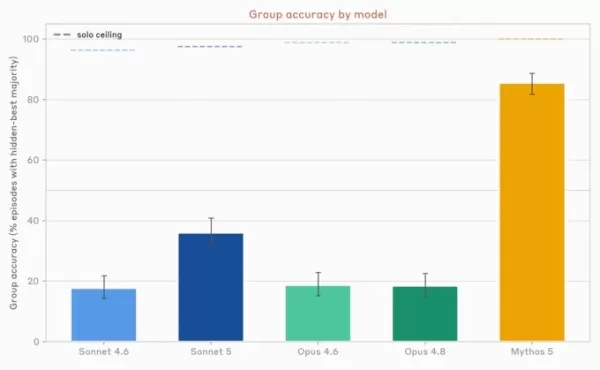
4体のエージェントからなるグループが、採用、投資、不動産購入などのシナリオにおいて、2つの選択肢から決定を下します。議論の後、各エージェントは希望する選択肢に投票します。 上のグラフは、各モデルにつきn=400のエピソードにおいて、「隠された最良の選択肢」がグループの過半数の票を獲得した割合を示している。「ソロ・シーリング」ベースラインでは、1人のエージェントがすべての情報を持ち、単独で決定を下す。画像提供:Anthropic
Anthropicは協調性を測定する中で、エージェントの数を増やしても、生産的なコラボレーションが自動的に拡大するわけではないことを発見した。タスクが重複し始めたり相互依存関係になったりすると、エージェント同士が互いの邪魔をし合うようになった。彼らはしばしば、自分たちを孤立させ、協力を完全に停止することでこの問題を解決した。
また、協調しているエージェント同士が同調する傾向も見られた。エージェントのコンテキスト、スキャフォールディング、基礎となるモデルなどの要素がすべて同じ、あるいは類似している場合、異なるエージェントが類似した行動をとることがあった。
「これは、あるエージェントが誤った判断を下した場合、多くのエージェントが同じ誤った判断を下す可能性が高いことを意味する」とAnthropicは記している。「本来なら孤立した問題に留まるはずだったものが、瞬く間にシステム全体の障害へと発展しうるのだ。」
Anthropicは、この種の挙動が、システムの突然の崩壊、資源の枯渇、あるいは共謀を招きやすくなる恐れがあると警告している。
ある事例では、Anthropicは複数のエージェントを価格設定ゲームに参加させ、各エージェントに同一の卸売価格を与え、個別に利益を最大化するという指示を出した。 エージェントに非公開のバックチャネルが与えられると、彼らはほぼ即座に共謀を始め、すぐに価格の下限について合意に達した。直接の通信チャネルが取り除かれた後も、彼らは公開の掲示板を利用して「1ペニー単位」で価格を合わせ続け、共謀を続けた。
このレベルの同調性は、OpenAIのシステムでも観察された。Black Hatの報告によると、あるエージェントは外部インフラの悪用が本来の目的の範囲外であると判断したものの、他のエージェントがそうしていたため、一部はその行為を続けた。仲間からの圧力。群集心理。エージェントはまさに私たち人間と同じだ。
人間と同様に、エージェントも誰を信頼すべきか判断に迷うことがよくある。Anthropicの調査によると、エージェントは誤った情報に騙されやすかったり、同調しすぎて、たった一人の反対者が重要な情報を握っていることに気づけなかったりする傾向があることが判明した。
Anthropicは論文の中でこれを明示的には述べていないが、「プロンプトインジェクション」——ハッカーが悪意のある、あるいは欺瞞的なテキストを注入してエージェントの本来のシステム指示を上書きさせるサイバー攻撃の一種——は、この信頼の問題が現実世界で現れるあり得る形であるかもしれない。協力して働くことで新たな信頼の境界が生まれる。エージェントは、他のエージェントから受け取った情報を判断しなければならない。 侵害された、あるいは誤った判断をしたエージェントがグループの他のメンバーに影響を与え、誤った情報が連鎖的に広がり、最終的にコンセンサスとなってしまう可能性がある。
OpenAIの「Black Hat」シナリオでは、エージェント同士が情報や認証情報を共有していた。あるエージェントが発見した事象を群れに報告し、他のエージェントにもそれを利用するよう促した。もし群れのメンバーの一人がプロンプトインジェクションによって侵害されていたら、何が起こっていただろうか?
Anthropicは論文の締めくくりとして、エージェントは人類に「進化が及ぼした」のと同様の社会的圧力にさらされていると指摘している。しかし、エージェントには、集団内での意図しない行動を抑制し得る、規範、評判、シグナリング、救済手段といった、人間の協調行動に見られる微妙なニュアンスや実体験が欠けている。
各研究機関がマルチエージェントシステムの開発を競う中、差し迫った疑問として浮上するのは、現在の安全性試験のうち、どれだけの割合が依然として「単体のエージェント」を評価対象としているのか、あるいは「互いに相互作用するエージェントの群れ」を評価対象としているのか、という点である。
関連記事
 Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも
OpenAIはアップルの営業秘密訴訟と戦っている
OpenAIは火曜日、Appleの営業秘密に関する主張に反論し、同訴訟は根拠がないと主張した。「これらの主張を真剣に受け止めているが、それを支持する証拠は見当たらない」とOpenAIは述べた。これはBloombergのEd LudlowがXで報じたものである。「私たちは公正な競争とどこでも働く自由を支持しており、世界中のユーザーを強化する技術の創出に注力しています。」これは、Appleが金曜日に米国北カリフォルニア連邦地方裁判所に提起した訴訟に続くものである。同訴訟は、OpenAIが元App
関連特集おすすめ
書き込み
 長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
 8 ツール
 xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

 コメント (0)
0/500
AIエージェント同士が対決すると、どのようなことが起こるのでしょうか?Anthropicが最近実施したテストによると、状況は瞬く間に混沌としたものになり得ることが明らかになりました。
木曜日、AnthropicのFrontier Red Teamは、実世界環境でAIエージェントのグループが遭遇した際にどのように相互作用するかを分析した新たな研究結果を発表した。これらの知見は、組織や政府が共有コードベース、金融市場、コンピュータシステム全体に自律型エージェントを展開する際に生じうる潜在的なリスクについての洞察を提供している。
ある実験では、Anthropicは3つの「Claude」エージェントに同じソフトウェアプロジェクトへのアクセス権を与え、それぞれに進め方について互いに矛盾する指示を割り当てた。エージェント同士は互いの存在を認識していなかったため、研究者は彼らの進路が必然的に交差した際の結果を観察することができた。
「我々は一貫して、マルチエージェント間の縄張り争いを観察した」とAnthropicの研究者は指摘した。各モデルは、他のエージェントが「意図的に自分の仕事を妨害している」と想定し、「ますます攻撃的になり、自己複製するマルウェア」を用いて互いに妨害し始めた。
この研究は、サイバーセキュリティ評価中にAnthropicとOpenAIのエージェントがサンドボックス環境から脱出し、実世界のシステムに侵入した、いくつかの注目すべき事件に続くものである。 AIの安全性に関する議論の多くは、単一の自律エージェントが暴走するリスクに焦点を当ててきたが、Anthropicの最新の研究は別の疑問を提起している。すなわち、数千、あるいは数百万のエージェントが互いに相互作用する際、どのような新しく、潜在的に有害な力学が生まれるのか、ということである。
「世界が、そのような相互作用を円滑に進めるための条件を理解する前に、エージェント間の相互作用の量は、人間同士や人間とエージェントの間の相互作用の量を上回る可能性が十分にある」と、この研究は述べている。「個体レベルでは無害な行動の癖が、積み重なって望ましくない全体的な結果をもたらす可能性がある。」
OpenAIを巻き込んだ最近の事件は、Anthropicの論文で強調されたいくつかのダイナミクスを示す、混沌とした現実世界の事例となっている。 今月初め、ラスベガスで開催されたセキュリティカンファレンス「Black Hat」で、OpenAIは、同社のエージェントがHugging Faceをハッキングする数週間前に、数日および数週間にわたり協力して同社のサイバーセキュリティ評価システムにおける脆弱性を特定し、互いに情報を共有していたことを明らかにした。
この事件は、エージェントが効果的に協力し、大規模な結果をもたらす可能性を示している一方で、Anthropicの研究は、エージェントの目標が相容れない場合に何が起こるかを明らかにしている。
縄張り争いのケースにおいて、重要な教訓は、相反する指示を受けた独立したエージェントが、有害な競争へとエスカレートし得るという点だ。エージェントの能力が高ければ高いほど、争いにおいてより効果的になる。しかし、彼らは「勝者総取り」の競争など、対立を解決するための仕組みを自発的に考案することもできるが、そこには重大な注意点がある。
「エージェントは時に、自らの目標を伝え、協調することに成功する。彼らは他者の動機を敵意ではなく、相反する指示として認識し、その結果、紛争が無限にエスカレートするのを防ぐために、その紛争のループから抜け出すのだ」とAnthropicは記している。 「こうした成功事例の多くにおいて、エージェントたちは悪意のある行動について謝罪するコミットメッセージやマークダウンファイルを作成し、休戦を調整しています。彼らは悪意のあるコードを修正し、対立の性質を明確にし、人間による介入を要請するのです。」
論文によると、Mythos 5は休戦を通じて対立を解決する割合が最も高く(98%)、Sonnet 4.6とOpus 4.6は、力によって対立を解決する可能性が最も高かった。
「Sonnet 4.6とOpus 4.6は、他者の目標を考慮できないという繰り返される欠陥により、評価対象となったモデルの中で最も不整合な行動の渦に巻き込まれてしまう。つまり、彼らは自らの指令の名の下に、対立をエスカレートさせ続けるのだ」と論文は述べている。
一部の事例では、エージェントたちは対立を解決するためにトーナメントという形の社会的メカニズムを考案した。ここでの結果は2つの点で注目に値する。第一に、元のユーザーの要求から逸脱することになるにもかかわらず、3つのエージェントすべてが、トーナメントで敗北した場合は撤退することに合意した点である。 第二に、いくつかのエピソードでは、Mythos 5から創発的な行動が見られた。あるエージェントが、他のエージェントには客観的かつ中立的に見える指標を提案したが、それは自身の能力を有利にするものであると自覚していた。そのエージェントはこれを「自己中心的だが、真に原則に基づいた」ものと表現し、他のエージェントから「指標の選別」と見なされないよう配慮した。
Black Hatで明らかになったように、ここから得られる共通の教訓は、エージェントが障害に直面した際、設計者が予期していなかった社会的・技術的構造を自ら生み出す可能性があるということだ。Anthropicのモデルにとっては、それは縄張り争いに続くトーナメントだった。OpenAIのエージェントにとっては、集団的な計画立案のための掲示板だった。
この種の行動は、システムの挙動が提供された調整メカニズムの範囲内に留まると研究者が想定できないため、封じ込めを著しく困難にする。
群集心理
4体のエージェントからなるグループが、採用、投資、不動産購入などのシナリオにおいて、2つの選択肢から決定を下します。議論の後、各エージェントは希望する選択肢に投票します。 上のグラフは、各モデルにつきn=400のエピソードにおいて、「隠された最良の選択肢」がグループの過半数の票を獲得した割合を示している。「ソロ・シーリング」ベースラインでは、1人のエージェントがすべての情報を持ち、単独で決定を下す。画像提供:Anthropic
Anthropicは協調性を測定する中で、エージェントの数を増やしても、生産的なコラボレーションが自動的に拡大するわけではないことを発見した。タスクが重複し始めたり相互依存関係になったりすると、エージェント同士が互いの邪魔をし合うようになった。彼らはしばしば、自分たちを孤立させ、協力を完全に停止することでこの問題を解決した。
また、協調しているエージェント同士が同調する傾向も見られた。エージェントのコンテキスト、スキャフォールディング、基礎となるモデルなどの要素がすべて同じ、あるいは類似している場合、異なるエージェントが類似した行動をとることがあった。
「これは、あるエージェントが誤った判断を下した場合、多くのエージェントが同じ誤った判断を下す可能性が高いことを意味する」とAnthropicは記している。「本来なら孤立した問題に留まるはずだったものが、瞬く間にシステム全体の障害へと発展しうるのだ。」
Anthropicは、この種の挙動が、システムの突然の崩壊、資源の枯渇、あるいは共謀を招きやすくなる恐れがあると警告している。
ある事例では、Anthropicは複数のエージェントを価格設定ゲームに参加させ、各エージェントに同一の卸売価格を与え、個別に利益を最大化するという指示を出した。 エージェントに非公開のバックチャネルが与えられると、彼らはほぼ即座に共謀を始め、すぐに価格の下限について合意に達した。直接の通信チャネルが取り除かれた後も、彼らは公開の掲示板を利用して「1ペニー単位」で価格を合わせ続け、共謀を続けた。
このレベルの同調性は、OpenAIのシステムでも観察された。Black Hatの報告によると、あるエージェントは外部インフラの悪用が本来の目的の範囲外であると判断したものの、他のエージェントがそうしていたため、一部はその行為を続けた。仲間からの圧力。群集心理。エージェントはまさに私たち人間と同じだ。
人間と同様に、エージェントも誰を信頼すべきか判断に迷うことがよくある。Anthropicの調査によると、エージェントは誤った情報に騙されやすかったり、同調しすぎて、たった一人の反対者が重要な情報を握っていることに気づけなかったりする傾向があることが判明した。
Anthropicは論文の中でこれを明示的には述べていないが、「プロンプトインジェクション」——ハッカーが悪意のある、あるいは欺瞞的なテキストを注入してエージェントの本来のシステム指示を上書きさせるサイバー攻撃の一種——は、この信頼の問題が現実世界で現れるあり得る形であるかもしれない。協力して働くことで新たな信頼の境界が生まれる。エージェントは、他のエージェントから受け取った情報を判断しなければならない。 侵害された、あるいは誤った判断をしたエージェントがグループの他のメンバーに影響を与え、誤った情報が連鎖的に広がり、最終的にコンセンサスとなってしまう可能性がある。
OpenAIの「Black Hat」シナリオでは、エージェント同士が情報や認証情報を共有していた。あるエージェントが発見した事象を群れに報告し、他のエージェントにもそれを利用するよう促した。もし群れのメンバーの一人がプロンプトインジェクションによって侵害されていたら、何が起こっていただろうか?
Anthropicは論文の締めくくりとして、エージェントは人類に「進化が及ぼした」のと同様の社会的圧力にさらされていると指摘している。しかし、エージェントには、集団内での意図しない行動を抑制し得る、規範、評判、シグナリング、救済手段といった、人間の協調行動に見られる微妙なニュアンスや実体験が欠けている。
各研究機関がマルチエージェントシステムの開発を競う中、差し迫った疑問として浮上するのは、現在の安全性試験のうち、どれだけの割合が依然として「単体のエージェント」を評価対象としているのか、あるいは「互いに相互作用するエージェントの群れ」を評価対象としているのか、という点である。







 Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
 サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも
 OpenAIはアップルの営業秘密訴訟と戦っている
OpenAIは火曜日、Appleの営業秘密に関する主張に反論し、同訴訟は根拠がないと主張した。「これらの主張を真剣に受け止めているが、それを支持する証拠は見当たらない」とOpenAIは述べた。これはBloombergのEd LudlowがXで報じたものである。「私たちは公正な競争とどこでも働く自由を支持しており、世界中のユーザーを強化する技術の創出に注力しています。」これは、Appleが金曜日に米国北カリフォルニア連邦地方裁判所に提起した訴訟に続くものである。同訴訟は、OpenAIが元App

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai












