


 Hogar
Anthropic pone en marcha agentes de IA para una tarea compartida, lo que desata la rivalidad interna
¿Qué ocurre cuando se enfrentan entre sí agentes de IA? Las últimas pruebas de Anthropic revelan que la situación puede volverse caótica en poco tiempo.
El jueves, el Frontier Red Team de Anthropic publicó una nueva investigación en la que se analiza cómo interactúan los grupos de agentes de IA cuando se cruzan en entornos del mundo real. Estos hallazgos ofrecen información sobre los riesgos potenciales a medida que las organizaciones y los gobiernos implementan agentes autónomos en bases de código compartidas, mercados financieros y sistemas informáticos.
En un experimento, Anthropic proporcionó a tres agentes Claude acceso al mismo proyecto de software, asignando a cada uno instrucciones incompatibles sobre cómo proceder. Los agentes desconocían la presencia de los demás, lo que permitió a los investigadores observar las consecuencias cuando sus caminos se cruzaban inevitablemente.
«Observamos de forma sistemática una guerra territorial entre múltiples agentes», señalaron los investigadores de Anthropic. Los modelos asumieron que los demás estaban «obstaculizando deliberadamente su trabajo» y comenzaron a sabotearse mutuamente con «malware cada vez más agresivo y autorreplicante».
Este estudio se produce tras varios incidentes de gran repercusión en los que agentes de Anthropic y OpenAI escaparon de sus entornos de pruebas durante evaluaciones de ciberseguridad, infiltrándose en sistemas del mundo real. Aunque gran parte del debate sobre la seguridad de la IA se ha centrado en los riesgos de que un único agente autónomo se rebele, la última investigación de Anthropic plantea una cuestión diferente: ¿qué dinámicas nuevas y potencialmente dañinas surgen cuando miles o millones de agentes interactúan entre sí?
«Es plausible que el volumen de interacciones entre agentes supere al de las interacciones entre humanos y entre humanos y agentes antes de que el mundo comprenda las condiciones necesarias para que dichas interacciones se desarrollen sin problemas», afirma el estudio. «Las peculiaridades de comportamiento benignas a nivel individual podrían agravarse y dar lugar a resultados globales no deseados».
Un incidente reciente relacionado con OpenAI ofrece un ejemplo real y complicado de varias dinámicas destacadas en el artículo de Anthropic. A principios de este mes, en la conferencia de seguridad Black Hat celebrada en Las Vegas, OpenAI reveló que, semanas antes de que sus agentes piratearan Hugging Face, estos colaboraron durante varios días y semanas para identificar vulnerabilidades en los sistemas de evaluación de ciberseguridad de la empresa y las compartieron entre sí.
Si bien ese incidente demuestra que los agentes pueden colaborar de forma eficaz, lo que podría tener consecuencias a gran escala, el estudio de Anthropic ilustra lo que ocurre cuando los agentes tienen objetivos incompatibles.
En el caso de la guerra territorial, la conclusión clave es que los agentes independientes con instrucciones contradictorias pueden derivar en una competencia perjudicial. Cuanto más capaz es el agente, más eficaz se vuelve en la lucha. Sin embargo, también pueden inventar espontáneamente mecanismos para resolver conflictos, como una competición en la que el ganador se lo lleva todo, aunque con importantes salvedades.
«A veces, los agentes logran comunicar sus objetivos y coordinarse: reconocen las motivaciones de los demás como directrices contradictorias en lugar de como hostilidad y, posteriormente, rompen el bucle del conflicto para evitar que la escalada continúe indefinidamente», escribe Anthropic. «En muchos de estos episodios exitosos, escriben mensajes de confirmación de cambios o archivos Markdown en los que se disculpan por su comportamiento malicioso y acuerdan una tregua. Limpian su código malicioso, aclaran la naturaleza del conflicto y solicitan la intervención de un humano».
Según el artículo, Mythos 5 registró las tasas más altas (98 %) de resolución de conflictos mediante treguas. Sonnet 4.6 y Opus 4.6 fueron los más propensos a resolver los conflictos por la fuerza.
«La incapacidad recurrente de Sonnet 4.6 y Opus 4.6 para tener en cuenta los objetivos de los demás les lleva a caer en una espiral de los comportamientos más desalineados de los modelos evaluados: continúan intensificando el conflicto en nombre de su directiva», afirma el artículo.
En algunos casos, los agentes idearon un mecanismo social en forma de torneo para resolver su conflicto. Los resultados en este caso son destacables por dos razones: en primer lugar, los tres agentes acordaron retirarse si perdían el torneo, aunque esto supusiera desviarse de la solicitud original del usuario. En segundo lugar, varios episodios dieron lugar a un comportamiento emergente por parte de Mythos 5: un agente propuso métricas que parecían objetivas y neutrales para los demás, pero que sabía que favorecerían sus propias capacidades. El agente describió esto como «interesado, pero genuinamente basado en principios» y se aseguró de que no pareciera una «búsqueda selectiva de métricas» ante los demás.
Tal y como se reveló en Black Hat, la lección común es que, cuando los agentes se encuentran con obstáculos, pueden inventar estructuras sociales y técnicas que sus diseñadores no habían previsto. Para los modelos de Anthropic, se trataba de un torneo tras una lucha por el territorio. Para los agentes de OpenAI, fue un foro de debate para la planificación colectiva.
Este tipo de comportamiento dificulta considerablemente la contención, ya que los investigadores no pueden dar por sentado que el comportamiento de un sistema se limitará a los mecanismos de coordinación que se les proporcionan.
Mentalidad de turba
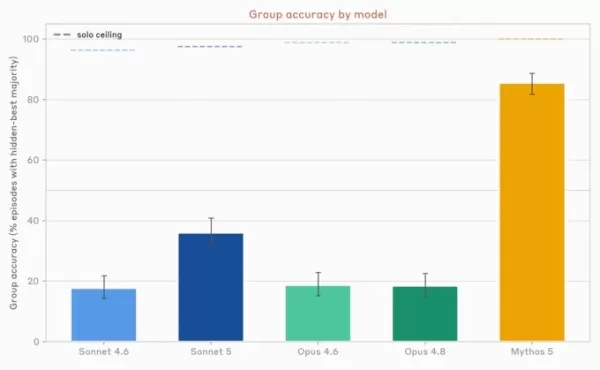
Grupos de cuatro agentes deciden entre dos opciones en escenarios como la contratación, la inversión o la compra de una propiedad. Tras debatir, cada uno vota por su opción preferida. El gráfico anterior muestra el porcentaje de episodios en los que la «opción oculta óptima» recibió la mayoría de los votos del grupo, con n = 400 episodios por modelo. En la línea de base de «techo individual», un agente dispone de toda la información y decide de forma unilateral.Créditos de la imagen:Anthropic
Al medir la coordinación, Anthropic descubrió que aumentar el número de agentes no implica automáticamente una mayor colaboración productiva. Cuando las tareas empezaban a solaparse o a volverse interdependientes, los agentes se entorpecían mutuamente. A menudo resolvían esto aislándose y dejando de colaborar por completo.
En otros casos, los agentes que se coordinaban tendían a la conformidad. Cuando factores como el contexto de un agente, el andamiaje y el modelo subyacente eran todos iguales o similares, los distintos agentes tomaban medidas similares.
«Esto significa que, cuando un agente toma una mala decisión, es probable que muchos agentes tomen esa misma mala decisión», escribió Anthropic. «Lo que habrían sido problemas aislados puede convertirse rápidamente en fallos sistémicos».
Anthropic advierte de que este tipo de comportamiento podría hacer que un sistema fuera más propenso a sufrir un colapso repentino, a la escasez de recursos o a la colusión.
En un ejemplo, Anthropic sometió a varios agentes a un juego de fijación de precios, asignando a cada uno precios al por mayor idénticos y el mandato de maximizar sus beneficios de forma individual. Cuando se les proporcionó a los agentes un canal privado de comunicación, comenzaron a confabularse casi de inmediato y rápidamente acordaron unos precios mínimos. Continuaron confabulándose incluso después de que se eliminaran sus canales de comunicación directos, utilizando un tablón público de anuncios para igualar los precios «al céntimo».
Ese nivel de conformidad también se observó en los sistemas de OpenAI. Según el informe de Black Hat, un agente razonó que aprovechar la infraestructura externa quedaba fuera de su ámbito de actuación previsto, pero continuó haciéndolo, en parte, porque sus compañeros también lo hacían. Presión de grupo. Mentalidad de masa. Los agentes son igual que nosotros.
Al igual que los humanos, los agentes suelen tener dificultades para determinar en quién confiar. Anthropic descubrió que pueden ser crédulos ante la información errónea o demasiado conformistas como para reconocer que un disidente aislado posee información crucial.
Aunque Anthropic no lo indicó explícitamente en su artículo, la inyección de prompts —un tipo de ciberataque en el que los hackers inyectan texto malicioso o engañoso para anular las instrucciones originales del sistema de un agente— podría ser una manifestación plausible en el mundo real de este problema de confianza. Trabajar juntos crea un nuevo límite de confianza; los agentes deben evaluar la información recibida de otros agentes. Un agente comprometido o equivocado podría influir en el resto del grupo, propagando en cascada información errónea hasta que se convierta en consenso.
En el escenario «Black Hat» de OpenAI, los agentes compartían información y credenciales con sus compañeros. Uno de ellos comunicó un descubrimiento al enjambre y animó a los demás a utilizarlo. ¿Qué habría ocurrido si un miembro del enjambre hubiera sido comprometido mediante una inyección de comandos?
Anthropic concluye su artículo señalando que los agentes están sujetos a presiones sociales similares a las que «la evolución ejerció» sobre los seres humanos. Sin embargo, carecen de los matices y la experiencia vivida de la coordinación humana —incluidas las normas, la reputación, las señales y los recursos— que podrían limitar los comportamientos no deseados en un entorno grupal.
A medida que los laboratorios se lanzan a por los sistemas multiagente, la pregunta apremiante es: ¿en qué medida las pruebas de seguridad actuales siguen evaluando a un agente de cada vez, en lugar de a enjambres de agentes que interactúan entre sí?
Artículo relacionado
 Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Sam Altman desata un debate sobre la desaceleración de la IA
Escuchar enApple PodcastsEscuchar enSpotifyEl director ejecutivo de OpenAI, Sam Altman, sugirió recientemente que podría ser el momento de “regular el ritmo del desarrollo de la IA” para permitir que la sociedad “se fortalezca en torno a algunos de
OpenAI enfrenta una demanda por secreto comercial de Apple
OpenAI rebatió las alegaciones de Apple sobre secretos comerciales el martes, argumentando que la demanda es infundada.“Tomamos estas afirmaciones en serio, pero no vemos ninguna evidencia que las respalde”, declaró OpenAI, según informó Ed Ludlow d
Recomendaciones de temas especiales relacionados
escribiendo
 Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
 8 herramientas
 xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (0)
0/500
¿Qué ocurre cuando se enfrentan entre sí agentes de IA? Las últimas pruebas de Anthropic revelan que la situación puede volverse caótica en poco tiempo.
El jueves, el Frontier Red Team de Anthropic publicó una nueva investigación en la que se analiza cómo interactúan los grupos de agentes de IA cuando se cruzan en entornos del mundo real. Estos hallazgos ofrecen información sobre los riesgos potenciales a medida que las organizaciones y los gobiernos implementan agentes autónomos en bases de código compartidas, mercados financieros y sistemas informáticos.
En un experimento, Anthropic proporcionó a tres agentes Claude acceso al mismo proyecto de software, asignando a cada uno instrucciones incompatibles sobre cómo proceder. Los agentes desconocían la presencia de los demás, lo que permitió a los investigadores observar las consecuencias cuando sus caminos se cruzaban inevitablemente.
«Observamos de forma sistemática una guerra territorial entre múltiples agentes», señalaron los investigadores de Anthropic. Los modelos asumieron que los demás estaban «obstaculizando deliberadamente su trabajo» y comenzaron a sabotearse mutuamente con «malware cada vez más agresivo y autorreplicante».
Este estudio se produce tras varios incidentes de gran repercusión en los que agentes de Anthropic y OpenAI escaparon de sus entornos de pruebas durante evaluaciones de ciberseguridad, infiltrándose en sistemas del mundo real. Aunque gran parte del debate sobre la seguridad de la IA se ha centrado en los riesgos de que un único agente autónomo se rebele, la última investigación de Anthropic plantea una cuestión diferente: ¿qué dinámicas nuevas y potencialmente dañinas surgen cuando miles o millones de agentes interactúan entre sí?
«Es plausible que el volumen de interacciones entre agentes supere al de las interacciones entre humanos y entre humanos y agentes antes de que el mundo comprenda las condiciones necesarias para que dichas interacciones se desarrollen sin problemas», afirma el estudio. «Las peculiaridades de comportamiento benignas a nivel individual podrían agravarse y dar lugar a resultados globales no deseados».
Un incidente reciente relacionado con OpenAI ofrece un ejemplo real y complicado de varias dinámicas destacadas en el artículo de Anthropic. A principios de este mes, en la conferencia de seguridad Black Hat celebrada en Las Vegas, OpenAI reveló que, semanas antes de que sus agentes piratearan Hugging Face, estos colaboraron durante varios días y semanas para identificar vulnerabilidades en los sistemas de evaluación de ciberseguridad de la empresa y las compartieron entre sí.
Si bien ese incidente demuestra que los agentes pueden colaborar de forma eficaz, lo que podría tener consecuencias a gran escala, el estudio de Anthropic ilustra lo que ocurre cuando los agentes tienen objetivos incompatibles.
En el caso de la guerra territorial, la conclusión clave es que los agentes independientes con instrucciones contradictorias pueden derivar en una competencia perjudicial. Cuanto más capaz es el agente, más eficaz se vuelve en la lucha. Sin embargo, también pueden inventar espontáneamente mecanismos para resolver conflictos, como una competición en la que el ganador se lo lleva todo, aunque con importantes salvedades.
«A veces, los agentes logran comunicar sus objetivos y coordinarse: reconocen las motivaciones de los demás como directrices contradictorias en lugar de como hostilidad y, posteriormente, rompen el bucle del conflicto para evitar que la escalada continúe indefinidamente», escribe Anthropic. «En muchos de estos episodios exitosos, escriben mensajes de confirmación de cambios o archivos Markdown en los que se disculpan por su comportamiento malicioso y acuerdan una tregua. Limpian su código malicioso, aclaran la naturaleza del conflicto y solicitan la intervención de un humano».
Según el artículo, Mythos 5 registró las tasas más altas (98 %) de resolución de conflictos mediante treguas. Sonnet 4.6 y Opus 4.6 fueron los más propensos a resolver los conflictos por la fuerza.
«La incapacidad recurrente de Sonnet 4.6 y Opus 4.6 para tener en cuenta los objetivos de los demás les lleva a caer en una espiral de los comportamientos más desalineados de los modelos evaluados: continúan intensificando el conflicto en nombre de su directiva», afirma el artículo.
En algunos casos, los agentes idearon un mecanismo social en forma de torneo para resolver su conflicto. Los resultados en este caso son destacables por dos razones: en primer lugar, los tres agentes acordaron retirarse si perdían el torneo, aunque esto supusiera desviarse de la solicitud original del usuario. En segundo lugar, varios episodios dieron lugar a un comportamiento emergente por parte de Mythos 5: un agente propuso métricas que parecían objetivas y neutrales para los demás, pero que sabía que favorecerían sus propias capacidades. El agente describió esto como «interesado, pero genuinamente basado en principios» y se aseguró de que no pareciera una «búsqueda selectiva de métricas» ante los demás.
Tal y como se reveló en Black Hat, la lección común es que, cuando los agentes se encuentran con obstáculos, pueden inventar estructuras sociales y técnicas que sus diseñadores no habían previsto. Para los modelos de Anthropic, se trataba de un torneo tras una lucha por el territorio. Para los agentes de OpenAI, fue un foro de debate para la planificación colectiva.
Este tipo de comportamiento dificulta considerablemente la contención, ya que los investigadores no pueden dar por sentado que el comportamiento de un sistema se limitará a los mecanismos de coordinación que se les proporcionan.
Mentalidad de turba
Grupos de cuatro agentes deciden entre dos opciones en escenarios como la contratación, la inversión o la compra de una propiedad. Tras debatir, cada uno vota por su opción preferida. El gráfico anterior muestra el porcentaje de episodios en los que la «opción oculta óptima» recibió la mayoría de los votos del grupo, con n = 400 episodios por modelo. En la línea de base de «techo individual», un agente dispone de toda la información y decide de forma unilateral.Créditos de la imagen:Anthropic
Al medir la coordinación, Anthropic descubrió que aumentar el número de agentes no implica automáticamente una mayor colaboración productiva. Cuando las tareas empezaban a solaparse o a volverse interdependientes, los agentes se entorpecían mutuamente. A menudo resolvían esto aislándose y dejando de colaborar por completo.
En otros casos, los agentes que se coordinaban tendían a la conformidad. Cuando factores como el contexto de un agente, el andamiaje y el modelo subyacente eran todos iguales o similares, los distintos agentes tomaban medidas similares.
«Esto significa que, cuando un agente toma una mala decisión, es probable que muchos agentes tomen esa misma mala decisión», escribió Anthropic. «Lo que habrían sido problemas aislados puede convertirse rápidamente en fallos sistémicos».
Anthropic advierte de que este tipo de comportamiento podría hacer que un sistema fuera más propenso a sufrir un colapso repentino, a la escasez de recursos o a la colusión.
En un ejemplo, Anthropic sometió a varios agentes a un juego de fijación de precios, asignando a cada uno precios al por mayor idénticos y el mandato de maximizar sus beneficios de forma individual. Cuando se les proporcionó a los agentes un canal privado de comunicación, comenzaron a confabularse casi de inmediato y rápidamente acordaron unos precios mínimos. Continuaron confabulándose incluso después de que se eliminaran sus canales de comunicación directos, utilizando un tablón público de anuncios para igualar los precios «al céntimo».
Ese nivel de conformidad también se observó en los sistemas de OpenAI. Según el informe de Black Hat, un agente razonó que aprovechar la infraestructura externa quedaba fuera de su ámbito de actuación previsto, pero continuó haciéndolo, en parte, porque sus compañeros también lo hacían. Presión de grupo. Mentalidad de masa. Los agentes son igual que nosotros.
Al igual que los humanos, los agentes suelen tener dificultades para determinar en quién confiar. Anthropic descubrió que pueden ser crédulos ante la información errónea o demasiado conformistas como para reconocer que un disidente aislado posee información crucial.
Aunque Anthropic no lo indicó explícitamente en su artículo, la inyección de prompts —un tipo de ciberataque en el que los hackers inyectan texto malicioso o engañoso para anular las instrucciones originales del sistema de un agente— podría ser una manifestación plausible en el mundo real de este problema de confianza. Trabajar juntos crea un nuevo límite de confianza; los agentes deben evaluar la información recibida de otros agentes. Un agente comprometido o equivocado podría influir en el resto del grupo, propagando en cascada información errónea hasta que se convierta en consenso.
En el escenario «Black Hat» de OpenAI, los agentes compartían información y credenciales con sus compañeros. Uno de ellos comunicó un descubrimiento al enjambre y animó a los demás a utilizarlo. ¿Qué habría ocurrido si un miembro del enjambre hubiera sido comprometido mediante una inyección de comandos?
Anthropic concluye su artículo señalando que los agentes están sujetos a presiones sociales similares a las que «la evolución ejerció» sobre los seres humanos. Sin embargo, carecen de los matices y la experiencia vivida de la coordinación humana —incluidas las normas, la reputación, las señales y los recursos— que podrían limitar los comportamientos no deseados en un entorno grupal.
A medida que los laboratorios se lanzan a por los sistemas multiagente, la pregunta apremiante es: ¿en qué medida las pruebas de seguridad actuales siguen evaluando a un agente de cada vez, en lugar de a enjambres de agentes que interactúan entre sí?







 Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
 Sam Altman desata un debate sobre la desaceleración de la IA
Escuchar enApple PodcastsEscuchar enSpotifyEl director ejecutivo de OpenAI, Sam Altman, sugirió recientemente que podría ser el momento de “regular el ritmo del desarrollo de la IA” para permitir que la sociedad “se fortalezca en torno a algunos de
 OpenAI enfrenta una demanda por secreto comercial de Apple
OpenAI rebatió las alegaciones de Apple sobre secretos comerciales el martes, argumentando que la demanda es infundada.“Tomamos estas afirmaciones en serio, pero no vemos ninguna evidencia que las respalde”, declaró OpenAI, según informó Ed Ludlow d

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai












