


 Lar
Xiaohongshu apresenta o BigMac: superando o conflito entre memória e velocidade no treinamento multimodal
Os modelos de linguagem multimodais de grande porte estão se tornando a pedra angular da IA de próxima geração; no entanto, sua infraestrutura de treinamento tem sido há muito tempo prejudicada por um dilema persistente: os sistemas otimizados para velocidade frequentemente enfrentam restrições de memória, enquanto aqueles que priorizam a eficiência de memória tendem a ser lentos. A equipe Dots Infra da Xiaohongshu identifica esse gargalo como a fronteira de Pareto do treinamento em pipeline multimodal e agora conseguiu superá-lo. Em 22 de julho, a equipe disponibilizou como código aberto o BigMac, um novo paradigma de treinamento paralelo em pipeline projetado especificamente para cenários multimodais nativos. O projeto já está disponível no GitHub no repositório Dots-Infra.
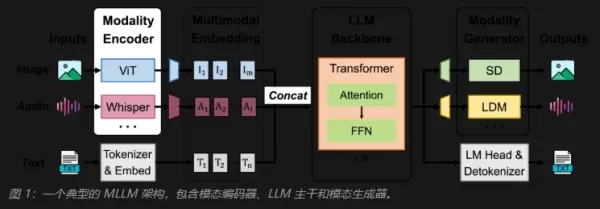
Ao contrário dos transformadores padrão, os modelos multimodais são inerentemente complexos. Um Modelo de Linguagem Grande Multimodal (MLLM) típico compreende três componentes distintos: codificadores modais que convertem imagens e áudio em representações, uma estrutura central de LLM para inferência e um gerador que mapeia as saídas do LLM de volta para as modalidades-alvo, como imagens ou fala. As diferenças estruturais significativas entre esses componentes criam desafios substanciais ao integrá-los em um único pipeline de treinamento.
As soluções atuais do setor geralmente se enquadram em duas categorias. A primeira abordagem prioriza a eficiência computacional ao desacoplar codificadores e geradores do pipeline do LLM, executando-os separadamente. Isso evita que flutuações na duração dos módulos modais criem “bolhas” no pipeline do LLM, mas faz com que a memória de ativação aumente proporcionalmente ao número de micro-lotes, levando a altos custos em escala. A segunda abordagem se concentra na eficiência de memória, mantendo todos os módulos dentro do mesmo pipeline, o que encurta os ciclos de vida das ativações e reduz o uso de memória. No entanto, se qualquer codificador ou gerador for lento, todo o pipeline de LLM fica paralisado, resultando em “bolhas de cauda”. À medida que a escala do modelo aumenta, ambos os projetos revelam gargalos críticos.
O BigMac aborda esse desafio com um princípio simples, mas fundamental: o pipeline central do LLM continua sendo o foco principal. O treinamento de LLMs em grande escala já conta com estratégias maduras de agendamento, como 1F1B ou 1F1B intercalado, que estão profundamente integradas em pilhas de treinamento de nível de produção. Em vez de substituir esses métodos estabelecidos, o BigMac usa o cronograma do LLM como sua linha do tempo subjacente, inserindo estrategicamente os cálculos do codificador e do gerador quando as entradas estão prontas e sem interromper a ordem de execução do LLM. A equipe se refere a essa arquitetura como um “pipeline aninhado quase seguro contra dependências”.
Esse projeto oferece duas vantagens principais. Primeiro, as flutuações na duração do codificador e do gerador não se propagam mais pelo pipeline do LLM, permitindo que o LLM mantenha seu ritmo ideal. Segundo, os requisitos de memória para ativações modais são reduzidos a O(1) no nível algorítmico. Os codificadores não precisam mais reter ativações para todos os micro-lotes até que o pipeline seja concluído, e os geradores evitam prolongar longas caudas de ativação. Essencialmente, o BigMac não troca memória por picos de desempenho; em vez disso, ele reestrutura a lógica de agendamento para tornar esses dois objetivos compatíveis, em vez de mutuamente exclusivos.
Preencher a lacuna entre o projeto do agendamento e a execução real envolve desafios de engenharia significativos, incluindo integração de sistemas, definição de interfaces e depuração de desempenho. O BigMac foi projetado para lidar com esses desafios específicos, oferecendo três recursos principais. Primeiro, ele torna o agendamento global transparente: o agendador gera uma tabela abrangente de operadores que cobre todas as instâncias do pipeline, micro-lotes e tipos de módulos em tempo de execução. O executor, então, distribui esses elementos em sequências locais para cada rank, integrando-se perfeitamente a back-ends de LLM como o Megatron Core, ambientes de execução modais e camadas de comunicação. Essa visibilidade facilita a verificação e a otimização do back-end.
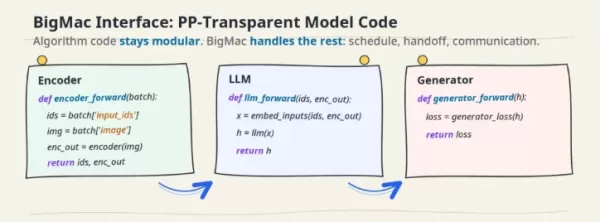
Em segundo lugar, o BigMac oferece uma interface de paralelismo de pipeline que permanece invisível para os engenheiros de algoritmos. Os usuários precisam apenas definir o que cada módulo produz e consome; o sistema lida internamente com a divisão de estágios, ativação e transferência de gradientes, além da comunicação entre dispositivos. Isso permite que experimentos multimodais verificados em uma única GPU sejam escalonados naturalmente para o paralelismo de pipeline. Em terceiro lugar, ele fornece um conjunto de ferramentas de perfilagem, simulação e visualização. Essas ferramentas detalham as iterações de treinamento até o nível do operador, revelando exatamente o que cada rank está fazendo a cada passo temporal, identificando períodos de inatividade e destacando gargalos de dependência. O simulador também permite que as equipes testem várias configurações de PP e combinações de micro-lotes antes de iniciar o treinamento em escala real, estimando seu impacto nas bolhas e na taxa de processamento.
A eficácia do BigMac foi validada em duas cargas de trabalho representativas. Em tarefas de compreensão de MLLM, utilizando o Qwen3-30B-A3B como estrutura base e um codificador ViT de 1,3B, o BigMac alcança um aumento de velocidade de 1,08x a 1,1x em comparação com o Optimus, que é a linha de base computacionalmente eficiente, e um aumento de 1,6x a 1,9x em relação ao Megatron-DistTrain, que é a linha de base eficiente em termos de memória. Fundamentalmente, o uso de memória permanece estável à medida que o tamanho do lote por GPU aumenta, enquanto o Optimus sofre picos de consumo de memória que acabam levando a erros de falta de memória (OOM) em lotes maiores. As tarefas de geração MLLM são mais complexas, envolvendo um gerador MMDiT de 20 bilhões, onde a diferença de desempenho se amplia ainda mais: o Optimus falha em todos os tamanhos de lote testados devido a erros de OOM, enquanto o BigMac evita isso ao executar o gerador de forma eficiente em sentido reverso e liberar rapidamente as ativações. Em comparação com o Megatron-DistTrain, o BigMac ainda oferece um aumento de velocidade de 1,5x a 1,9x com uso estável de memória. Isso destaca o principal valor dos pipelines aninhados: atender às dependências tanto do codificador quanto do gerador sem retenção excessiva de ativações ou tempo de inatividade significativo.
O BigMac é agora um componente central da infraestrutura de treinamento de modelos multimodais da Dots e opera no ambiente de produção do Xiaohongshu. O artigo que acompanha o projeto, “BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training”, está disponível no arXiv, juntamente com exemplos interativos de rastreamento do PP Profiler. Para pesquisadores e engenheiros que enfrentam o dilema entre memória e velocidade no treinamento multimodal, este projeto de código aberto validado em produção oferece uma solução prática que economiza tempo e esforço significativos.
Artigo relacionado
 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro
Recomendações de tópicos especiais relacionados
Análise de dados
 Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
 10 ferramentas
 xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

 Comentários (10)
![JackMartinez]()
¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
![AlbertThomas]()
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
![BillyAnderson]()
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
![WillieAnderson]()
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
![BillyYoung]()
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
![JoseAdams]()
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !
Os modelos de linguagem multimodais de grande porte estão se tornando a pedra angular da IA de próxima geração; no entanto, sua infraestrutura de treinamento tem sido há muito tempo prejudicada por um dilema persistente: os sistemas otimizados para velocidade frequentemente enfrentam restrições de memória, enquanto aqueles que priorizam a eficiência de memória tendem a ser lentos. A equipe Dots Infra da Xiaohongshu identifica esse gargalo como a fronteira de Pareto do treinamento em pipeline multimodal e agora conseguiu superá-lo. Em 22 de julho, a equipe disponibilizou como código aberto o BigMac, um novo paradigma de treinamento paralelo em pipeline projetado especificamente para cenários multimodais nativos. O projeto já está disponível no GitHub no repositório Dots-Infra.
Ao contrário dos transformadores padrão, os modelos multimodais são inerentemente complexos. Um Modelo de Linguagem Grande Multimodal (MLLM) típico compreende três componentes distintos: codificadores modais que convertem imagens e áudio em representações, uma estrutura central de LLM para inferência e um gerador que mapeia as saídas do LLM de volta para as modalidades-alvo, como imagens ou fala. As diferenças estruturais significativas entre esses componentes criam desafios substanciais ao integrá-los em um único pipeline de treinamento.
As soluções atuais do setor geralmente se enquadram em duas categorias. A primeira abordagem prioriza a eficiência computacional ao desacoplar codificadores e geradores do pipeline do LLM, executando-os separadamente. Isso evita que flutuações na duração dos módulos modais criem “bolhas” no pipeline do LLM, mas faz com que a memória de ativação aumente proporcionalmente ao número de micro-lotes, levando a altos custos em escala. A segunda abordagem se concentra na eficiência de memória, mantendo todos os módulos dentro do mesmo pipeline, o que encurta os ciclos de vida das ativações e reduz o uso de memória. No entanto, se qualquer codificador ou gerador for lento, todo o pipeline de LLM fica paralisado, resultando em “bolhas de cauda”. À medida que a escala do modelo aumenta, ambos os projetos revelam gargalos críticos.
O BigMac aborda esse desafio com um princípio simples, mas fundamental: o pipeline central do LLM continua sendo o foco principal. O treinamento de LLMs em grande escala já conta com estratégias maduras de agendamento, como 1F1B ou 1F1B intercalado, que estão profundamente integradas em pilhas de treinamento de nível de produção. Em vez de substituir esses métodos estabelecidos, o BigMac usa o cronograma do LLM como sua linha do tempo subjacente, inserindo estrategicamente os cálculos do codificador e do gerador quando as entradas estão prontas e sem interromper a ordem de execução do LLM. A equipe se refere a essa arquitetura como um “pipeline aninhado quase seguro contra dependências”.
Esse projeto oferece duas vantagens principais. Primeiro, as flutuações na duração do codificador e do gerador não se propagam mais pelo pipeline do LLM, permitindo que o LLM mantenha seu ritmo ideal. Segundo, os requisitos de memória para ativações modais são reduzidos a O(1) no nível algorítmico. Os codificadores não precisam mais reter ativações para todos os micro-lotes até que o pipeline seja concluído, e os geradores evitam prolongar longas caudas de ativação. Essencialmente, o BigMac não troca memória por picos de desempenho; em vez disso, ele reestrutura a lógica de agendamento para tornar esses dois objetivos compatíveis, em vez de mutuamente exclusivos.
Preencher a lacuna entre o projeto do agendamento e a execução real envolve desafios de engenharia significativos, incluindo integração de sistemas, definição de interfaces e depuração de desempenho. O BigMac foi projetado para lidar com esses desafios específicos, oferecendo três recursos principais. Primeiro, ele torna o agendamento global transparente: o agendador gera uma tabela abrangente de operadores que cobre todas as instâncias do pipeline, micro-lotes e tipos de módulos em tempo de execução. O executor, então, distribui esses elementos em sequências locais para cada rank, integrando-se perfeitamente a back-ends de LLM como o Megatron Core, ambientes de execução modais e camadas de comunicação. Essa visibilidade facilita a verificação e a otimização do back-end.
Em segundo lugar, o BigMac oferece uma interface de paralelismo de pipeline que permanece invisível para os engenheiros de algoritmos. Os usuários precisam apenas definir o que cada módulo produz e consome; o sistema lida internamente com a divisão de estágios, ativação e transferência de gradientes, além da comunicação entre dispositivos. Isso permite que experimentos multimodais verificados em uma única GPU sejam escalonados naturalmente para o paralelismo de pipeline. Em terceiro lugar, ele fornece um conjunto de ferramentas de perfilagem, simulação e visualização. Essas ferramentas detalham as iterações de treinamento até o nível do operador, revelando exatamente o que cada rank está fazendo a cada passo temporal, identificando períodos de inatividade e destacando gargalos de dependência. O simulador também permite que as equipes testem várias configurações de PP e combinações de micro-lotes antes de iniciar o treinamento em escala real, estimando seu impacto nas bolhas e na taxa de processamento.
A eficácia do BigMac foi validada em duas cargas de trabalho representativas. Em tarefas de compreensão de MLLM, utilizando o Qwen3-30B-A3B como estrutura base e um codificador ViT de 1,3B, o BigMac alcança um aumento de velocidade de 1,08x a 1,1x em comparação com o Optimus, que é a linha de base computacionalmente eficiente, e um aumento de 1,6x a 1,9x em relação ao Megatron-DistTrain, que é a linha de base eficiente em termos de memória. Fundamentalmente, o uso de memória permanece estável à medida que o tamanho do lote por GPU aumenta, enquanto o Optimus sofre picos de consumo de memória que acabam levando a erros de falta de memória (OOM) em lotes maiores. As tarefas de geração MLLM são mais complexas, envolvendo um gerador MMDiT de 20 bilhões, onde a diferença de desempenho se amplia ainda mais: o Optimus falha em todos os tamanhos de lote testados devido a erros de OOM, enquanto o BigMac evita isso ao executar o gerador de forma eficiente em sentido reverso e liberar rapidamente as ativações. Em comparação com o Megatron-DistTrain, o BigMac ainda oferece um aumento de velocidade de 1,5x a 1,9x com uso estável de memória. Isso destaca o principal valor dos pipelines aninhados: atender às dependências tanto do codificador quanto do gerador sem retenção excessiva de ativações ou tempo de inatividade significativo.
O BigMac é agora um componente central da infraestrutura de treinamento de modelos multimodais da Dots e opera no ambiente de produção do Xiaohongshu. O artigo que acompanha o projeto, “BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training”, está disponível no arXiv, juntamente com exemplos interativos de rastreamento do PP Profiler. Para pesquisadores e engenheiros que enfrentam o dilema entre memória e velocidade no treinamento multimodal, este projeto de código aberto validado em produção oferece uma solução prática que economiza tempo e esforço significativos.








 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
 Startup sueca de IA Lovable Eyes tem avaliação de US$ 13,2 bilhões após rodada principal de investimentos
À medida que as ferramentas de codificação impulsionadas por IA ganham tração, a startup sueca Lovable garantiu uma grande rodada de financiamento. A empresa visa captar US$ 3 bilhões, o que poderia elevar sua avaliação para US$ 13,2 bilhões — o dobr
O Google testa o Agente Remy AI para o Gemini, à medida que o foco se desloca para o controle do usuário
De acordo com o Business Insider, o Google está testando o Remy, um novo agente pessoal de IA para o Gemini. Esta ferramenta tem como objetivo executar tarefas em nome dos usuários, simplificando tanto os fluxos de trabalho profissionais quanto as ro

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !












