


 Дом
Xiaohongshu представляет BigMac: преодоление компромисса между объемом памяти и скоростью при мультимодальном обучении
Мультимодальные крупномасштабные языковые модели становятся краеугольным камнем искусственного интеллекта следующего поколения, однако развитие инфраструктуры для их обучения долгое время сдерживалось неизбежным компромиссом: системы, оптимизированные под скорость, часто сталкиваются с ограничениями по объему памяти, в то время как системы, в которых приоритет отдается эффективному использованию памяти, как правило, работают медленно. Команда Dots Infra в компании Xiaohongshu определила это узкое место как границу Парето в области обучения мультимодальных конвейеров и теперь преодолела его. 22 июля команда открыла исходный код BigMac — новой парадигмы параллельного обучения с использованием конвейера, разработанной специально для нативных мультимодальных сценариев. Проект теперь доступен на GitHub в репозитории Dots-Infra.
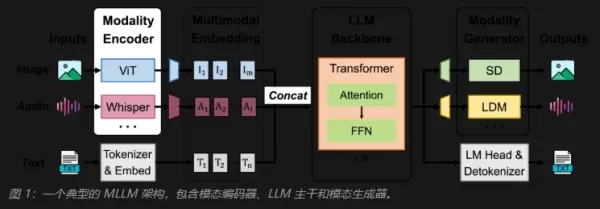
В отличие от стандартных трансформеров, мультимодальные модели по своей сути сложны. Типичная мультимодальная большая языковая модель (MLLM) состоит из трёх отдельных компонентов: модальных кодировщиков, преобразующих изображения и аудио в вложения; базовой структуры LLM для инференса; и генератора, который преобразует вывод LLM обратно в целевые модальности, такие как изображения или речь. Существенные структурные различия между этими компонентами создают серьезные проблемы при их интеграции в единый конвейер обучения.
Существующие в отрасли решения, как правило, делятся на две категории. Первый подход ставит во главу угла вычислительную эффективность, отделяя кодировщики и генераторы от конвейера LLM и запуская их отдельно. Это предотвращает появление «пузырей» в конвейере LLM из-за колебаний продолжительности работы модальных модулей, но приводит к тому, что объем памяти активаций растет пропорционально количеству микропартий, что влечет за собой высокие затраты при масштабировании. Второй подход ориентирован на эффективность использования памяти за счёт сохранения всех модулей в рамках одного конвейера, что сокращает жизненный цикл активаций и снижает потребление памяти. Однако если какой-либо кодер или генератор работает медленно, весь конвейер LLM останавливается, что приводит к появлению «хвостовых пузырей». По мере увеличения масштаба модели обе архитектуры демонстрируют критические узкие места.
BigMac решает эту проблему с помощью простого, но ключевого принципа: основное внимание по-прежнему уделяется основному конвейеру LLM. Обучение крупномасштабных LLM уже опирается на отработанные стратегии планирования, такие как 1F1B или чередующийся 1F1B, которые глубоко интегрированы в производственные стеки обучения. Вместо того чтобы заменять эти устоявшиеся методы, BigMac использует график LLM в качестве базовой временной шкалы, стратегически вставляя вычисления кодировщика и генератора, когда входные данные готовы, и не нарушая при этом порядок выполнения LLM. Команда называет эту архитектуру «вложенным конвейером с квазизащитой от зависимостей».
Такая конструкция обеспечивает два ключевых преимущества. Во-первых, колебания продолжительности работы кодировщика и генератора больше не распространяются по конвейеру LLM, что позволяет LLM поддерживать оптимальный темп работы. Во-вторых, требования к памяти для модальных активаций сокращаются до O(1) на алгоритмическом уровне. Кодировщикам больше не нужно сохранять активации для всех микропачек до завершения работы конвейера, а генераторы избегают удлинения длинных «хвостов» активаций. По сути, BigMac не жертвует памятью ради кратковременных всплесков производительности; вместо этого он перестраивает логику планирования, чтобы сделать эти две цели совместимыми, а не взаимоисключающими.
Преодоление разрыва между проектированием расписания и фактическим выполнением сопряжено со значительными инженерными трудностями, включая системную интеграцию, определение интерфейсов и отладку производительности. BigMac разработан для решения этих конкретных задач за счёт предоставления трёх ключевых возможностей. Во-первых, он делает глобальное расписание прозрачным: планировщик генерирует во время выполнения исчерпывающую таблицу операторов, охватывающую все ранги конвейера, микропартии и типы модулей. Затем исполнитель распределяет их по локальным последовательностям для каждого ранга, плавно интегрируясь с бэкендами LLM, такими как Megatron Core, модальными средами выполнения и уровнями взаимодействия. Такая прозрачность упрощает проверку и оптимизацию бэкенда.
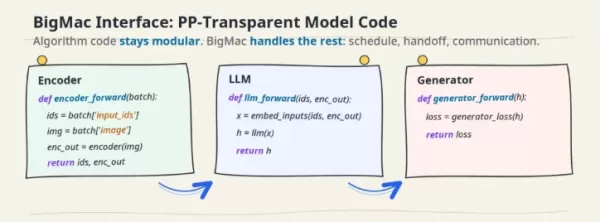
Во-вторых, BigMac предлагает интерфейс конвейерного параллелизма, который остается невидимым для разработчиков алгоритмов. Пользователям достаточно лишь определить, что производит и потребляет каждый модуль; система внутренне обрабатывает разделение на этапы, передачу активаций и градиентов, а также межустройственную коммуникацию. Это позволяет мультимодальным экспериментам, проверенным на одном графическом процессоре, естественным образом масштабироваться до уровня конвейерного параллелизма. В-третьих, он предоставляет набор инструментов для профилирования, моделирования и визуализации. Эти инструменты декомпозируют итерации обучения до уровня операторов, точно показывая, что делает каждый ранг на каждом временном шаге, выявляя периоды простоя и подчеркивая узкие места, связанные с зависимостями. Симулятор также позволяет командам тестировать различные конфигурации PP и комбинации микропартий перед переходом к полномасштабному обучению, оценивая их влияние на «пузыри» и пропускную способность.
Эффективность BigMac была подтверждена на двух типичных рабочих нагрузках. В задачах MLLM-Understanding с использованием Qwen3-30B-A3B в качестве базовой модели и кодировщика ViT объёмом 1,3 млрд, BigMac обеспечивает ускорение в 1,08–1,1 раза по сравнению с вычислительно эффективным базовым вариантом Optimus и в 1,6–1,9 раза — по сравнению с память-эффективным базовым вариантом Megatron-DistTrain. Важно отметить, что использование памяти остаётся стабильным при увеличении размера партии на один графический процессор, тогда как у Optimus наблюдаются пиковые скачки потребления памяти, которые в конечном итоге приводят к ошибкам «Out-of-Memory» (OOM) при работе с большими партиями. Задачи MLLM-Generation являются более сложными и включают генератор 20B MMDiT, где разрыв в производительности увеличивается ещё больше: Optimus терпит неудачу при всех тестируемых размерах партий из-за OOM, в то время как BigMac избегает этого за счёт эффективного выполнения генератора в обратном порядке и быстрого освобождения активаций. По сравнению с Megatron-DistTrain BigMac по-прежнему обеспечивает ускорение в 1,5–1,9 раза при стабильном использовании памяти. Это подчеркивает основное преимущество вложенных конвейеров: они обслуживают зависимости как кодировщика, так и генератора без чрезмерного удержания активаций или значительного времени простоя.
В настоящее время BigMac является ключевым компонентом инфраструктуры обучения мультимодальных моделей компании Dots и работает в производственной среде Xiaohongshu. Сопутствующая статья «BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training» доступна на arXiv вместе с интерактивными примерами трассировок PP Profiler. Для исследователей и инженеров, сталкивающихся с проблемой компромисса между объемом памяти и скоростью при мультимодальном обучении, этот проверенный в производственной среде проект с открытым исходным кодом предлагает практическое решение, позволяющее значительно сэкономить время и усилия.
Связанная статья
 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Рекомендации по связанным специальным темам
письмо
 Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
 8 инструментов
 xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

 Комментарии (10)
![JackMartinez]()
¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
![AlbertThomas]()
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
![BillyAnderson]()
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
![WillieAnderson]()
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
![BillyYoung]()
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
![JoseAdams]()
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !
Мультимодальные крупномасштабные языковые модели становятся краеугольным камнем искусственного интеллекта следующего поколения, однако развитие инфраструктуры для их обучения долгое время сдерживалось неизбежным компромиссом: системы, оптимизированные под скорость, часто сталкиваются с ограничениями по объему памяти, в то время как системы, в которых приоритет отдается эффективному использованию памяти, как правило, работают медленно. Команда Dots Infra в компании Xiaohongshu определила это узкое место как границу Парето в области обучения мультимодальных конвейеров и теперь преодолела его. 22 июля команда открыла исходный код BigMac — новой парадигмы параллельного обучения с использованием конвейера, разработанной специально для нативных мультимодальных сценариев. Проект теперь доступен на GitHub в репозитории Dots-Infra.
В отличие от стандартных трансформеров, мультимодальные модели по своей сути сложны. Типичная мультимодальная большая языковая модель (MLLM) состоит из трёх отдельных компонентов: модальных кодировщиков, преобразующих изображения и аудио в вложения; базовой структуры LLM для инференса; и генератора, который преобразует вывод LLM обратно в целевые модальности, такие как изображения или речь. Существенные структурные различия между этими компонентами создают серьезные проблемы при их интеграции в единый конвейер обучения.
Существующие в отрасли решения, как правило, делятся на две категории. Первый подход ставит во главу угла вычислительную эффективность, отделяя кодировщики и генераторы от конвейера LLM и запуская их отдельно. Это предотвращает появление «пузырей» в конвейере LLM из-за колебаний продолжительности работы модальных модулей, но приводит к тому, что объем памяти активаций растет пропорционально количеству микропартий, что влечет за собой высокие затраты при масштабировании. Второй подход ориентирован на эффективность использования памяти за счёт сохранения всех модулей в рамках одного конвейера, что сокращает жизненный цикл активаций и снижает потребление памяти. Однако если какой-либо кодер или генератор работает медленно, весь конвейер LLM останавливается, что приводит к появлению «хвостовых пузырей». По мере увеличения масштаба модели обе архитектуры демонстрируют критические узкие места.
BigMac решает эту проблему с помощью простого, но ключевого принципа: основное внимание по-прежнему уделяется основному конвейеру LLM. Обучение крупномасштабных LLM уже опирается на отработанные стратегии планирования, такие как 1F1B или чередующийся 1F1B, которые глубоко интегрированы в производственные стеки обучения. Вместо того чтобы заменять эти устоявшиеся методы, BigMac использует график LLM в качестве базовой временной шкалы, стратегически вставляя вычисления кодировщика и генератора, когда входные данные готовы, и не нарушая при этом порядок выполнения LLM. Команда называет эту архитектуру «вложенным конвейером с квазизащитой от зависимостей».
Такая конструкция обеспечивает два ключевых преимущества. Во-первых, колебания продолжительности работы кодировщика и генератора больше не распространяются по конвейеру LLM, что позволяет LLM поддерживать оптимальный темп работы. Во-вторых, требования к памяти для модальных активаций сокращаются до O(1) на алгоритмическом уровне. Кодировщикам больше не нужно сохранять активации для всех микропачек до завершения работы конвейера, а генераторы избегают удлинения длинных «хвостов» активаций. По сути, BigMac не жертвует памятью ради кратковременных всплесков производительности; вместо этого он перестраивает логику планирования, чтобы сделать эти две цели совместимыми, а не взаимоисключающими.
Преодоление разрыва между проектированием расписания и фактическим выполнением сопряжено со значительными инженерными трудностями, включая системную интеграцию, определение интерфейсов и отладку производительности. BigMac разработан для решения этих конкретных задач за счёт предоставления трёх ключевых возможностей. Во-первых, он делает глобальное расписание прозрачным: планировщик генерирует во время выполнения исчерпывающую таблицу операторов, охватывающую все ранги конвейера, микропартии и типы модулей. Затем исполнитель распределяет их по локальным последовательностям для каждого ранга, плавно интегрируясь с бэкендами LLM, такими как Megatron Core, модальными средами выполнения и уровнями взаимодействия. Такая прозрачность упрощает проверку и оптимизацию бэкенда.
Во-вторых, BigMac предлагает интерфейс конвейерного параллелизма, который остается невидимым для разработчиков алгоритмов. Пользователям достаточно лишь определить, что производит и потребляет каждый модуль; система внутренне обрабатывает разделение на этапы, передачу активаций и градиентов, а также межустройственную коммуникацию. Это позволяет мультимодальным экспериментам, проверенным на одном графическом процессоре, естественным образом масштабироваться до уровня конвейерного параллелизма. В-третьих, он предоставляет набор инструментов для профилирования, моделирования и визуализации. Эти инструменты декомпозируют итерации обучения до уровня операторов, точно показывая, что делает каждый ранг на каждом временном шаге, выявляя периоды простоя и подчеркивая узкие места, связанные с зависимостями. Симулятор также позволяет командам тестировать различные конфигурации PP и комбинации микропартий перед переходом к полномасштабному обучению, оценивая их влияние на «пузыри» и пропускную способность.
Эффективность BigMac была подтверждена на двух типичных рабочих нагрузках. В задачах MLLM-Understanding с использованием Qwen3-30B-A3B в качестве базовой модели и кодировщика ViT объёмом 1,3 млрд, BigMac обеспечивает ускорение в 1,08–1,1 раза по сравнению с вычислительно эффективным базовым вариантом Optimus и в 1,6–1,9 раза — по сравнению с память-эффективным базовым вариантом Megatron-DistTrain. Важно отметить, что использование памяти остаётся стабильным при увеличении размера партии на один графический процессор, тогда как у Optimus наблюдаются пиковые скачки потребления памяти, которые в конечном итоге приводят к ошибкам «Out-of-Memory» (OOM) при работе с большими партиями. Задачи MLLM-Generation являются более сложными и включают генератор 20B MMDiT, где разрыв в производительности увеличивается ещё больше: Optimus терпит неудачу при всех тестируемых размерах партий из-за OOM, в то время как BigMac избегает этого за счёт эффективного выполнения генератора в обратном порядке и быстрого освобождения активаций. По сравнению с Megatron-DistTrain BigMac по-прежнему обеспечивает ускорение в 1,5–1,9 раза при стабильном использовании памяти. Это подчеркивает основное преимущество вложенных конвейеров: они обслуживают зависимости как кодировщика, так и генератора без чрезмерного удержания активаций или значительного времени простоя.
В настоящее время BigMac является ключевым компонентом инфраструктуры обучения мультимодальных моделей компании Dots и работает в производственной среде Xiaohongshu. Сопутствующая статья «BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training» доступна на arXiv вместе с интерактивными примерами трассировок PP Profiler. Для исследователей и инженеров, сталкивающихся с проблемой компромисса между объемом памяти и скоростью при мультимодальном обучении, этот проверенный в производственной среде проект с открытым исходным кодом предлагает практическое решение, позволяющее значительно сэкономить время и усилия.








 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !












