


 Heim
Xiaohongshu stellt „BigMac“ vor: Überwindung des Kompromisses zwischen Speicher und Geschwindigkeit beim multimodalen Training
Multimodale große Sprachmodelle entwickeln sich zum Eckpfeiler der KI der nächsten Generation, doch ihre Trainingsinfrastruktur wurde lange Zeit durch einen hartnäckigen Zielkonflikt behindert: Auf Geschwindigkeit optimierte Systeme haben oft mit Speicherbeschränkungen zu kämpfen, während solche, die auf Speichereffizienz setzen, in der Regel langsam sind. Das Dots-Infra-Team bei Xiaohongshu identifiziert diesen Engpass als die Pareto-Grenze des multimodalen Pipeline-Trainings und hat diese nun durchbrochen. Am 22. Juli veröffentlichte das Team „BigMac“ als Open-Source-Projekt – ein neuartiges Paradigma für das parallele Training von Pipelines, das speziell für native multimodale Szenarien entwickelt wurde. Das Projekt ist nun auf GitHub im Dots-Infra-Repository verfügbar.
Im Gegensatz zu Standard-Transformern sind multimodale Modelle von Natur aus komplex. Ein typisches multimodales großes Sprachmodell (MLLM) besteht aus drei unterschiedlichen Komponenten: modalen Encodern, die Bilder und Audio in Einbettungen umwandeln, einem LLM-Backbone für die Inferenz und einem Generator, der die LLM-Ausgaben wieder auf Zielmodalitäten wie Bilder oder Sprache abbildet. Die erheblichen strukturellen Unterschiede zwischen diesen Komponenten führen zu großen Herausforderungen bei der Integration in eine einzige Trainingspipeline.
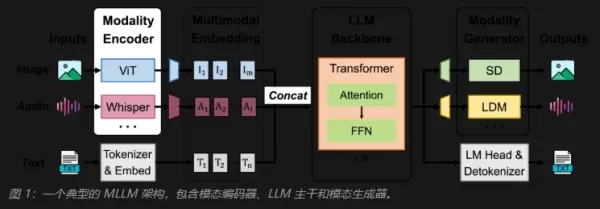
Aktuelle Branchenlösungen lassen sich im Allgemeinen in zwei Kategorien einteilen. Der erste Ansatz priorisiert die Recheneffizienz, indem Encoder und Generatoren von der LLM-Pipeline entkoppelt und separat ausgeführt werden. Dies verhindert zwar, dass Schwankungen in der Laufzeit der Modalitätsmodule zu „Bubbles“ in der LLM-Pipeline führen, bewirkt jedoch, dass der Aktivierungsspeicher mit der Anzahl der Mikrobatches skaliert, was bei großem Maßstab zu hohen Kosten führt. Der zweite Ansatz konzentriert sich auf Speichereffizienz, indem alle Module in derselben Pipeline verbleiben, was die Lebenszyklen der Aktivierungen verkürzt und den Speicherverbrauch senkt. Ist jedoch ein Encoder oder Generator langsam, kommt die gesamte LLM-Pipeline zum Stillstand, was zu „Tail-Bubbles“ führt. Mit zunehmender Modellgröße zeigen beide Entwürfe kritische Engpässe.
BigMac begegnet dieser Herausforderung mit einem einfachen, aber entscheidenden Prinzip: Die zentrale LLM-Pipeline bleibt im Mittelpunkt. Das Training groß angelegter LLMs stützt sich bereits auf ausgereifte Scheduling-Strategien wie 1F1B oder Interleaved 1F1B, die tief in produktionsreife Trainings-Stacks integriert sind. Anstatt diese etablierten Methoden zu ersetzen, nutzt BigMac den LLM-Zeitplan als zugrunde liegende Zeitachse und fügt Encoder- und Generator-Berechnungen strategisch ein, sobald Eingaben bereitstehen, ohne dabei die Ausführungsreihenfolge des LLM zu stören. Das Team bezeichnet diese Architektur als „quasi-abhängigkeitssichere verschachtelte Pipeline“.
Dieses Design bietet zwei wesentliche Vorteile. Erstens wirken sich Schwankungen in der Laufzeit von Encoder und Generator nicht mehr auf die gesamte LLM-Pipeline aus, sodass das LLM sein optimales Tempo beibehalten kann. Zweitens wird der Speicherbedarf für modale Aktivierungen auf algorithmischer Ebene auf O(1) reduziert. Encoder müssen die Aktivierungen nicht mehr für alle Mikrobatches bis zum Abschluss der Pipeline vorhalten, und Generatoren vermeiden es, lange Aktivierungsschwänze zu verlängern. Im Wesentlichen tauscht BigMac keinen Speicher gegen Leistungsblasen ein; stattdessen strukturiert es die Planungslogik neu, um diese beiden Ziele miteinander vereinbar zu machen, anstatt sie als sich gegenseitig ausschließend zu betrachten.
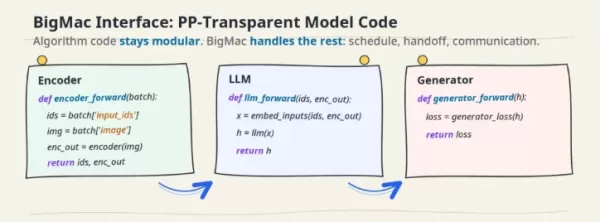
Die Überbrückung der Kluft zwischen Scheduling-Entwurf und tatsächlicher Ausführung ist mit erheblichen technischen Hürden verbunden, darunter Systemintegration, Schnittstellendefinition und Leistungsdebugging. BigMac wurde entwickelt, um diese spezifischen Herausforderungen durch drei Kernfunktionen zu bewältigen. Erstens macht es den globalen Zeitplan transparent: Der Scheduler generiert zur Laufzeit eine umfassende Operatortabelle, die alle Pipeline-Ränge, Mikrobatches und Modultypen abdeckt. Der Executor verteilt diese anschließend in lokale Sequenzen für jeden Rang und lässt sich nahtlos in LLM-Backends wie Megatron Core, modale Laufzeiten und Kommunikationsschichten integrieren. Diese Transparenz ermöglicht eine einfachere Überprüfung und Backend-Optimierung.
Zweitens bietet BigMac eine Schnittstelle für Pipeline-Parallelität, die für Algorithmusentwickler unsichtbar bleibt. Die Nutzer müssen lediglich definieren, was jedes Modul erzeugt und verbraucht; das System übernimmt intern die Aufteilung in Stufen, die Aktivierung und Übergabe von Gradienten sowie die geräteübergreifende Kommunikation. Dadurch lassen sich multimodale Experimente, die auf einer einzelnen GPU verifiziert wurden, nahtlos auf Pipeline-Parallelität skalieren. Drittens bietet es eine Reihe von Profiling-, Simulations- und Visualisierungstools. Diese Tools schlüsseln die Trainingsiterationen bis auf die Operatorenebene auf, zeigen genau, was jeder Rank in jedem Zeitschritt tut, identifizieren Leerlaufzeiten und heben Abhängigkeitsengpässe hervor. Der Simulator ermöglicht es Teams zudem, verschiedene PP-Konfigurationen und Mikrobatch-Kombinationen zu testen, bevor sie ein Training in vollem Umfang starten, und dabei deren Auswirkungen auf „Bubbles“ und den Durchsatz abzuschätzen.
Die Wirksamkeit von BigMac wurde anhand von zwei repräsentativen Workloads validiert. Bei MLLM-Understanding-Aufgaben, bei denen Qwen3-30B-A3B als Backbone und ein 1,3-Milliarden-ViT-Encoder verwendet wurden, erzielt BigMac eine Beschleunigung von 1,08- bis 1,1-fach im Vergleich zur recheneffizienten Baseline „Optimus“ sowie eine Beschleunigung von 1,6- bis 1,9-fach gegenüber der speichereffizienten Baseline „Megatron-DistTrain“. Entscheidend ist, dass der Speicherverbrauch stabil bleibt, wenn die Batchgröße pro GPU zunimmt, während bei Optimus Spitzen im Speicherbedarf auftreten, die bei größeren Batches schließlich zu „Out-of-Memory“ (OOM)-Fehlern führen. MLLM-Generation-Aufgaben sind komplexer und umfassen einen 20B-MMDiT-Generator, wobei sich der Leistungsunterschied weiter vergrößert: Optimus scheitert bei allen getesteten Batch-Größen aufgrund von OOM, während BigMac dies vermeidet, indem es den Generator effizient rückwärts ausführt und Aktivierungen schnell freigibt. Im Vergleich zu Megatron-DistTrain liefert BigMac immer noch eine 1,5- bis 1,9-fache Beschleunigung bei stabiler Speicherauslastung. Dies unterstreicht den Hauptvorteil verschachtelter Pipelines: Sie bedienen sowohl die Abhängigkeiten des Encoders als auch des Generators, ohne übermäßige Beibehaltung von Aktivierungen oder nennenswerte Leerlaufzeiten.
BigMac ist mittlerweile eine Kernkomponente der Infrastruktur von Dots für das Training multimodaler Modelle und wird in der Produktionsumgebung von Xiaohongshu eingesetzt. Die dazugehörige Veröffentlichung „BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training“ ist auf arXiv verfügbar, zusammen mit interaktiven PP-Profiler-Trace-Beispielen. Für Forscher und Ingenieure, die mit dem Kompromiss zwischen Speicher und Geschwindigkeit beim multimodalen Training zu kämpfen haben, bietet dieses in der Produktion bewährte Open-Source-Projekt eine praktische Lösung, die erheblich Zeit und Aufwand spart.
Verwandter Artikel
 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des
Empfehlungen zu verwandten Spezialthemen
Schreiben
 Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

 Kommentare (10)
![JackMartinez]()
¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
![AlbertThomas]()
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
![BillyAnderson]()
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
![WillieAnderson]()
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
![BillyYoung]()
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
![JoseAdams]()
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !
Multimodale große Sprachmodelle entwickeln sich zum Eckpfeiler der KI der nächsten Generation, doch ihre Trainingsinfrastruktur wurde lange Zeit durch einen hartnäckigen Zielkonflikt behindert: Auf Geschwindigkeit optimierte Systeme haben oft mit Speicherbeschränkungen zu kämpfen, während solche, die auf Speichereffizienz setzen, in der Regel langsam sind. Das Dots-Infra-Team bei Xiaohongshu identifiziert diesen Engpass als die Pareto-Grenze des multimodalen Pipeline-Trainings und hat diese nun durchbrochen. Am 22. Juli veröffentlichte das Team „BigMac“ als Open-Source-Projekt – ein neuartiges Paradigma für das parallele Training von Pipelines, das speziell für native multimodale Szenarien entwickelt wurde. Das Projekt ist nun auf GitHub im Dots-Infra-Repository verfügbar.
Im Gegensatz zu Standard-Transformern sind multimodale Modelle von Natur aus komplex. Ein typisches multimodales großes Sprachmodell (MLLM) besteht aus drei unterschiedlichen Komponenten: modalen Encodern, die Bilder und Audio in Einbettungen umwandeln, einem LLM-Backbone für die Inferenz und einem Generator, der die LLM-Ausgaben wieder auf Zielmodalitäten wie Bilder oder Sprache abbildet. Die erheblichen strukturellen Unterschiede zwischen diesen Komponenten führen zu großen Herausforderungen bei der Integration in eine einzige Trainingspipeline.
Aktuelle Branchenlösungen lassen sich im Allgemeinen in zwei Kategorien einteilen. Der erste Ansatz priorisiert die Recheneffizienz, indem Encoder und Generatoren von der LLM-Pipeline entkoppelt und separat ausgeführt werden. Dies verhindert zwar, dass Schwankungen in der Laufzeit der Modalitätsmodule zu „Bubbles“ in der LLM-Pipeline führen, bewirkt jedoch, dass der Aktivierungsspeicher mit der Anzahl der Mikrobatches skaliert, was bei großem Maßstab zu hohen Kosten führt. Der zweite Ansatz konzentriert sich auf Speichereffizienz, indem alle Module in derselben Pipeline verbleiben, was die Lebenszyklen der Aktivierungen verkürzt und den Speicherverbrauch senkt. Ist jedoch ein Encoder oder Generator langsam, kommt die gesamte LLM-Pipeline zum Stillstand, was zu „Tail-Bubbles“ führt. Mit zunehmender Modellgröße zeigen beide Entwürfe kritische Engpässe.
BigMac begegnet dieser Herausforderung mit einem einfachen, aber entscheidenden Prinzip: Die zentrale LLM-Pipeline bleibt im Mittelpunkt. Das Training groß angelegter LLMs stützt sich bereits auf ausgereifte Scheduling-Strategien wie 1F1B oder Interleaved 1F1B, die tief in produktionsreife Trainings-Stacks integriert sind. Anstatt diese etablierten Methoden zu ersetzen, nutzt BigMac den LLM-Zeitplan als zugrunde liegende Zeitachse und fügt Encoder- und Generator-Berechnungen strategisch ein, sobald Eingaben bereitstehen, ohne dabei die Ausführungsreihenfolge des LLM zu stören. Das Team bezeichnet diese Architektur als „quasi-abhängigkeitssichere verschachtelte Pipeline“.
Dieses Design bietet zwei wesentliche Vorteile. Erstens wirken sich Schwankungen in der Laufzeit von Encoder und Generator nicht mehr auf die gesamte LLM-Pipeline aus, sodass das LLM sein optimales Tempo beibehalten kann. Zweitens wird der Speicherbedarf für modale Aktivierungen auf algorithmischer Ebene auf O(1) reduziert. Encoder müssen die Aktivierungen nicht mehr für alle Mikrobatches bis zum Abschluss der Pipeline vorhalten, und Generatoren vermeiden es, lange Aktivierungsschwänze zu verlängern. Im Wesentlichen tauscht BigMac keinen Speicher gegen Leistungsblasen ein; stattdessen strukturiert es die Planungslogik neu, um diese beiden Ziele miteinander vereinbar zu machen, anstatt sie als sich gegenseitig ausschließend zu betrachten.
Die Überbrückung der Kluft zwischen Scheduling-Entwurf und tatsächlicher Ausführung ist mit erheblichen technischen Hürden verbunden, darunter Systemintegration, Schnittstellendefinition und Leistungsdebugging. BigMac wurde entwickelt, um diese spezifischen Herausforderungen durch drei Kernfunktionen zu bewältigen. Erstens macht es den globalen Zeitplan transparent: Der Scheduler generiert zur Laufzeit eine umfassende Operatortabelle, die alle Pipeline-Ränge, Mikrobatches und Modultypen abdeckt. Der Executor verteilt diese anschließend in lokale Sequenzen für jeden Rang und lässt sich nahtlos in LLM-Backends wie Megatron Core, modale Laufzeiten und Kommunikationsschichten integrieren. Diese Transparenz ermöglicht eine einfachere Überprüfung und Backend-Optimierung.
Zweitens bietet BigMac eine Schnittstelle für Pipeline-Parallelität, die für Algorithmusentwickler unsichtbar bleibt. Die Nutzer müssen lediglich definieren, was jedes Modul erzeugt und verbraucht; das System übernimmt intern die Aufteilung in Stufen, die Aktivierung und Übergabe von Gradienten sowie die geräteübergreifende Kommunikation. Dadurch lassen sich multimodale Experimente, die auf einer einzelnen GPU verifiziert wurden, nahtlos auf Pipeline-Parallelität skalieren. Drittens bietet es eine Reihe von Profiling-, Simulations- und Visualisierungstools. Diese Tools schlüsseln die Trainingsiterationen bis auf die Operatorenebene auf, zeigen genau, was jeder Rank in jedem Zeitschritt tut, identifizieren Leerlaufzeiten und heben Abhängigkeitsengpässe hervor. Der Simulator ermöglicht es Teams zudem, verschiedene PP-Konfigurationen und Mikrobatch-Kombinationen zu testen, bevor sie ein Training in vollem Umfang starten, und dabei deren Auswirkungen auf „Bubbles“ und den Durchsatz abzuschätzen.
Die Wirksamkeit von BigMac wurde anhand von zwei repräsentativen Workloads validiert. Bei MLLM-Understanding-Aufgaben, bei denen Qwen3-30B-A3B als Backbone und ein 1,3-Milliarden-ViT-Encoder verwendet wurden, erzielt BigMac eine Beschleunigung von 1,08- bis 1,1-fach im Vergleich zur recheneffizienten Baseline „Optimus“ sowie eine Beschleunigung von 1,6- bis 1,9-fach gegenüber der speichereffizienten Baseline „Megatron-DistTrain“. Entscheidend ist, dass der Speicherverbrauch stabil bleibt, wenn die Batchgröße pro GPU zunimmt, während bei Optimus Spitzen im Speicherbedarf auftreten, die bei größeren Batches schließlich zu „Out-of-Memory“ (OOM)-Fehlern führen. MLLM-Generation-Aufgaben sind komplexer und umfassen einen 20B-MMDiT-Generator, wobei sich der Leistungsunterschied weiter vergrößert: Optimus scheitert bei allen getesteten Batch-Größen aufgrund von OOM, während BigMac dies vermeidet, indem es den Generator effizient rückwärts ausführt und Aktivierungen schnell freigibt. Im Vergleich zu Megatron-DistTrain liefert BigMac immer noch eine 1,5- bis 1,9-fache Beschleunigung bei stabiler Speicherauslastung. Dies unterstreicht den Hauptvorteil verschachtelter Pipelines: Sie bedienen sowohl die Abhängigkeiten des Encoders als auch des Generators, ohne übermäßige Beibehaltung von Aktivierungen oder nennenswerte Leerlaufzeiten.
BigMac ist mittlerweile eine Kernkomponente der Infrastruktur von Dots für das Training multimodaler Modelle und wird in der Produktionsumgebung von Xiaohongshu eingesetzt. Die dazugehörige Veröffentlichung „BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training“ ist auf arXiv verfügbar, zusammen mit interaktiven PP-Profiler-Trace-Beispielen. Für Forscher und Ingenieure, die mit dem Kompromiss zwischen Speicher und Geschwindigkeit beim multimodalen Training zu kämpfen haben, bietet dieses in der Produktion bewährte Open-Source-Projekt eine praktische Lösung, die erheblich Zeit und Aufwand spart.








 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
 So beheben Sie Core Web Vitals für bessere SEO-Rankings
Berichtskartenkommentare mit KI-Tools optimierenEinführungKI-Tools zur Generierung von BerichtskartenkommentarenMagic SchoolAlmanac AIChat GPTNutzung von Magic School zur Generierung von BerichtskartenkommentarenAnmeldung bei Magic SchoolAuswahl des

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !












