


 Maison
Xiaohongshu dévoile BigMac : mettre fin au compromis entre mémoire et vitesse dans l'entraînement multimodal
Les grands modèles linguistiques multimodaux s'imposent comme la pierre angulaire de l'IA de nouvelle génération, mais leur infrastructure d'entraînement se heurte depuis longtemps à un dilemme récurrent : les systèmes optimisés pour la vitesse sont souvent limités par des contraintes de mémoire, tandis que ceux qui privilégient l'efficacité mémoire ont tendance à être lents. L’équipe Dots Infra de Xiaohongshu a identifié ce goulot d’étranglement comme la frontière de Pareto de l’entraînement des pipelines multimodaux et vient de le surmonter. Le 22 juillet, l’équipe a mis en open source BigMac, un nouveau paradigme d’entraînement parallèle en pipeline spécialement conçu pour les scénarios multimodaux natifs. Le projet est désormais disponible sur GitHub dans le dépôt Dots-Infra.
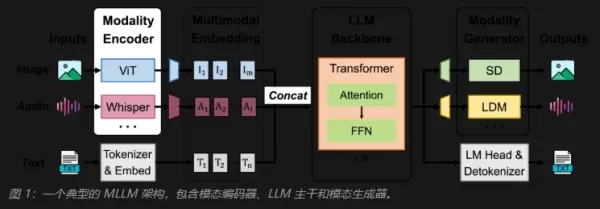
Contrairement aux transformateurs standard, les modèles multimodaux sont intrinsèquement complexes. Un grand modèle de langage multimodal (MLLM) typique comprend trois composants distincts : des encodeurs modaux qui convertissent les images et l’audio en représentations, une architecture LLM pour l’inférence, et un générateur qui reconvertit les sorties du LLM en modalités cibles telles que des images ou de la parole. Les différences structurelles significatives entre ces composants posent des défis de taille lors de leur intégration au sein d’un pipeline d’entraînement unique.
Les solutions actuelles du secteur se répartissent généralement en deux catégories. La première approche privilégie l’efficacité computationnelle en découplant les encodeurs et les générateurs du pipeline LLM, pour les exécuter séparément. Cela empêche les fluctuations de la durée des modules modaux de créer des « bulles » dans le pipeline LLM, mais entraîne une augmentation de la mémoire d’activation proportionnelle au nombre de micro-lots, ce qui se traduit par des coûts élevés à grande échelle. La deuxième approche met l’accent sur l’efficacité mémoire en conservant tous les modules au sein du même pipeline, ce qui raccourcit les cycles de vie des activations et réduit l’utilisation de la mémoire. Cependant, si un encodeur ou un générateur est lent, l’ensemble du pipeline LLM se bloque, ce qui entraîne l’apparition de « bulles de queue ». À mesure que l’échelle du modèle augmente, ces deux conceptions révèlent des goulots d’étranglement critiques.
BigMac relève ce défi grâce à un principe simple mais essentiel : le pipeline LLM principal reste au centre des préoccupations. L’entraînement des LLM à grande échelle s’appuie déjà sur des stratégies de planification éprouvées telles que 1F1B ou 1F1B entrelacé, qui sont profondément intégrées dans les piles d’entraînement de niveau production. Plutôt que de remplacer ces méthodes établies, BigMac utilise la planification du LLM comme ligne de temps sous-jacente, en insérant stratégiquement les calculs de l’encodeur et du générateur lorsque les entrées sont prêtes, sans perturber l’ordre d’exécution du LLM. L’équipe qualifie cette architecture de « pipeline imbriqué quasi-sûr en termes de dépendances ».
Cette conception offre deux avantages clés. Premièrement, les fluctuations de durée de l’encodeur et du générateur ne se répercutent plus sur le pipeline du LLM, ce qui permet à ce dernier de conserver son rythme optimal. Deuxièmement, les besoins en mémoire pour les activations modales sont réduits à O(1) au niveau algorithmique. Les encodeurs n’ont plus besoin de conserver les activations de tous les micro-lots jusqu’à la fin du pipeline, et les générateurs évitent de prolonger les longues queues d’activation. En substance, BigMac ne sacrifie pas la mémoire au profit de pics de performance ; il restructure plutôt la logique de planification afin de rendre ces deux objectifs compatibles plutôt que mutuellement exclusifs.
Combler le fossé entre la conception de la planification et l’exécution effective implique d’importants défis techniques, notamment l’intégration du système, la définition des interfaces et le débogage des performances. BigMac est conçu pour relever ces défis spécifiques en offrant trois capacités principales. Tout d’abord, il rend la planification globale transparente : le planificateur génère un tableau d’opérateurs complet couvrant tous les rangs du pipeline, les micro-lots et les types de modules lors de l’exécution. L’exécuteur les répartit ensuite en séquences locales pour chaque rang, s’intégrant de manière transparente aux backends LLM tels que Megatron Core, aux environnements d’exécution modaux et aux couches de communication. Cette visibilité facilite la vérification et l’optimisation du backend.
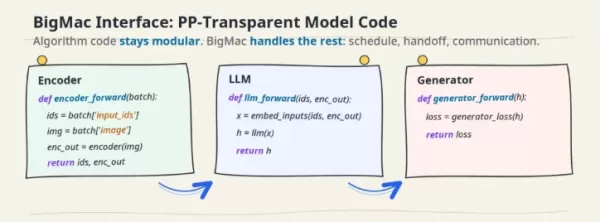
Deuxièmement, BigMac propose une interface de parallélisme de pipeline qui reste invisible pour les ingénieurs en algorithmes. Les utilisateurs n’ont qu’à définir ce que chaque module produit et consomme ; le système gère en interne la division en étapes, l’activation et le transfert de gradients, ainsi que la communication inter-périphériques. Cela permet aux expériences multimodales vérifiées sur un seul GPU de s’adapter naturellement au parallélisme de pipeline. Troisièmement, il fournit une suite d’outils de profilage, de simulation et de visualisation. Ces outils décomposent les itérations d’entraînement jusqu’au niveau des opérateurs, révélant exactement ce que fait chaque rang à chaque pas de temps, identifiant les périodes d’inactivité et mettant en évidence les goulots d’étranglement liés aux dépendances. Le simulateur permet également aux équipes de tester diverses configurations de PP et combinaisons de micro-lots avant de se lancer dans un apprentissage à grande échelle, en estimant leur impact sur les bulles et le débit.
L’efficacité de BigMac a été validée sur deux charges de travail représentatives. Dans les tâches MLLM-Understanding, en utilisant Qwen3-30B-A3B comme architecture de base et un encodeur ViT de 1,3 milliard de paramètres, BigMac atteint un gain de vitesse de 1,08x à 1,1x par rapport à la référence Optimus, efficace sur le plan computationnel, et un gain de 1,6x à 1,9x par rapport à la référence Megatron-DistTrain, efficace en termes de mémoire. Point crucial : l’utilisation de la mémoire reste stable à mesure que la taille des lots par GPU augmente, tandis qu’Optimus subit des pics de consommation de mémoire qui finissent par entraîner des erreurs « Out-of-Memory » (OOM) avec des lots plus volumineux. Les tâches de génération MLLM sont plus complexes, impliquant un générateur MMDiT de 20 milliards, où l’écart de performances se creuse encore davantage : Optimus échoue pour toutes les tailles de lots testées en raison d’erreurs OOM, tandis que BigMac évite ce problème en exécutant efficacement le générateur à rebours et en libérant rapidement les activations. Par rapport à Megatron-DistTrain, BigMac offre toujours un gain de vitesse de 1,5 à 1,9 fois supérieur avec une utilisation stable de la mémoire. Cela met en évidence la valeur principale des pipelines imbriqués : prendre en charge à la fois les dépendances de l’encodeur et celles du générateur sans rétention excessive des activations ni temps d’inactivité significatif.
BigMac est désormais un composant essentiel de l’infrastructure d’entraînement des modèles multimodaux de Dots et fonctionne au sein de l’environnement de production de Xiaohongshu. L’article qui l’accompagne, intitulé « BigMac : Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training », est disponible sur arXiv, ainsi que des exemples interactifs de traces générées par PP Profiler. Pour les chercheurs et les ingénieurs confrontés au compromis entre mémoire et vitesse dans l’entraînement multimodal, ce projet open source validé en production offre une solution pratique permettant un gain de temps et d’efforts considérable.
Article connexe
 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Recommandations de sujets spéciaux liés
Analyse des données
 Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
 10 outils
 xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

 commentaires (10)
![JackMartinez]()
¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
![AlbertThomas]()
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
![BillyAnderson]()
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
![WillieAnderson]()
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
![BillyYoung]()
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
![JoseAdams]()
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !
Les grands modèles linguistiques multimodaux s'imposent comme la pierre angulaire de l'IA de nouvelle génération, mais leur infrastructure d'entraînement se heurte depuis longtemps à un dilemme récurrent : les systèmes optimisés pour la vitesse sont souvent limités par des contraintes de mémoire, tandis que ceux qui privilégient l'efficacité mémoire ont tendance à être lents. L’équipe Dots Infra de Xiaohongshu a identifié ce goulot d’étranglement comme la frontière de Pareto de l’entraînement des pipelines multimodaux et vient de le surmonter. Le 22 juillet, l’équipe a mis en open source BigMac, un nouveau paradigme d’entraînement parallèle en pipeline spécialement conçu pour les scénarios multimodaux natifs. Le projet est désormais disponible sur GitHub dans le dépôt Dots-Infra.
Contrairement aux transformateurs standard, les modèles multimodaux sont intrinsèquement complexes. Un grand modèle de langage multimodal (MLLM) typique comprend trois composants distincts : des encodeurs modaux qui convertissent les images et l’audio en représentations, une architecture LLM pour l’inférence, et un générateur qui reconvertit les sorties du LLM en modalités cibles telles que des images ou de la parole. Les différences structurelles significatives entre ces composants posent des défis de taille lors de leur intégration au sein d’un pipeline d’entraînement unique.
Les solutions actuelles du secteur se répartissent généralement en deux catégories. La première approche privilégie l’efficacité computationnelle en découplant les encodeurs et les générateurs du pipeline LLM, pour les exécuter séparément. Cela empêche les fluctuations de la durée des modules modaux de créer des « bulles » dans le pipeline LLM, mais entraîne une augmentation de la mémoire d’activation proportionnelle au nombre de micro-lots, ce qui se traduit par des coûts élevés à grande échelle. La deuxième approche met l’accent sur l’efficacité mémoire en conservant tous les modules au sein du même pipeline, ce qui raccourcit les cycles de vie des activations et réduit l’utilisation de la mémoire. Cependant, si un encodeur ou un générateur est lent, l’ensemble du pipeline LLM se bloque, ce qui entraîne l’apparition de « bulles de queue ». À mesure que l’échelle du modèle augmente, ces deux conceptions révèlent des goulots d’étranglement critiques.
BigMac relève ce défi grâce à un principe simple mais essentiel : le pipeline LLM principal reste au centre des préoccupations. L’entraînement des LLM à grande échelle s’appuie déjà sur des stratégies de planification éprouvées telles que 1F1B ou 1F1B entrelacé, qui sont profondément intégrées dans les piles d’entraînement de niveau production. Plutôt que de remplacer ces méthodes établies, BigMac utilise la planification du LLM comme ligne de temps sous-jacente, en insérant stratégiquement les calculs de l’encodeur et du générateur lorsque les entrées sont prêtes, sans perturber l’ordre d’exécution du LLM. L’équipe qualifie cette architecture de « pipeline imbriqué quasi-sûr en termes de dépendances ».
Cette conception offre deux avantages clés. Premièrement, les fluctuations de durée de l’encodeur et du générateur ne se répercutent plus sur le pipeline du LLM, ce qui permet à ce dernier de conserver son rythme optimal. Deuxièmement, les besoins en mémoire pour les activations modales sont réduits à O(1) au niveau algorithmique. Les encodeurs n’ont plus besoin de conserver les activations de tous les micro-lots jusqu’à la fin du pipeline, et les générateurs évitent de prolonger les longues queues d’activation. En substance, BigMac ne sacrifie pas la mémoire au profit de pics de performance ; il restructure plutôt la logique de planification afin de rendre ces deux objectifs compatibles plutôt que mutuellement exclusifs.
Combler le fossé entre la conception de la planification et l’exécution effective implique d’importants défis techniques, notamment l’intégration du système, la définition des interfaces et le débogage des performances. BigMac est conçu pour relever ces défis spécifiques en offrant trois capacités principales. Tout d’abord, il rend la planification globale transparente : le planificateur génère un tableau d’opérateurs complet couvrant tous les rangs du pipeline, les micro-lots et les types de modules lors de l’exécution. L’exécuteur les répartit ensuite en séquences locales pour chaque rang, s’intégrant de manière transparente aux backends LLM tels que Megatron Core, aux environnements d’exécution modaux et aux couches de communication. Cette visibilité facilite la vérification et l’optimisation du backend.
Deuxièmement, BigMac propose une interface de parallélisme de pipeline qui reste invisible pour les ingénieurs en algorithmes. Les utilisateurs n’ont qu’à définir ce que chaque module produit et consomme ; le système gère en interne la division en étapes, l’activation et le transfert de gradients, ainsi que la communication inter-périphériques. Cela permet aux expériences multimodales vérifiées sur un seul GPU de s’adapter naturellement au parallélisme de pipeline. Troisièmement, il fournit une suite d’outils de profilage, de simulation et de visualisation. Ces outils décomposent les itérations d’entraînement jusqu’au niveau des opérateurs, révélant exactement ce que fait chaque rang à chaque pas de temps, identifiant les périodes d’inactivité et mettant en évidence les goulots d’étranglement liés aux dépendances. Le simulateur permet également aux équipes de tester diverses configurations de PP et combinaisons de micro-lots avant de se lancer dans un apprentissage à grande échelle, en estimant leur impact sur les bulles et le débit.
L’efficacité de BigMac a été validée sur deux charges de travail représentatives. Dans les tâches MLLM-Understanding, en utilisant Qwen3-30B-A3B comme architecture de base et un encodeur ViT de 1,3 milliard de paramètres, BigMac atteint un gain de vitesse de 1,08x à 1,1x par rapport à la référence Optimus, efficace sur le plan computationnel, et un gain de 1,6x à 1,9x par rapport à la référence Megatron-DistTrain, efficace en termes de mémoire. Point crucial : l’utilisation de la mémoire reste stable à mesure que la taille des lots par GPU augmente, tandis qu’Optimus subit des pics de consommation de mémoire qui finissent par entraîner des erreurs « Out-of-Memory » (OOM) avec des lots plus volumineux. Les tâches de génération MLLM sont plus complexes, impliquant un générateur MMDiT de 20 milliards, où l’écart de performances se creuse encore davantage : Optimus échoue pour toutes les tailles de lots testées en raison d’erreurs OOM, tandis que BigMac évite ce problème en exécutant efficacement le générateur à rebours et en libérant rapidement les activations. Par rapport à Megatron-DistTrain, BigMac offre toujours un gain de vitesse de 1,5 à 1,9 fois supérieur avec une utilisation stable de la mémoire. Cela met en évidence la valeur principale des pipelines imbriqués : prendre en charge à la fois les dépendances de l’encodeur et celles du générateur sans rétention excessive des activations ni temps d’inactivité significatif.
BigMac est désormais un composant essentiel de l’infrastructure d’entraînement des modèles multimodaux de Dots et fonctionne au sein de l’environnement de production de Xiaohongshu. L’article qui l’accompagne, intitulé « BigMac : Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training », est disponible sur arXiv, ainsi que des exemples interactifs de traces générées par PP Profiler. Pour les chercheurs et les ingénieurs confrontés au compromis entre mémoire et vitesse dans l’entraînement multimodal, ce projet open source validé en production offre une solution pratique permettant un gain de temps et d’efforts considérable.








 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !












