


 家
Xiaohongshuが「BigMac」を発表:マルチモーダル学習におけるメモリ容量と処理速度のトレードオフを打破
マルチモーダル大規模言語モデルは、次世代AIの基盤として台頭してきていますが、その学習インフラは長らく、根深いトレードオフに阻まれてきました。すなわち、速度を最適化したシステムはメモリの制約に悩まされがちであり、一方でメモリ効率を優先したシステムは処理速度が遅くなりがちです。 XiaohongshuのDots Infraチームは、このボトルネックをマルチモーダルパイプライン学習におけるパレート・フロンティアと位置づけ、ついにその壁を打ち破りました。 7月22日、同チームは、ネイティブマルチモーダルシナリオ向けに特別に設計された革新的なパイプライン並列学習パラダイム「BigMac」をオープンソース化しました。このプロジェクトは現在、GitHubの「Dots-Infra」リポジトリで公開されています。
標準的なトランスフォーマーとは異なり、マルチモーダルモデルは本質的に複雑です。典型的なマルチモーダル大規模言語モデル(MLLM)は、画像や音声を埋め込みベクトルに変換するモーダルエンコーダー、推論用のLLMバックボーン、そしてLLMの出力を画像や音声などのターゲットモダリティにマッピングするジェネレータという、3つの異なるコンポーネントで構成されています。 これらのコンポーネント間の構造的な違いは大きく、それらを単一のトレーニングパイプラインに統合する際に大きな課題となります。
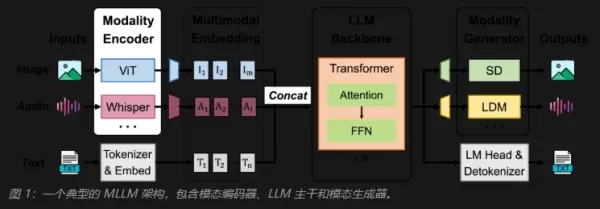
現在の業界のソリューションは、一般的に2つのカテゴリーに分類されます。1つ目のアプローチは、エンコーダーとジェネレーターをLLMパイプラインから切り離し、別々に実行することで、計算効率を優先します。これにより、モーダルモジュールの処理時間の変動によってLLMパイプラインに「バブル」が生じるのを防げますが、アクティベーションメモリがマイクロバッチ数に応じて増加するため、大規模化に伴いコストが高くなります。 2つ目のアプローチは、すべてのモジュールを同一のパイプライン内に保持することでメモリ効率に重点を置いており、これによりアクティベーションのライフサイクルが短縮され、メモリ使用量が削減されます。しかし、エンコーダーやジェネレーターのいずれかが遅くなると、LLMパイプライン全体が停滞し、テールバブルが発生してしまいます。モデルの規模が大きくなるにつれ、どちらの設計にも重大なボトルネックが現れます。
BigMacは、シンプルでありながら極めて重要な原則によってこの課題に対処しています。それは、中核となるLLMパイプラインを最優先とするというものです。大規模LLMのトレーニングでは、すでに1F1Bやインターリーブ型1F1Bといった成熟したスケジューリング戦略が採用されており、これらは本番環境レベルのトレーニングスタックに深く統合されています。 BigMacは、これらの確立された手法を置き換えるのではなく、LLMのスケジューリングを基盤となるタイムラインとして利用し、入力の準備が整ったタイミングで、LLMの実行順序を乱すことなく、エンコーダとジェネレータの計算を戦略的に挿入します。チームはこのアーキテクチャを「準依存性セーフなネストされたパイプライン」と呼んでいます。
この設計には2つの重要な利点がある。第一に、エンコーダーとジェネレーターの実行時間の変動がLLMパイプライン全体に波及しなくなるため、LLMは最適なペースを維持できる。第二に、モーダル活性化に必要なメモリ要件がアルゴリズムレベルでO(1)に削減される。 エンコーダーは、パイプラインが終了するまですべてのマイクロバッチの活性化状態を保持する必要がなくなり、ジェネレーターは長い活性化状態のテールを延長することを回避できる。本質的に、BigMacはパフォーマンス向上のためにメモリを犠牲にするのではなく、スケジューリングロジックを再構築することで、これら2つの目標を相互に排他的なものではなく、両立可能なものにする。
スケジューリング設計と実際の実行との間のギャップを埋めるには、システム統合、インターフェース定義、パフォーマンスのデバッグなど、大きな技術的課題が伴います。BigMacは、3つの中核的な機能を提供することで、これらの具体的な課題に対処するように設計されています。 第一に、グローバルなスケジュールを可視化します。スケジューラは、実行時にすべてのパイプラインランク、マイクロバッチ、およびモジュールタイプを網羅する包括的なオペレータテーブルを生成します。 その後、エグゼキュータがこれらを各ランクごとのローカルシーケンスに分散し、Megatron Core のような LLM バックエンド、モーダルランタイム、通信レイヤーとシームレスに統合します。この可視性により、チェックやバックエンドの最適化が容易になります。
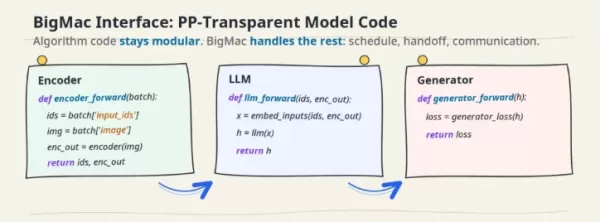
第二に、BigMacはアルゴリズムエンジニアには見えない形で機能するパイプライン並列インターフェースを提供します。ユーザーは各モジュールが何を生成し、何を消費するかを定義するだけで済み、ステージの分割、活性化および勾配の引き渡し、デバイス間通信はシステムが内部で処理します。これにより、単一のGPU上で検証されたマルチモーダル実験を、パイプライン並列処理へと自然に拡張することが可能になります。 第三に、BigMacはプロファイリング、シミュレーション、可視化ツールのスイートを提供します。これらのツールはトレーニングの反復処理をオペレーターレベルまで分解し、各タイムステップで各ランクが何を行っているかを正確に明らかにするとともに、アイドル期間を特定し、依存関係のボトルネックを強調表示します。 また、このシミュレーターを使用することで、チームは本格的なトレーニングに着手する前に、さまざまなPP構成やマイクロバッチの組み合わせをテストし、それらがバブルやスループットに与える影響を推定することができます。
BigMacの有効性は、2つの代表的なワークロードにおいて検証されています。MLLM-Understandingタスクにおいて、バックボーンとしてQwen3-30B-A3Bを使用し、1.3BのViTエンコーダを採用した場合、 BigMacは、計算効率に優れたベースラインであるOptimusと比較して1.08倍から1.1倍の高速化を達成し、メモリ効率に優れたベースラインであるMegatron-DistTrainと比較して1.6倍から1.9倍の高速化を実現しました。 重要な点として、GPU あたりのバッチサイズが増加してもメモリ使用量は安定しているのに対し、Optimus ではメモリ使用量がピーク時に急増し、最終的に大きなバッチサイズでメモリ不足(OOM)エラーが発生する。 MLLM-Generationタスクはより複雑で、20BのMMDiTジェネレータを伴うが、ここでは性能差がさらに拡大する。OptimusはOOMによりテストされたすべてのバッチサイズで失敗する一方、BigMacはジェネレータを逆方向に効率的に実行し、活性化値を迅速に解放することでこれを回避している。 Megatron-DistTrainと比較しても、BigMacは安定したメモリ使用量で1.5倍から1.9倍の高速化を実現しています。これは、ネストされたパイプラインの主な価値、すなわち、過度な活性化データの保持や著しいアイドル時間を生じさせることなく、エンコーダとジェネレータの両方の依存関係に対応できることを浮き彫りにしています。
BigMacは現在、Dotsのマルチモーダルモデル学習インフラの中核コンポーネントとなっており、Xiaohongshuの本番環境でも稼働しています。 付随する論文「BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training」は、インタラクティブなPP Profilerトレース例とともにarXivで公開されています。 マルチモーダル学習におけるメモリと速度のトレードオフに悩む研究者やエンジニアにとって、この実運用で実証済みのオープンソースプロジェクトは、時間と労力を大幅に節約する実用的な解決策を提供します。
関連記事
 米国の株式市場が歴史的なマイルストーンに到達、AIと航空宇宙の巨人が1兆ドル規模のデビューに向けて準備を進める
エロン・マスク、サム・アルトマン、ダリオ・アモダイというテクノロジー業界の三巨頭が、それぞれの事業で初公開株式発行(IPO)に向けて進んでいる。スペースX、OpenAI、Anthropicという業界の巨人3社が1兆ドル規模の企業価値に近づき、上場準備を進める中、2026年は米国史上、新規株式発行が最も重要な年となる見込みだ。この歴史的な資金増強は世界の金融の注目を集めており、公的市場がこのような規模の資金を吸収する能力に対する重要なストレステストとなっている。これらの主要な資金調達が一斉に開始
スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
関連特集おすすめ
データ分析
 SaaSおよびEコマースチーム向けのKPIモニタリングにおけるベストなAI異常検知ツール
2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
 10 ツール
 xix.ai
書き込み
長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

 コメント (10)
0/500
![JackMartinez]()
¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
![AlbertThomas]()
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
![BillyAnderson]()
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
![WillieAnderson]()
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
![BillyYoung]()
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
![JoseAdams]()
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !
マルチモーダル大規模言語モデルは、次世代AIの基盤として台頭してきていますが、その学習インフラは長らく、根深いトレードオフに阻まれてきました。すなわち、速度を最適化したシステムはメモリの制約に悩まされがちであり、一方でメモリ効率を優先したシステムは処理速度が遅くなりがちです。 XiaohongshuのDots Infraチームは、このボトルネックをマルチモーダルパイプライン学習におけるパレート・フロンティアと位置づけ、ついにその壁を打ち破りました。 7月22日、同チームは、ネイティブマルチモーダルシナリオ向けに特別に設計された革新的なパイプライン並列学習パラダイム「BigMac」をオープンソース化しました。このプロジェクトは現在、GitHubの「Dots-Infra」リポジトリで公開されています。
標準的なトランスフォーマーとは異なり、マルチモーダルモデルは本質的に複雑です。典型的なマルチモーダル大規模言語モデル(MLLM)は、画像や音声を埋め込みベクトルに変換するモーダルエンコーダー、推論用のLLMバックボーン、そしてLLMの出力を画像や音声などのターゲットモダリティにマッピングするジェネレータという、3つの異なるコンポーネントで構成されています。 これらのコンポーネント間の構造的な違いは大きく、それらを単一のトレーニングパイプラインに統合する際に大きな課題となります。
現在の業界のソリューションは、一般的に2つのカテゴリーに分類されます。1つ目のアプローチは、エンコーダーとジェネレーターをLLMパイプラインから切り離し、別々に実行することで、計算効率を優先します。これにより、モーダルモジュールの処理時間の変動によってLLMパイプラインに「バブル」が生じるのを防げますが、アクティベーションメモリがマイクロバッチ数に応じて増加するため、大規模化に伴いコストが高くなります。 2つ目のアプローチは、すべてのモジュールを同一のパイプライン内に保持することでメモリ効率に重点を置いており、これによりアクティベーションのライフサイクルが短縮され、メモリ使用量が削減されます。しかし、エンコーダーやジェネレーターのいずれかが遅くなると、LLMパイプライン全体が停滞し、テールバブルが発生してしまいます。モデルの規模が大きくなるにつれ、どちらの設計にも重大なボトルネックが現れます。
BigMacは、シンプルでありながら極めて重要な原則によってこの課題に対処しています。それは、中核となるLLMパイプラインを最優先とするというものです。大規模LLMのトレーニングでは、すでに1F1Bやインターリーブ型1F1Bといった成熟したスケジューリング戦略が採用されており、これらは本番環境レベルのトレーニングスタックに深く統合されています。 BigMacは、これらの確立された手法を置き換えるのではなく、LLMのスケジューリングを基盤となるタイムラインとして利用し、入力の準備が整ったタイミングで、LLMの実行順序を乱すことなく、エンコーダとジェネレータの計算を戦略的に挿入します。チームはこのアーキテクチャを「準依存性セーフなネストされたパイプライン」と呼んでいます。
この設計には2つの重要な利点がある。第一に、エンコーダーとジェネレーターの実行時間の変動がLLMパイプライン全体に波及しなくなるため、LLMは最適なペースを維持できる。第二に、モーダル活性化に必要なメモリ要件がアルゴリズムレベルでO(1)に削減される。 エンコーダーは、パイプラインが終了するまですべてのマイクロバッチの活性化状態を保持する必要がなくなり、ジェネレーターは長い活性化状態のテールを延長することを回避できる。本質的に、BigMacはパフォーマンス向上のためにメモリを犠牲にするのではなく、スケジューリングロジックを再構築することで、これら2つの目標を相互に排他的なものではなく、両立可能なものにする。
スケジューリング設計と実際の実行との間のギャップを埋めるには、システム統合、インターフェース定義、パフォーマンスのデバッグなど、大きな技術的課題が伴います。BigMacは、3つの中核的な機能を提供することで、これらの具体的な課題に対処するように設計されています。 第一に、グローバルなスケジュールを可視化します。スケジューラは、実行時にすべてのパイプラインランク、マイクロバッチ、およびモジュールタイプを網羅する包括的なオペレータテーブルを生成します。 その後、エグゼキュータがこれらを各ランクごとのローカルシーケンスに分散し、Megatron Core のような LLM バックエンド、モーダルランタイム、通信レイヤーとシームレスに統合します。この可視性により、チェックやバックエンドの最適化が容易になります。
第二に、BigMacはアルゴリズムエンジニアには見えない形で機能するパイプライン並列インターフェースを提供します。ユーザーは各モジュールが何を生成し、何を消費するかを定義するだけで済み、ステージの分割、活性化および勾配の引き渡し、デバイス間通信はシステムが内部で処理します。これにより、単一のGPU上で検証されたマルチモーダル実験を、パイプライン並列処理へと自然に拡張することが可能になります。 第三に、BigMacはプロファイリング、シミュレーション、可視化ツールのスイートを提供します。これらのツールはトレーニングの反復処理をオペレーターレベルまで分解し、各タイムステップで各ランクが何を行っているかを正確に明らかにするとともに、アイドル期間を特定し、依存関係のボトルネックを強調表示します。 また、このシミュレーターを使用することで、チームは本格的なトレーニングに着手する前に、さまざまなPP構成やマイクロバッチの組み合わせをテストし、それらがバブルやスループットに与える影響を推定することができます。
BigMacの有効性は、2つの代表的なワークロードにおいて検証されています。MLLM-Understandingタスクにおいて、バックボーンとしてQwen3-30B-A3Bを使用し、1.3BのViTエンコーダを採用した場合、 BigMacは、計算効率に優れたベースラインであるOptimusと比較して1.08倍から1.1倍の高速化を達成し、メモリ効率に優れたベースラインであるMegatron-DistTrainと比較して1.6倍から1.9倍の高速化を実現しました。 重要な点として、GPU あたりのバッチサイズが増加してもメモリ使用量は安定しているのに対し、Optimus ではメモリ使用量がピーク時に急増し、最終的に大きなバッチサイズでメモリ不足(OOM)エラーが発生する。 MLLM-Generationタスクはより複雑で、20BのMMDiTジェネレータを伴うが、ここでは性能差がさらに拡大する。OptimusはOOMによりテストされたすべてのバッチサイズで失敗する一方、BigMacはジェネレータを逆方向に効率的に実行し、活性化値を迅速に解放することでこれを回避している。 Megatron-DistTrainと比較しても、BigMacは安定したメモリ使用量で1.5倍から1.9倍の高速化を実現しています。これは、ネストされたパイプラインの主な価値、すなわち、過度な活性化データの保持や著しいアイドル時間を生じさせることなく、エンコーダとジェネレータの両方の依存関係に対応できることを浮き彫りにしています。
BigMacは現在、Dotsのマルチモーダルモデル学習インフラの中核コンポーネントとなっており、Xiaohongshuの本番環境でも稼働しています。 付随する論文「BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training」は、インタラクティブなPP Profilerトレース例とともにarXivで公開されています。 マルチモーダル学習におけるメモリと速度のトレードオフに悩む研究者やエンジニアにとって、この実運用で実証済みのオープンソースプロジェクトは、時間と労力を大幅に節約する実用的な解決策を提供します。








 米国の株式市場が歴史的なマイルストーンに到達、AIと航空宇宙の巨人が1兆ドル規模のデビューに向けて準備を進める
エロン・マスク、サム・アルトマン、ダリオ・アモダイというテクノロジー業界の三巨頭が、それぞれの事業で初公開株式発行(IPO)に向けて進んでいる。スペースX、OpenAI、Anthropicという業界の巨人3社が1兆ドル規模の企業価値に近づき、上場準備を進める中、2026年は米国史上、新規株式発行が最も重要な年となる見込みだ。この歴史的な資金増強は世界の金融の注目を集めており、公的市場がこのような規模の資金を吸収する能力に対する重要なストレステストとなっている。これらの主要な資金調達が一斉に開始
 スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位

2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
10 ツール
xix.ai

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !












