


 Hogar
Xiaohongshu presenta BigMac: rompiendo el dilema entre memoria y velocidad en el entrenamiento multimodal
Los modelos de lenguaje grandes y multimodales se están convirtiendo en la piedra angular de la IA de próxima generación; sin embargo, su infraestructura de entrenamiento se ha visto obstaculizada durante mucho tiempo por una disyuntiva persistente: los sistemas optimizados para la velocidad suelen tener problemas con las limitaciones de memoria, mientras que aquellos que priorizan la eficiencia de la memoria tienden a ser lentos. El equipo de Dots Infra de Xiaohongshu identifica este cuello de botella como la frontera de Pareto del entrenamiento de tuberías multimodales y ahora lo ha superado. El 22 de julio, el equipo publicó en código abierto BigMac, un novedoso paradigma de entrenamiento paralelo en pipeline diseñado específicamente para escenarios multimodales nativos. El proyecto ya está disponible en GitHub, en el repositorio Dots-Infra.
A diferencia de los transformadores estándar, los modelos multimodales son intrínsecamente complejos. Un modelo de lenguaje grande multimodal (MLLM) típico consta de tres componentes distintos: codificadores modales que convierten imágenes y audio en representaciones, una estructura central de LLM para la inferencia y un generador que mapea las salidas del LLM de vuelta a las modalidades de destino, como imágenes o voz. Las importantes diferencias estructurales entre estos componentes plantean retos considerables a la hora de integrarlos en un único proceso de entrenamiento.
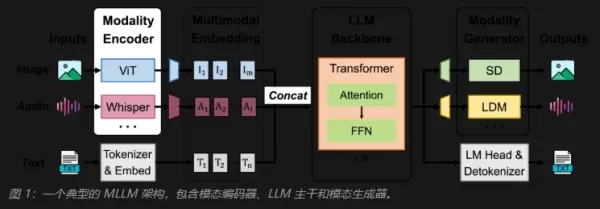
Las soluciones actuales del sector suelen dividirse en dos categorías. El primer enfoque prioriza la eficiencia computacional desacoplando los codificadores y los generadores del proceso del LLM, ejecutándolos por separado. Esto evita que las fluctuaciones en la duración de los módulos modales generen «burbujas» en el proceso del LLM, pero hace que la memoria de activación aumente proporcionalmente al número de microlot, lo que conlleva altos costes a gran escala. El segundo enfoque se centra en la eficiencia de la memoria al mantener todos los módulos dentro del mismo proceso, lo que acorta los ciclos de vida de las activaciones y reduce el uso de memoria. Sin embargo, si algún codificador o generador es lento, todo el proceso del LLM se atasca, lo que da lugar a «burbujas de cola». A medida que aumenta la escala del modelo, ambos diseños revelan cuellos de botella críticos.
BigMac aborda este reto con un principio sencillo pero fundamental: la canalización principal del LLM sigue siendo el foco principal. El entrenamiento de LLM a gran escala ya se basa en estrategias de programación maduras como 1F1B o 1F1B intercalado, que están profundamente integradas en las pilas de entrenamiento de nivel de producción. En lugar de sustituir estos métodos consolidados, BigMac utiliza la programación del LLM como línea temporal subyacente, insertando estratégicamente los cálculos del codificador y del generador cuando las entradas están listas y sin alterar el orden de ejecución del LLM. El equipo se refiere a esta arquitectura como una «cadena de procesamiento anidada cuasi-segura frente a dependencias».
Este diseño ofrece dos ventajas clave. En primer lugar, las fluctuaciones en la duración del codificador y del generador ya no se propagan a través del proceso del LLM, lo que permite que este mantenga su ritmo óptimo. En segundo lugar, los requisitos de memoria para las activaciones modales se reducen a O(1) a nivel algorítmico. Los codificadores ya no necesitan retener las activaciones de todos los microlotes hasta que concluya la canalización, y los generadores evitan prolongar las colas de activación largas. En esencia, BigMac no sacrifica memoria a cambio de picos de rendimiento; en su lugar, reestructura la lógica de programación para que estos dos objetivos sean compatibles, en lugar de mutuamente excluyentes.
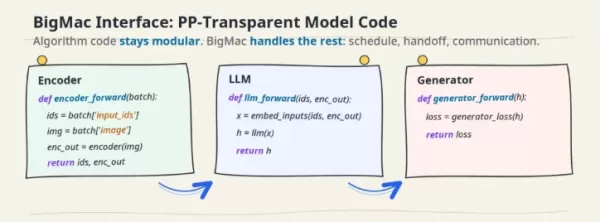
Salvar la brecha entre el diseño de la programación y la ejecución real implica importantes obstáculos de ingeniería, entre los que se incluyen la integración de sistemas, la definición de interfaces y la depuración del rendimiento. BigMac está diseñado para abordar estos retos específicos proporcionando tres capacidades fundamentales. En primer lugar, hace que la programación global sea transparente: el programador genera una tabla de operadores exhaustiva que abarca todos los rangos del pipeline, los microlot y los tipos de módulos en tiempo de ejecución. A continuación, el ejecutor distribuye estos datos en secuencias locales para cada rango, integrándose a la perfección con backends de LLM como Megatron Core, entornos de ejecución modales y capas de comunicación. Esta visibilidad facilita la comprobación y la optimización del backend.
En segundo lugar, BigMac ofrece una interfaz de paralelismo de canalización que permanece invisible para los ingenieros de algoritmos. Los usuarios solo tienen que definir lo que cada módulo produce y consume; el sistema se encarga internamente de la división de etapas, la activación y el traspaso de gradientes, así como de la comunicación entre dispositivos. Esto permite que los experimentos multimodales verificados en una única GPU se escalen de forma natural al paralelismo de canalización. En tercer lugar, proporciona un conjunto de herramientas de perfilado, simulación y visualización. Estas herramientas desglosan las iteraciones de entrenamiento hasta el nivel de operador, revelando exactamente qué hace cada rango en cada paso temporal, identificando los periodos de inactividad y resaltando los cuellos de botella en las dependencias. El simulador también permite a los equipos probar diversas configuraciones de PP y combinaciones de microlotes antes de lanzarse al entrenamiento a gran escala, estimando su impacto en las «burbujas» y el rendimiento.
La eficacia de BigMac se ha validado en dos cargas de trabajo representativas. En tareas de comprensión de MLLM, utilizando Qwen3-30B-A3B como estructura base y un codificador ViT de 1.3B, BigMac alcanza una aceleración de entre 1,08 y 1,1 veces en comparación con Optimus —la línea de base eficiente desde el punto de vista computacional— y una aceleración de entre 1,6 y 1,9 veces respecto a Megatron-DistTrain —la línea de base eficiente en memoria—. Es fundamental destacar que el uso de memoria se mantiene estable a medida que aumenta el tamaño del lote por GPU, mientras que Optimus experimenta picos de consumo de memoria que, finalmente, provocan errores de «Out-of-Memory» (OOM) en lotes más grandes. Las tareas de generación MLLM son más complejas, ya que implican un generador MMDiT de 20 mil millones, donde la diferencia de rendimiento se amplía aún más: Optimus falla en todos los tamaños de lote probados debido a errores de «sin memoria», mientras que BigMac evita esto ejecutando de forma eficiente el generador hacia atrás y liberando rápidamente las activaciones. En comparación con Megatron-DistTrain, BigMac sigue ofreciendo una aceleración de entre 1,5 y 1,9 veces con un uso estable de la memoria. Esto pone de relieve el valor principal de los flujos de trabajo anidados: atender las dependencias tanto del codificador como del generador sin una retención excesiva de activaciones ni un tiempo de inactividad significativo.
BigMac es ahora un componente fundamental de la infraestructura de entrenamiento de modelos multimodales de Dots y opera en el entorno de producción de Xiaohongshu. El artículo que lo acompaña, «BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training», está disponible en arXiv, junto con ejemplos interactivos de trazas de PP Profiler. Para los investigadores e ingenieros que se enfrentan al dilema entre memoria y velocidad en el entrenamiento multimodal, este proyecto de código abierto validado en producción ofrece una solución práctica que ahorra una cantidad significativa de tiempo y esfuerzo.
Artículo relacionado
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t
Recomendaciones de temas especiales relacionados
escribiendo
 Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
 8 herramientas
 xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (10)
0/500
![JackMartinez]()
¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
![AlbertThomas]()
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
![BillyAnderson]()
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
![WillieAnderson]()
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
![BillyYoung]()
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
![JoseAdams]()
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !
Los modelos de lenguaje grandes y multimodales se están convirtiendo en la piedra angular de la IA de próxima generación; sin embargo, su infraestructura de entrenamiento se ha visto obstaculizada durante mucho tiempo por una disyuntiva persistente: los sistemas optimizados para la velocidad suelen tener problemas con las limitaciones de memoria, mientras que aquellos que priorizan la eficiencia de la memoria tienden a ser lentos. El equipo de Dots Infra de Xiaohongshu identifica este cuello de botella como la frontera de Pareto del entrenamiento de tuberías multimodales y ahora lo ha superado. El 22 de julio, el equipo publicó en código abierto BigMac, un novedoso paradigma de entrenamiento paralelo en pipeline diseñado específicamente para escenarios multimodales nativos. El proyecto ya está disponible en GitHub, en el repositorio Dots-Infra.
A diferencia de los transformadores estándar, los modelos multimodales son intrínsecamente complejos. Un modelo de lenguaje grande multimodal (MLLM) típico consta de tres componentes distintos: codificadores modales que convierten imágenes y audio en representaciones, una estructura central de LLM para la inferencia y un generador que mapea las salidas del LLM de vuelta a las modalidades de destino, como imágenes o voz. Las importantes diferencias estructurales entre estos componentes plantean retos considerables a la hora de integrarlos en un único proceso de entrenamiento.
Las soluciones actuales del sector suelen dividirse en dos categorías. El primer enfoque prioriza la eficiencia computacional desacoplando los codificadores y los generadores del proceso del LLM, ejecutándolos por separado. Esto evita que las fluctuaciones en la duración de los módulos modales generen «burbujas» en el proceso del LLM, pero hace que la memoria de activación aumente proporcionalmente al número de microlot, lo que conlleva altos costes a gran escala. El segundo enfoque se centra en la eficiencia de la memoria al mantener todos los módulos dentro del mismo proceso, lo que acorta los ciclos de vida de las activaciones y reduce el uso de memoria. Sin embargo, si algún codificador o generador es lento, todo el proceso del LLM se atasca, lo que da lugar a «burbujas de cola». A medida que aumenta la escala del modelo, ambos diseños revelan cuellos de botella críticos.
BigMac aborda este reto con un principio sencillo pero fundamental: la canalización principal del LLM sigue siendo el foco principal. El entrenamiento de LLM a gran escala ya se basa en estrategias de programación maduras como 1F1B o 1F1B intercalado, que están profundamente integradas en las pilas de entrenamiento de nivel de producción. En lugar de sustituir estos métodos consolidados, BigMac utiliza la programación del LLM como línea temporal subyacente, insertando estratégicamente los cálculos del codificador y del generador cuando las entradas están listas y sin alterar el orden de ejecución del LLM. El equipo se refiere a esta arquitectura como una «cadena de procesamiento anidada cuasi-segura frente a dependencias».
Este diseño ofrece dos ventajas clave. En primer lugar, las fluctuaciones en la duración del codificador y del generador ya no se propagan a través del proceso del LLM, lo que permite que este mantenga su ritmo óptimo. En segundo lugar, los requisitos de memoria para las activaciones modales se reducen a O(1) a nivel algorítmico. Los codificadores ya no necesitan retener las activaciones de todos los microlotes hasta que concluya la canalización, y los generadores evitan prolongar las colas de activación largas. En esencia, BigMac no sacrifica memoria a cambio de picos de rendimiento; en su lugar, reestructura la lógica de programación para que estos dos objetivos sean compatibles, en lugar de mutuamente excluyentes.
Salvar la brecha entre el diseño de la programación y la ejecución real implica importantes obstáculos de ingeniería, entre los que se incluyen la integración de sistemas, la definición de interfaces y la depuración del rendimiento. BigMac está diseñado para abordar estos retos específicos proporcionando tres capacidades fundamentales. En primer lugar, hace que la programación global sea transparente: el programador genera una tabla de operadores exhaustiva que abarca todos los rangos del pipeline, los microlot y los tipos de módulos en tiempo de ejecución. A continuación, el ejecutor distribuye estos datos en secuencias locales para cada rango, integrándose a la perfección con backends de LLM como Megatron Core, entornos de ejecución modales y capas de comunicación. Esta visibilidad facilita la comprobación y la optimización del backend.
En segundo lugar, BigMac ofrece una interfaz de paralelismo de canalización que permanece invisible para los ingenieros de algoritmos. Los usuarios solo tienen que definir lo que cada módulo produce y consume; el sistema se encarga internamente de la división de etapas, la activación y el traspaso de gradientes, así como de la comunicación entre dispositivos. Esto permite que los experimentos multimodales verificados en una única GPU se escalen de forma natural al paralelismo de canalización. En tercer lugar, proporciona un conjunto de herramientas de perfilado, simulación y visualización. Estas herramientas desglosan las iteraciones de entrenamiento hasta el nivel de operador, revelando exactamente qué hace cada rango en cada paso temporal, identificando los periodos de inactividad y resaltando los cuellos de botella en las dependencias. El simulador también permite a los equipos probar diversas configuraciones de PP y combinaciones de microlotes antes de lanzarse al entrenamiento a gran escala, estimando su impacto en las «burbujas» y el rendimiento.
La eficacia de BigMac se ha validado en dos cargas de trabajo representativas. En tareas de comprensión de MLLM, utilizando Qwen3-30B-A3B como estructura base y un codificador ViT de 1.3B, BigMac alcanza una aceleración de entre 1,08 y 1,1 veces en comparación con Optimus —la línea de base eficiente desde el punto de vista computacional— y una aceleración de entre 1,6 y 1,9 veces respecto a Megatron-DistTrain —la línea de base eficiente en memoria—. Es fundamental destacar que el uso de memoria se mantiene estable a medida que aumenta el tamaño del lote por GPU, mientras que Optimus experimenta picos de consumo de memoria que, finalmente, provocan errores de «Out-of-Memory» (OOM) en lotes más grandes. Las tareas de generación MLLM son más complejas, ya que implican un generador MMDiT de 20 mil millones, donde la diferencia de rendimiento se amplía aún más: Optimus falla en todos los tamaños de lote probados debido a errores de «sin memoria», mientras que BigMac evita esto ejecutando de forma eficiente el generador hacia atrás y liberando rápidamente las activaciones. En comparación con Megatron-DistTrain, BigMac sigue ofreciendo una aceleración de entre 1,5 y 1,9 veces con un uso estable de la memoria. Esto pone de relieve el valor principal de los flujos de trabajo anidados: atender las dependencias tanto del codificador como del generador sin una retención excesiva de activaciones ni un tiempo de inactividad significativo.
BigMac es ahora un componente fundamental de la infraestructura de entrenamiento de modelos multimodales de Dots y opera en el entorno de producción de Xiaohongshu. El artículo que lo acompaña, «BigMac: Breaking the Pareto Frontier of Compute and Memory in Multimodal LLM Training», está disponible en arXiv, junto con ejemplos interactivos de trazas de PP Profiler. Para los investigadores e ingenieros que se enfrentan al dilema entre memoria y velocidad en el entrenamiento multimodal, este proyecto de código abierto validado en producción ofrece una solución práctica que ahorra una cantidad significativa de tiempo y esfuerzo.








 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
 Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

¿BigMac? Suena a que viene con mucho contenido. 😂 Resolver la tensión entre memoria y velocidad es clave en IA actual. Si logran mantener la precisión sin consumir tantos recursos, será un hito importante. Ojalá los benchmarks sean sólidos.
O nome BigMac é hilário, mas a proposta é séria! Resolver o trade-off entre memória e velocidade é crucial para modelos multimodais. Se funcionar como prometem, facilita muito a vida de quem treina modelos grandes. Aguardando os resultados práticos!
Interessanter Ansatz! Die Balance zwischen Speicherbedarf und Trainingsgeschwindigkeit ist oft der Engpass. Wenn BigMac hier wirklich einen Unterschied macht, wäre das ein echter Fortschritt für die Community. Mal sehen, wie sich die Zahlen im Live-Betrieb verhalten.
빅맥이라는 이름이 참 신기하네요. 다중 모달 학습에서 메모리와 속도의 균형을 맞추는 건 정말 어려운 과제인데, Xiaohongshu가 해냈다면 큰 의미가 있을 것 같습니다. 성능 테스트 결과가 기대됩니다!
Наконец-то кто-то решает проблему памяти в мультимодальных моделях. BigMac звучит как мощное решение. Надеюсь, это не просто маркетинг, а реальный прорыв в инфраструктуре обучения. Ждем тестов! 🚀
C'est une avancée intéressante. Le compromis entre vitesse et mémoire est souvent un frein dans notre domaine. Si BigMac parvient à l'optimiser sans perdre en précision, ça pourrait démocratiser l'entraînement multimodal. À suivre de près !












