

 Lar
O Ant Group torna o LingBot-Vision de código aberto, proporcionando aos robôs percepção espacial
No campo da inteligência incorporada, permitir que os robôs percebam o espaço físico com precisão semelhante à humana continua sendo um desafio fundamental. A Robbyant, subsidiária do Ant Group especializada em IA incorporada, tornou oficialmente de código aberto a família de modelos LingBot-Vision. Esse conjunto de Transformers de visão auto-supervisionados alcança resultados excepcionais na percepção espacial densa por meio de uma estratégia inovadora de “modelagem de limites”, superando modelos maiores em vários benchmarks, apesar de possuir menos parâmetros.
A maioria dos modelos visuais de base atuais prioriza o “reconhecimento de objetos”, concentrando-se em identificar o que está em uma imagem, enquanto muitas vezes ignora pistas críticas de interação física, como limites, contornos e profundidade dos objetos. O LingBot-Vision inverte essa abordagem ao tratar os “limites” como sinais primários de pré-treinamento. Ao utilizar a modelagem de limites por máscara, o modelo identifica as regiões mais densas em informações em uma imagem e concentra seu treinamento nelas. Esse método permite que o modelo adquira compreensão semântica e, ao mesmo tempo, desenvolva uma percepção espacial geométrica robusta.
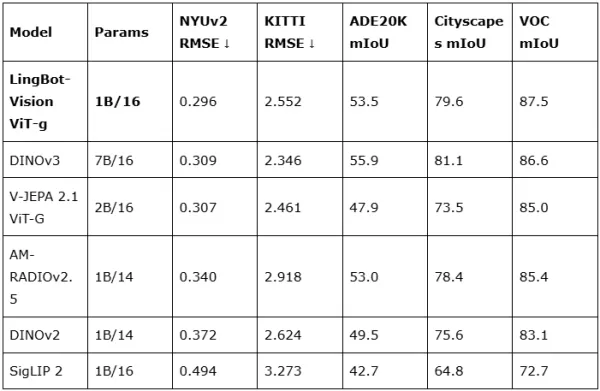
Em relação ao desempenho, o modelo principal do LingBot-Vision, o ViT-g/16, contém apenas 1,1 bilhão de parâmetros, mas alcança resultados de ponta em tarefas de estimativa de profundidade, incluindo o NYU-Depth v2. Ele supera o DINOv3, que possui 7 bilhões de parâmetros, embora utilize um conjunto de dados de treinamento com cerca de um terço do tamanho. Para cenários de implantação com recursos limitados, a série oferece versões destiladas que variam de 3 bilhões de parâmetros até tamanhos menores, garantindo desempenho de ponta em previsão densa em diversas configurações de hardware.
Para demonstrar o valor prático da tecnologia, a equipe de desenvolvimento também atualizou o sistema de preenchimento de profundidade para o LingBot-Depth 2.0. Testes indicam melhorias significativas na precisão ao lidar com objetos transparentes, um tradicional ponto cego da percepção. À medida que o volume de dados aumenta, o desempenho do LingBot-Vision continua a escalar sem a saturação típica dos modelos tradicionais, validando ainda mais o potencial de sua arquitetura de percepção espacial centrada em limites em ambientes complexos do mundo real.
O LingBot-Vision agora está totalmente disponível como código aberto no Hugging Face sob a licença Apache-2.0, incluindo pesos e código de inferência para quatro tamanhos de modelo, do maior ao menor. Essa tecnologia permite que os desenvolvedores equipem robôs com capacidades de percepção física mais sensíveis a custos computacionais mais baixos, abrindo caminho para um futuro mais preciso e interativo na inteligência incorporada.
Artigo relacionado
 GPT 5.5 lidera a corrida de segurança de IA, enquanto DeepSeek se destaca em custo-efetividade
Kasra Rahjerdi, um pesquisador de segurança, publicou recentemente um relatório significativo detalhando testes práticos sobre o raciocínio de segurança de grandes modelos de linguagem. Ele conseguiu isso construindo um aplicativo de revisão de livro
A IA da SpaceX poderia ultrapassar a Anthropic em menos de meio ano, afirma Musk
O CEO da SpaceXAI, Elon Musk, prevê o domínio da IA em até seis meses, aproveitando o hardware de computação para diminuir a diferença em relação aos concorrentes.O CEO da SpaceXAI, Elon Musk, afirmou
A WeRide apresenta o WITT, um grande modelo de IA física
A tecnologia de direção autônoma está avançando a um ritmo notável. Em 17 de julho, a WeRide, empresa líder no setor de direção autônoma, revelou seu modelo cognitivo de IA baseado em fatos físicos, o
Recomendações de tópicos especiais relacionados
SEO
 Ferramentas de Rastreamento de Classificação por IA para o Google, Visões Gerais por IA e Visibilidade em Motores de Resposta
As melhores ferramentas de classificação de IA para visibilidade no Google, Visões Gerais de IA e Motores de Resposta mais bem avaliadas de 2026 estão aqui no XIX.AI. Esta lista selecionada apresenta ferramentas poderosas que mudam o jogo, passando por rigorosos testes do mundo real para fornecer dados de classificação precisos. Obtenha uma comparação gratuita entre versão paga e gratuita, veja os principais resultados e descubra opções imperdíveis para aumentar a visibilidade do seu conteúdo nos mecanismos de busca. Explore agora para encontrar a ferramenta perfeita para suas necessidades.
 10 ferramentas
 xix.ai
Produtividade
Melhores Organizadores de Segundo Cérebro Baseados em IA para Notas e Tarefas
2026 Últimas Melhores Organizadores de Cérebro Artificial de Segunda Geração Mais Bem Avaliados para Notas e Tarefas! A XIX.AI selecionou uma coleção extremamente poderosa e transformadora, com classificações atualizadas semanalmente, comparação entre versões gratuitas e pagas, e testes do mundo real para ajudá-lo a encontrar a ferramenta perfeita que aumenta drasticamente a produtividade. Explore agora para desbloquear sua vantagem com IA!
11 ferramentas
xix.ai
Incitar
Plataformas de Teste de Prompts de IA para Fluxos de Trabalho do ChatGPT e Claude
2026 Últimas Melhores Plataformas de Teste de Prompts de IA Mais Bem Avaliadas para Fluxos de Trabalho do ChatGPT e Claude! A XIX.AI seleciona uma poderosa coleção transformadora, com classificações atualizadas semanalmente, comparação entre gratuito e pago, testes do mundo real e análises detalhadas de recursos para ajudá-lo a identificar as ferramentas essenciais que aumentam a produtividade e entregam resultados impecáveis. Explore agora para descobrir sua solução perfeita e desbloqueie sua vantagem em IA.
9 ferramentas
xix.ai
Marketing
Ferramentas de IA para redação de textos de páginas de destino em testes A/B de SaaS, páginas de preços e conversão de demonstrações
As melhores e mais recentes ferramentas de 2026 para criação de textos de páginas de destino com IA — para testes A/B de SaaS, páginas de preços e conversão de demonstrações — estão aqui no XIX.AI. Esta lista selecionada das ferramentas mais bem avaliadas oferece soluções poderosas e revolucionárias para elevar a qualidade do conteúdo, melhorar a eficiência na redação e aumentar a produtividade geral. Realizamos testes em condições reais e oferecemos uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Opções imperdíveis ajudam você a superar os gargalos na criação de conteúdo. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo sua vantagem com a IA!
8 ferramentas
xix.ai
Financiar
Ferramentas de Previsão Orçamentária com IA do Excel para Planejamento de Fluxo de Caixa e Controle de Despesas
As melhores ferramentas de IA do Excel mais recentes de 2026 para planejamento de fluxo de caixa e controle de despesas estão aqui na lista curada e mais bem avaliada da XIX.AI. Essas poderosas soluções transformadoras ajudam você a aumentar significativamente a produtividade por meio de testes do mundo real e classificações rigorosas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades. Explore agora para desbloquear sua vantagem com IA na gestão financeira.
9 ferramentas
xix.ai
Incitar
Ferramentas de Gerenciamento de Prompts de IA para Equipes
As melhores ferramentas de gerenciamento de prompts de IA para equipes, mais recentes e com as melhores avaliações de 2026, são selecionadas pela XIX.AI aqui. Este guia atualizado semanalmente apresenta soluções poderosas que mudam o jogo e aumentam significativamente a produtividade da equipe por meio de testes do mundo real e classificações detalhadas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita. Explore agora para desbloquear sua vantagem com IA.
9 ferramentas
xix.ai

 Comentários (0)
No campo da inteligência incorporada, permitir que os robôs percebam o espaço físico com precisão semelhante à humana continua sendo um desafio fundamental. A Robbyant, subsidiária do Ant Group especializada em IA incorporada, tornou oficialmente de código aberto a família de modelos LingBot-Vision. Esse conjunto de Transformers de visão auto-supervisionados alcança resultados excepcionais na percepção espacial densa por meio de uma estratégia inovadora de “modelagem de limites”, superando modelos maiores em vários benchmarks, apesar de possuir menos parâmetros.
A maioria dos modelos visuais de base atuais prioriza o “reconhecimento de objetos”, concentrando-se em identificar o que está em uma imagem, enquanto muitas vezes ignora pistas críticas de interação física, como limites, contornos e profundidade dos objetos. O LingBot-Vision inverte essa abordagem ao tratar os “limites” como sinais primários de pré-treinamento. Ao utilizar a modelagem de limites por máscara, o modelo identifica as regiões mais densas em informações em uma imagem e concentra seu treinamento nelas. Esse método permite que o modelo adquira compreensão semântica e, ao mesmo tempo, desenvolva uma percepção espacial geométrica robusta.
Em relação ao desempenho, o modelo principal do LingBot-Vision, o ViT-g/16, contém apenas 1,1 bilhão de parâmetros, mas alcança resultados de ponta em tarefas de estimativa de profundidade, incluindo o NYU-Depth v2. Ele supera o DINOv3, que possui 7 bilhões de parâmetros, embora utilize um conjunto de dados de treinamento com cerca de um terço do tamanho. Para cenários de implantação com recursos limitados, a série oferece versões destiladas que variam de 3 bilhões de parâmetros até tamanhos menores, garantindo desempenho de ponta em previsão densa em diversas configurações de hardware.
Para demonstrar o valor prático da tecnologia, a equipe de desenvolvimento também atualizou o sistema de preenchimento de profundidade para o LingBot-Depth 2.0. Testes indicam melhorias significativas na precisão ao lidar com objetos transparentes, um tradicional ponto cego da percepção. À medida que o volume de dados aumenta, o desempenho do LingBot-Vision continua a escalar sem a saturação típica dos modelos tradicionais, validando ainda mais o potencial de sua arquitetura de percepção espacial centrada em limites em ambientes complexos do mundo real.
O LingBot-Vision agora está totalmente disponível como código aberto no Hugging Face sob a licença Apache-2.0, incluindo pesos e código de inferência para quatro tamanhos de modelo, do maior ao menor. Essa tecnologia permite que os desenvolvedores equipem robôs com capacidades de percepção física mais sensíveis a custos computacionais mais baixos, abrindo caminho para um futuro mais preciso e interativo na inteligência incorporada.


 GPT 5.5 lidera a corrida de segurança de IA, enquanto DeepSeek se destaca em custo-efetividade
Kasra Rahjerdi, um pesquisador de segurança, publicou recentemente um relatório significativo detalhando testes práticos sobre o raciocínio de segurança de grandes modelos de linguagem. Ele conseguiu isso construindo um aplicativo de revisão de livro
 A IA da SpaceX poderia ultrapassar a Anthropic em menos de meio ano, afirma Musk
O CEO da SpaceXAI, Elon Musk, prevê o domínio da IA em até seis meses, aproveitando o hardware de computação para diminuir a diferença em relação aos concorrentes.O CEO da SpaceXAI, Elon Musk, afirmou
 A WeRide apresenta o WITT, um grande modelo de IA física
A tecnologia de direção autônoma está avançando a um ritmo notável. Em 17 de julho, a WeRide, empresa líder no setor de direção autônoma, revelou seu modelo cognitivo de IA baseado em fatos físicos, o
As melhores ferramentas de classificação de IA para visibilidade no Google, Visões Gerais de IA e Motores de Resposta mais bem avaliadas de 2026 estão aqui no XIX.AI. Esta lista selecionada apresenta ferramentas poderosas que mudam o jogo, passando por rigorosos testes do mundo real para fornecer dados de classificação precisos. Obtenha uma comparação gratuita entre versão paga e gratuita, veja os principais resultados e descubra opções imperdíveis para aumentar a visibilidade do seu conteúdo nos mecanismos de busca. Explore agora para encontrar a ferramenta perfeita para suas necessidades.
10 ferramentas
xix.ai
2026 Últimas Melhores Organizadores de Cérebro Artificial de Segunda Geração Mais Bem Avaliados para Notas e Tarefas! A XIX.AI selecionou uma coleção extremamente poderosa e transformadora, com classificações atualizadas semanalmente, comparação entre versões gratuitas e pagas, e testes do mundo real para ajudá-lo a encontrar a ferramenta perfeita que aumenta drasticamente a produtividade. Explore agora para desbloquear sua vantagem com IA!
11 ferramentas
xix.ai

2026 Últimas Melhores Plataformas de Teste de Prompts de IA Mais Bem Avaliadas para Fluxos de Trabalho do ChatGPT e Claude! A XIX.AI seleciona uma poderosa coleção transformadora, com classificações atualizadas semanalmente, comparação entre gratuito e pago, testes do mundo real e análises detalhadas de recursos para ajudá-lo a identificar as ferramentas essenciais que aumentam a produtividade e entregam resultados impecáveis. Explore agora para descobrir sua solução perfeita e desbloqueie sua vantagem em IA.
9 ferramentas
xix.ai

As melhores e mais recentes ferramentas de 2026 para criação de textos de páginas de destino com IA — para testes A/B de SaaS, páginas de preços e conversão de demonstrações — estão aqui no XIX.AI. Esta lista selecionada das ferramentas mais bem avaliadas oferece soluções poderosas e revolucionárias para elevar a qualidade do conteúdo, melhorar a eficiência na redação e aumentar a produtividade geral. Realizamos testes em condições reais e oferecemos uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Opções imperdíveis ajudam você a superar os gargalos na criação de conteúdo. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo sua vantagem com a IA!
8 ferramentas
xix.ai

As melhores ferramentas de IA do Excel mais recentes de 2026 para planejamento de fluxo de caixa e controle de despesas estão aqui na lista curada e mais bem avaliada da XIX.AI. Essas poderosas soluções transformadoras ajudam você a aumentar significativamente a produtividade por meio de testes do mundo real e classificações rigorosas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades. Explore agora para desbloquear sua vantagem com IA na gestão financeira.
9 ferramentas
xix.ai

As melhores ferramentas de gerenciamento de prompts de IA para equipes, mais recentes e com as melhores avaliações de 2026, são selecionadas pela XIX.AI aqui. Este guia atualizado semanalmente apresenta soluções poderosas que mudam o jogo e aumentam significativamente a produtividade da equipe por meio de testes do mundo real e classificações detalhadas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita. Explore agora para desbloquear sua vantagem com IA.
9 ferramentas
xix.ai












