

 Hogar
Ant Group publica el código fuente de LingBot-Vision, lo que dota a los robots de percepción espacial
En el ámbito de la inteligencia incorporada, permitir que los robots perciban el espacio físico con una precisión similar a la humana sigue siendo un reto fundamental. Robbyant, una filial de Ant Group especializada en IA incorporada, ha publicado oficialmente en código abierto la familia de modelos LingBot-Vision. Este conjunto de «Transformers» de visión auto-supervisados logra resultados excepcionales en la percepción espacial densa mediante una innovadora estrategia de «modelado de límites», superando a modelos más grandes en múltiples pruebas de rendimiento a pesar de tener menos parámetros.
La mayoría de los modelos visuales básicos actuales dan prioridad al «reconocimiento de objetos», centrándose en identificar lo que hay en una imagen, mientras que a menudo pasan por alto señales críticas de interacción física como los límites de los objetos, los contornos y la profundidad. LingBot-Vision invierte este enfoque al tratar los «límites» como señales principales de preentrenamiento. Al aprovechar el modelado de límites mediante máscaras, el modelo identifica las regiones con mayor densidad de información en una imagen y centra su entrenamiento en ellas. Este método permite al modelo adquirir comprensión semántica al tiempo que desarrolla una percepción espacial geométrica robusta.
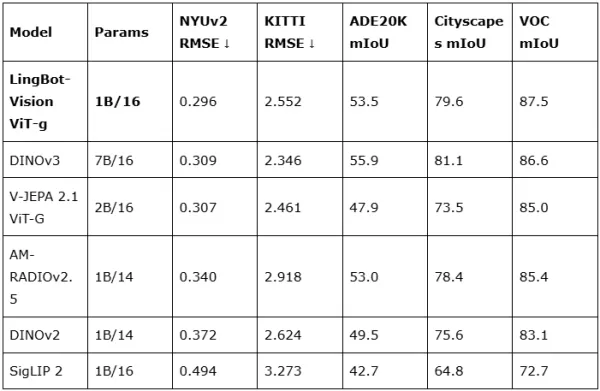
En cuanto al rendimiento, el modelo insignia de LingBot-Vision, ViT-g/16, contiene solo 1.1 mil millones de parámetros y, sin embargo, alcanza resultados de vanguardia en tareas de estimación de profundidad, incluida NYU-Depth v2. Supera a DINOv3, que cuenta con 7.000 millones de parámetros, utilizando un conjunto de datos de entrenamiento de aproximadamente un tercio de su tamaño. Para escenarios de implementación con recursos limitados, la serie ofrece versiones destiladas que van desde los 3.000 millones de parámetros hasta tamaños más reducidos, lo que garantiza un rendimiento de predicción densa de primer nivel en diversas configuraciones de hardware.
Para demostrar el valor práctico de la tecnología, el equipo de desarrollo también ha actualizado el sistema de completado de profundidad a LingBot-Depth 2.0. Las pruebas indican mejoras significativas en la precisión al tratar objetos transparentes, un punto ciego tradicional de la percepción. A medida que aumenta el volumen de datos, el rendimiento de LingBot-Vision sigue escalando sin la saturación típica de los modelos tradicionales, lo que valida aún más el potencial de su arquitectura de percepción espacial centrada en los límites en entornos complejos del mundo real.
LingBot-Vision es ahora de código abierto en su totalidad en Hugging Face bajo la licencia Apache-2.0, incluyendo los pesos y el código de inferencia para cuatro tamaños de modelo, desde el más grande hasta el más pequeño. Esta tecnología permite a los desarrolladores dotar a los robots de capacidades de percepción física más sensibles con menores costes computacionales, allanando el camino hacia un futuro más preciso e interactivo en el ámbito de la inteligencia incorporada.
Artículo relacionado
 GPT 5.5 lidera la carrera de seguridad de IA, DeepSeek encabeza la eficiencia en costos
Kasra Rahjerdi, un investigador de seguridad, publicó recientemente un informe significativo que detalla pruebas prácticas sobre el razonamiento de seguridad de los principales modelos de lenguaje grandes. Logró esto mediante la construcción de una a
La IA de SpaceX podría superar a Anthropic en menos de medio año, según Musk
El director ejecutivo de SpaceXAI, Elon Musk, prevé que la IA alcance el dominio en un plazo de seis meses, aprovechando el hardware informático para reducir la distancia con la competencia.El directo
WeRide presenta WITT, un modelo grande de IA física
La tecnología de conducción autónoma avanza a un ritmo extraordinario. El 17 de julio, WeRide, una empresa líder en conducción autónoma, presentó su modelo cognitivo propio de IA física, WeRide WITT.
Recomendaciones de temas especiales relacionados
SEO
 Herramientas de seguimiento de clasificación de IA para Google, Resúmenes de IA y visibilidad en motores de respuesta
2026 Últimas mejores herramientas de seguimiento de clasificación con IA mejor valoradas para Google, Resúmenes de IA y visibilidad en motores de respuesta están aquí en XIX.AI. Esta lista seleccionada incluye potentes herramientas que cambian las reglas del juego, sometidas a rigurosas pruebas en el mundo real para ofrecer datos de clasificación precisos. Obtén una comparación gratuita entre versiones gratuitas y de pago, observa a los principales competidores y descubre opciones imprescindibles para aumentar la visibilidad de tu contenido en los motores de búsqueda. Explora ahora para encontrar la herramienta perfecta para tus necesidades.
 10 herramientas
 xix.ai
Productividad
Mejores organizadores de segunda mente con IA para notas y tareas
2026 Últimas Mejores Organizadores de IA de Segunda Mente Mejor Valorados para Notas y Tareas. XIX.AI ha curado una colección extremadamente poderosa y transformadora, con clasificaciones actualizadas semanalmente, comparaciones entre versiones gratuitas y de pago, y pruebas en el mundo real para ayudarte a encontrar la herramienta perfecta que aumente drásticamente tu productividad. Explora ahora para desbloquear tu ventaja con IA.
11 herramientas
xix.ai
Inmediato
Plataformas de prueba de prompts de IA para flujos de trabajo de ChatGPT y Claude
¡Las mejores plataformas de prueba de prompts de IA más recientes y mejor valoradas de 2026 para flujos de trabajo de ChatGPT y Claude! XIX.AI selecciona una poderosa colección revolucionaria, con clasificaciones actualizadas semanalmente, comparaciones entre versiones gratuitas y de pago, pruebas en el mundo real y desgloses detallados de características para ayudarte a identificar las herramientas imprescindibles que aumentan la productividad y ofrecen resultados impecables. Explora ahora para descubrir tu solución perfecta y desbloquear tu ventaja con IA.
9 herramientas
xix.ai
Marketing
Herramientas de redacción para páginas de aterrizaje de IA para pruebas A/B de SaaS, páginas de precios y conversión de demostraciones
2026 Últimas Mejores Herramientas de Redacción para Páginas de Aterrizaje de IA para Pruebas A/B de SaaS, Páginas de Precios y Conversión de Demostraciones están aquí en XIX.AI. Esta lista curada de herramientas mejor valoradas ofrece soluciones poderosas que cambian las reglas del juego para mejorar la calidad del contenido, aumentar la eficiencia de redacción y optimizar la productividad general. Realizamos pruebas en el mundo real y proporcionamos una comparación gratuita frente a pagada junto con clasificaciones actualizadas semanalmente. Las opciones obligatorias de probar te ayudan a superar los cuellos de botella de creación. Explora ahora para descubrir tu herramienta perfecta y desbloquear tu ventaja con IA.
8 herramientas
xix.ai
Finanzas
Herramientas de Excel para la previsión presupuestaria con IA, orientadas a la planificación del flujo de caja y el control de gastos
Las mejores herramientas de IA para Excel de 2026 para la planificación del flujo de caja y el control de gastos están aquí en la lista curada y mejor valorada de XIX.AI. Estas poderosas soluciones transformadoras ayudan a aumentar significativamente la productividad mediante pruebas en el mundo real y clasificaciones rigurosas. Obtén una comparación gratuita entre versiones gratuitas y de pago para encontrar la opción perfecta para tus necesidades. Explora ahora para desbloquear tu ventaja con IA en la gestión financiera.
9 herramientas
xix.ai
Inmediato
Herramientas de gestión de prompts de IA para equipos
2026 Últimas Mejores Herramientas de Gestión de Prompts de IA Mejor Valoradas para Equipos están seleccionadas por XIX.AI aquí. Esta guía actualizada semanalmente presenta soluciones poderosas que cambian las reglas del juego y aumentan significativamente la productividad del equipo mediante pruebas en el mundo real y clasificaciones detalladas. Obtén una comparación gratuita entre versiones gratuitas y de pago para ayudarte a elegir la herramienta perfecta. Explora ahora para desbloquear tu ventaja con IA.
9 herramientas
xix.ai

 comentario (0)
0/500
En el ámbito de la inteligencia incorporada, permitir que los robots perciban el espacio físico con una precisión similar a la humana sigue siendo un reto fundamental. Robbyant, una filial de Ant Group especializada en IA incorporada, ha publicado oficialmente en código abierto la familia de modelos LingBot-Vision. Este conjunto de «Transformers» de visión auto-supervisados logra resultados excepcionales en la percepción espacial densa mediante una innovadora estrategia de «modelado de límites», superando a modelos más grandes en múltiples pruebas de rendimiento a pesar de tener menos parámetros.
La mayoría de los modelos visuales básicos actuales dan prioridad al «reconocimiento de objetos», centrándose en identificar lo que hay en una imagen, mientras que a menudo pasan por alto señales críticas de interacción física como los límites de los objetos, los contornos y la profundidad. LingBot-Vision invierte este enfoque al tratar los «límites» como señales principales de preentrenamiento. Al aprovechar el modelado de límites mediante máscaras, el modelo identifica las regiones con mayor densidad de información en una imagen y centra su entrenamiento en ellas. Este método permite al modelo adquirir comprensión semántica al tiempo que desarrolla una percepción espacial geométrica robusta.
En cuanto al rendimiento, el modelo insignia de LingBot-Vision, ViT-g/16, contiene solo 1.1 mil millones de parámetros y, sin embargo, alcanza resultados de vanguardia en tareas de estimación de profundidad, incluida NYU-Depth v2. Supera a DINOv3, que cuenta con 7.000 millones de parámetros, utilizando un conjunto de datos de entrenamiento de aproximadamente un tercio de su tamaño. Para escenarios de implementación con recursos limitados, la serie ofrece versiones destiladas que van desde los 3.000 millones de parámetros hasta tamaños más reducidos, lo que garantiza un rendimiento de predicción densa de primer nivel en diversas configuraciones de hardware.
Para demostrar el valor práctico de la tecnología, el equipo de desarrollo también ha actualizado el sistema de completado de profundidad a LingBot-Depth 2.0. Las pruebas indican mejoras significativas en la precisión al tratar objetos transparentes, un punto ciego tradicional de la percepción. A medida que aumenta el volumen de datos, el rendimiento de LingBot-Vision sigue escalando sin la saturación típica de los modelos tradicionales, lo que valida aún más el potencial de su arquitectura de percepción espacial centrada en los límites en entornos complejos del mundo real.
LingBot-Vision es ahora de código abierto en su totalidad en Hugging Face bajo la licencia Apache-2.0, incluyendo los pesos y el código de inferencia para cuatro tamaños de modelo, desde el más grande hasta el más pequeño. Esta tecnología permite a los desarrolladores dotar a los robots de capacidades de percepción física más sensibles con menores costes computacionales, allanando el camino hacia un futuro más preciso e interactivo en el ámbito de la inteligencia incorporada.


 GPT 5.5 lidera la carrera de seguridad de IA, DeepSeek encabeza la eficiencia en costos
Kasra Rahjerdi, un investigador de seguridad, publicó recientemente un informe significativo que detalla pruebas prácticas sobre el razonamiento de seguridad de los principales modelos de lenguaje grandes. Logró esto mediante la construcción de una a
 La IA de SpaceX podría superar a Anthropic en menos de medio año, según Musk
El director ejecutivo de SpaceXAI, Elon Musk, prevé que la IA alcance el dominio en un plazo de seis meses, aprovechando el hardware informático para reducir la distancia con la competencia.El directo
 WeRide presenta WITT, un modelo grande de IA física
La tecnología de conducción autónoma avanza a un ritmo extraordinario. El 17 de julio, WeRide, una empresa líder en conducción autónoma, presentó su modelo cognitivo propio de IA física, WeRide WITT.
2026 Últimas mejores herramientas de seguimiento de clasificación con IA mejor valoradas para Google, Resúmenes de IA y visibilidad en motores de respuesta están aquí en XIX.AI. Esta lista seleccionada incluye potentes herramientas que cambian las reglas del juego, sometidas a rigurosas pruebas en el mundo real para ofrecer datos de clasificación precisos. Obtén una comparación gratuita entre versiones gratuitas y de pago, observa a los principales competidores y descubre opciones imprescindibles para aumentar la visibilidad de tu contenido en los motores de búsqueda. Explora ahora para encontrar la herramienta perfecta para tus necesidades.
10 herramientas
xix.ai
2026 Últimas Mejores Organizadores de IA de Segunda Mente Mejor Valorados para Notas y Tareas. XIX.AI ha curado una colección extremadamente poderosa y transformadora, con clasificaciones actualizadas semanalmente, comparaciones entre versiones gratuitas y de pago, y pruebas en el mundo real para ayudarte a encontrar la herramienta perfecta que aumente drásticamente tu productividad. Explora ahora para desbloquear tu ventaja con IA.
11 herramientas
xix.ai

¡Las mejores plataformas de prueba de prompts de IA más recientes y mejor valoradas de 2026 para flujos de trabajo de ChatGPT y Claude! XIX.AI selecciona una poderosa colección revolucionaria, con clasificaciones actualizadas semanalmente, comparaciones entre versiones gratuitas y de pago, pruebas en el mundo real y desgloses detallados de características para ayudarte a identificar las herramientas imprescindibles que aumentan la productividad y ofrecen resultados impecables. Explora ahora para descubrir tu solución perfecta y desbloquear tu ventaja con IA.
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Redacción para Páginas de Aterrizaje de IA para Pruebas A/B de SaaS, Páginas de Precios y Conversión de Demostraciones están aquí en XIX.AI. Esta lista curada de herramientas mejor valoradas ofrece soluciones poderosas que cambian las reglas del juego para mejorar la calidad del contenido, aumentar la eficiencia de redacción y optimizar la productividad general. Realizamos pruebas en el mundo real y proporcionamos una comparación gratuita frente a pagada junto con clasificaciones actualizadas semanalmente. Las opciones obligatorias de probar te ayudan a superar los cuellos de botella de creación. Explora ahora para descubrir tu herramienta perfecta y desbloquear tu ventaja con IA.
8 herramientas
xix.ai

Las mejores herramientas de IA para Excel de 2026 para la planificación del flujo de caja y el control de gastos están aquí en la lista curada y mejor valorada de XIX.AI. Estas poderosas soluciones transformadoras ayudan a aumentar significativamente la productividad mediante pruebas en el mundo real y clasificaciones rigurosas. Obtén una comparación gratuita entre versiones gratuitas y de pago para encontrar la opción perfecta para tus necesidades. Explora ahora para desbloquear tu ventaja con IA en la gestión financiera.
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Gestión de Prompts de IA Mejor Valoradas para Equipos están seleccionadas por XIX.AI aquí. Esta guía actualizada semanalmente presenta soluciones poderosas que cambian las reglas del juego y aumentan significativamente la productividad del equipo mediante pruebas en el mundo real y clasificaciones detalladas. Obtén una comparación gratuita entre versiones gratuitas y de pago para ayudarte a elegir la herramienta perfecta. Explora ahora para desbloquear tu ventaja con IA.
9 herramientas
xix.ai












