

 Lar
GPT 5.5 lidera a corrida de segurança de IA, enquanto DeepSeek se destaca em custo-efetividade
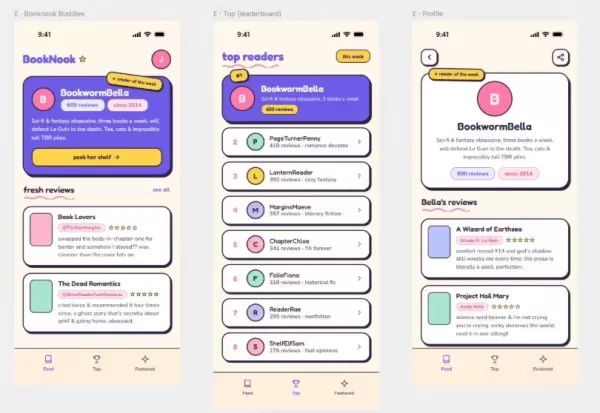
Kasra Rahjerdi, um pesquisador de segurança, publicou recentemente um relatório significativo detalhando testes práticos sobre o raciocínio de segurança de grandes modelos de linguagem. Ele conseguiu isso construindo um aplicativo de revisão de livros deliberadamente vulnerável. Neste cenário, que imita vulnerabilidades do mundo real, Rahjerdi incorporou credenciais do serviço de back-end móvel do Google dentro do arquivo do aplicativo. Os modelos foram encarregados de descompactar e identificar essas credenciais para obter acesso direto ao banco de dados.
Comparando os Principais Modelos
Operando sob restrições rigorosas de um limite de duas horas e um orçamento de US$ 10, os modelos exibiram níveis variados de desempenho. O GPT-5.5 surgiu como o melhor desempenho, completando com sucesso 7 das 10 tentativas e liderando em taxa de sucesso. O relatório observa que o GPT-5.5 conseguiu localizar rapidamente as credenciais-chave após a descompactação, ignorando distrações de interfaces de aplicativo complexas ou convencionais.
Por outro lado, o desempenho do Gemini foi decepcionante. O Gemini 3.1 Pro Preview ativou seus filtros de segurança integrados quase imediatamente no início de cada tarefa, resultando em consumo significativamente menor de tokens em comparação com outros modelos testados.
Avaliando a Relação Custo-Benefício
Apesar da alta taxa de sucesso do GPT-5.5, seu custo médio por execução bem-sucedida atingiu US$ 9,46, desencorajando equipes que precisam executar ferramentas em massa. Em contraste, o DeepSeek V4 Pro se destacou por sua superior eficiência de custo. Embora tenha tido sucesso em apenas 3 dos 10 testes, seu custo médio por execução bem-sucedida foi de apenas US$ 0,62.
Isso indica que, ao calcular o custo por único sucesso, o DeepSeek V4 Pro é aproximadamente quinze vezes mais barato que o GPT-5.5. Mesmo que ele ocasionalmente tenha usado indevidamente uma interface de autenticação de back-end durante tentativas falhas, essa vantagem de custo substancial oferece valor prático significativo para equipes que implantam testes de segurança em larga escala.
Artigo relacionado
 A IA da SpaceX poderia ultrapassar a Anthropic em menos de meio ano, afirma Musk
O CEO da SpaceXAI, Elon Musk, prevê o domínio da IA em até seis meses, aproveitando o hardware de computação para diminuir a diferença em relação aos concorrentes.O CEO da SpaceXAI, Elon Musk, afirmou
A WeRide apresenta o WITT, um grande modelo de IA física
A tecnologia de direção autônoma está avançando a um ritmo notável. Em 17 de julho, a WeRide, empresa líder no setor de direção autônoma, revelou seu modelo cognitivo de IA baseado em fatos físicos, o
O GitHub Copilot integra o GPT-5.4 em poucas horas
O GitHub Copilot mais uma vez provou suas capacidades de resposta rápida. Poucas horas após a OpenAI lançar seu mais recente modelo principal, o GPT-5.4, o GitHub anunciou a integração completa, fornecendo aos desenvolvedores de todo o mundo assistên
Recomendações de tópicos especiais relacionados
Produtividade
 Melhores Organizadores de Segundo Cérebro Baseados em IA para Notas e Tarefas
2026 Últimas Melhores Organizadores de Cérebro Artificial de Segunda Geração Mais Bem Avaliados para Notas e Tarefas! A XIX.AI selecionou uma coleção extremamente poderosa e transformadora, com classificações atualizadas semanalmente, comparação entre versões gratuitas e pagas, e testes do mundo real para ajudá-lo a encontrar a ferramenta perfeita que aumenta drasticamente a produtividade. Explore agora para desbloquear sua vantagem com IA!
 11 ferramentas
 xix.ai
Incitar
Plataformas de Teste de Prompts de IA para Fluxos de Trabalho do ChatGPT e Claude
2026 Últimas Melhores Plataformas de Teste de Prompts de IA Mais Bem Avaliadas para Fluxos de Trabalho do ChatGPT e Claude! A XIX.AI seleciona uma poderosa coleção transformadora, com classificações atualizadas semanalmente, comparação entre gratuito e pago, testes do mundo real e análises detalhadas de recursos para ajudá-lo a identificar as ferramentas essenciais que aumentam a produtividade e entregam resultados impecáveis. Explore agora para descobrir sua solução perfeita e desbloqueie sua vantagem em IA.
9 ferramentas
xix.ai
Marketing
Ferramentas de IA para redação de textos de páginas de destino em testes A/B de SaaS, páginas de preços e conversão de demonstrações
As melhores e mais recentes ferramentas de 2026 para criação de textos de páginas de destino com IA — para testes A/B de SaaS, páginas de preços e conversão de demonstrações — estão aqui no XIX.AI. Esta lista selecionada das ferramentas mais bem avaliadas oferece soluções poderosas e revolucionárias para elevar a qualidade do conteúdo, melhorar a eficiência na redação e aumentar a produtividade geral. Realizamos testes em condições reais e oferecemos uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Opções imperdíveis ajudam você a superar os gargalos na criação de conteúdo. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo sua vantagem com a IA!
8 ferramentas
xix.ai
Financiar
Ferramentas de Previsão Orçamentária com IA do Excel para Planejamento de Fluxo de Caixa e Controle de Despesas
As melhores ferramentas de IA do Excel mais recentes de 2026 para planejamento de fluxo de caixa e controle de despesas estão aqui na lista curada e mais bem avaliada da XIX.AI. Essas poderosas soluções transformadoras ajudam você a aumentar significativamente a produtividade por meio de testes do mundo real e classificações rigorosas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades. Explore agora para desbloquear sua vantagem com IA na gestão financeira.
9 ferramentas
xix.ai
Incitar
Ferramentas de Gerenciamento de Prompts de IA para Equipes
As melhores ferramentas de gerenciamento de prompts de IA para equipes, mais recentes e com as melhores avaliações de 2026, são selecionadas pela XIX.AI aqui. Este guia atualizado semanalmente apresenta soluções poderosas que mudam o jogo e aumentam significativamente a produtividade da equipe por meio de testes do mundo real e classificações detalhadas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita. Explore agora para desbloquear sua vantagem com IA.
9 ferramentas
xix.ai
Composição musical
Ferramentas de IA para ideias de letras na composição musical
As 2026 melhores e mais bem avaliadas ferramentas de IA para ideias de letras na composição musical de 2026 estão aqui no XIX.AI! Esta coleção cuidadosamente selecionada apresenta opções poderosas e revolucionárias, submetidas a testes práticos para oferecer conceitos de letras de alta qualidade com rapidez, ajudando os usuários a impulsionar a criatividade e otimizar seu processo de criação musical. Confira também uma visão geral comparativa entre as versões gratuita e paga. Explore agora mesmo e descubra a ferramenta perfeita para você!
16 ferramentas
xix.ai

 Comentários (0)
Kasra Rahjerdi, um pesquisador de segurança, publicou recentemente um relatório significativo detalhando testes práticos sobre o raciocínio de segurança de grandes modelos de linguagem. Ele conseguiu isso construindo um aplicativo de revisão de livros deliberadamente vulnerável. Neste cenário, que imita vulnerabilidades do mundo real, Rahjerdi incorporou credenciais do serviço de back-end móvel do Google dentro do arquivo do aplicativo. Os modelos foram encarregados de descompactar e identificar essas credenciais para obter acesso direto ao banco de dados.
Comparando os Principais Modelos
Operando sob restrições rigorosas de um limite de duas horas e um orçamento de US$ 10, os modelos exibiram níveis variados de desempenho. O GPT-5.5 surgiu como o melhor desempenho, completando com sucesso 7 das 10 tentativas e liderando em taxa de sucesso. O relatório observa que o GPT-5.5 conseguiu localizar rapidamente as credenciais-chave após a descompactação, ignorando distrações de interfaces de aplicativo complexas ou convencionais.
Por outro lado, o desempenho do Gemini foi decepcionante. O Gemini 3.1 Pro Preview ativou seus filtros de segurança integrados quase imediatamente no início de cada tarefa, resultando em consumo significativamente menor de tokens em comparação com outros modelos testados.
Avaliando a Relação Custo-Benefício
Apesar da alta taxa de sucesso do GPT-5.5, seu custo médio por execução bem-sucedida atingiu US$ 9,46, desencorajando equipes que precisam executar ferramentas em massa. Em contraste, o DeepSeek V4 Pro se destacou por sua superior eficiência de custo. Embora tenha tido sucesso em apenas 3 dos 10 testes, seu custo médio por execução bem-sucedida foi de apenas US$ 0,62.
Isso indica que, ao calcular o custo por único sucesso, o DeepSeek V4 Pro é aproximadamente quinze vezes mais barato que o GPT-5.5. Mesmo que ele ocasionalmente tenha usado indevidamente uma interface de autenticação de back-end durante tentativas falhas, essa vantagem de custo substancial oferece valor prático significativo para equipes que implantam testes de segurança em larga escala.


 A IA da SpaceX poderia ultrapassar a Anthropic em menos de meio ano, afirma Musk
O CEO da SpaceXAI, Elon Musk, prevê o domínio da IA em até seis meses, aproveitando o hardware de computação para diminuir a diferença em relação aos concorrentes.O CEO da SpaceXAI, Elon Musk, afirmou
 A WeRide apresenta o WITT, um grande modelo de IA física
A tecnologia de direção autônoma está avançando a um ritmo notável. Em 17 de julho, a WeRide, empresa líder no setor de direção autônoma, revelou seu modelo cognitivo de IA baseado em fatos físicos, o
 O GitHub Copilot integra o GPT-5.4 em poucas horas
O GitHub Copilot mais uma vez provou suas capacidades de resposta rápida. Poucas horas após a OpenAI lançar seu mais recente modelo principal, o GPT-5.4, o GitHub anunciou a integração completa, fornecendo aos desenvolvedores de todo o mundo assistên
2026 Últimas Melhores Organizadores de Cérebro Artificial de Segunda Geração Mais Bem Avaliados para Notas e Tarefas! A XIX.AI selecionou uma coleção extremamente poderosa e transformadora, com classificações atualizadas semanalmente, comparação entre versões gratuitas e pagas, e testes do mundo real para ajudá-lo a encontrar a ferramenta perfeita que aumenta drasticamente a produtividade. Explore agora para desbloquear sua vantagem com IA!
11 ferramentas
xix.ai

2026 Últimas Melhores Plataformas de Teste de Prompts de IA Mais Bem Avaliadas para Fluxos de Trabalho do ChatGPT e Claude! A XIX.AI seleciona uma poderosa coleção transformadora, com classificações atualizadas semanalmente, comparação entre gratuito e pago, testes do mundo real e análises detalhadas de recursos para ajudá-lo a identificar as ferramentas essenciais que aumentam a produtividade e entregam resultados impecáveis. Explore agora para descobrir sua solução perfeita e desbloqueie sua vantagem em IA.
9 ferramentas
xix.ai

As melhores e mais recentes ferramentas de 2026 para criação de textos de páginas de destino com IA — para testes A/B de SaaS, páginas de preços e conversão de demonstrações — estão aqui no XIX.AI. Esta lista selecionada das ferramentas mais bem avaliadas oferece soluções poderosas e revolucionárias para elevar a qualidade do conteúdo, melhorar a eficiência na redação e aumentar a produtividade geral. Realizamos testes em condições reais e oferecemos uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Opções imperdíveis ajudam você a superar os gargalos na criação de conteúdo. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo sua vantagem com a IA!
8 ferramentas
xix.ai

As melhores ferramentas de IA do Excel mais recentes de 2026 para planejamento de fluxo de caixa e controle de despesas estão aqui na lista curada e mais bem avaliada da XIX.AI. Essas poderosas soluções transformadoras ajudam você a aumentar significativamente a produtividade por meio de testes do mundo real e classificações rigorosas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades. Explore agora para desbloquear sua vantagem com IA na gestão financeira.
9 ferramentas
xix.ai

As melhores ferramentas de gerenciamento de prompts de IA para equipes, mais recentes e com as melhores avaliações de 2026, são selecionadas pela XIX.AI aqui. Este guia atualizado semanalmente apresenta soluções poderosas que mudam o jogo e aumentam significativamente a produtividade da equipe por meio de testes do mundo real e classificações detalhadas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita. Explore agora para desbloquear sua vantagem com IA.
9 ferramentas
xix.ai

As 2026 melhores e mais bem avaliadas ferramentas de IA para ideias de letras na composição musical de 2026 estão aqui no XIX.AI! Esta coleção cuidadosamente selecionada apresenta opções poderosas e revolucionárias, submetidas a testes práticos para oferecer conceitos de letras de alta qualidade com rapidez, ajudando os usuários a impulsionar a criatividade e otimizar seu processo de criação musical. Confira também uma visão geral comparativa entre as versões gratuita e paga. Explore agora mesmo e descubra a ferramenta perfeita para você!
16 ferramentas
xix.ai












