

 Heim
Ant Group veröffentlicht „LingBot-Vision“ als Open-Source-Software und verleiht Robotern räumliches Bewusstsein
Im Bereich der verkörperten Intelligenz stellt es nach wie vor eine grundlegende Herausforderung dar, Robotern die Wahrnehmung des physischen Raums mit menschenähnlicher Präzision zu ermöglichen. Robbyant, eine auf verkörperte KI spezialisierte Tochtergesellschaft der Ant Group, hat die LingBot-Vision-Modellfamilie offiziell als Open Source veröffentlicht. Diese Suite selbstüberwachter Vision-Transformers erzielt durch eine innovative Strategie der „Grenzmodellierung“ außergewöhnliche Ergebnisse bei der dichten räumlichen Wahrnehmung und übertrifft trotz geringerer Parameterzahl größere Modelle in mehreren Benchmarks.
Die meisten aktuellen visuellen Grundmodelle legen den Schwerpunkt auf die „Objekterkennung“ und konzentrieren sich darauf, zu identifizieren, was sich in einem Bild befindet, während sie dabei oft entscheidende Hinweise für physische Interaktionen wie Objektgrenzen, Konturen und Tiefe übersehen. LingBot-Vision kehrt diesen Ansatz um, indem es „Grenzen“ als primäre Signale für das Vortraining behandelt. Durch die Nutzung der Masken-Grenzenmodellierung identifiziert das Modell die informationsreichsten Bereiche in einem Bild und konzentriert sein Training auf diese. Diese Methode ermöglicht es dem Modell, semantisches Verständnis zu erlangen und gleichzeitig eine robuste geometrische räumliche Wahrnehmung zu entwickeln.
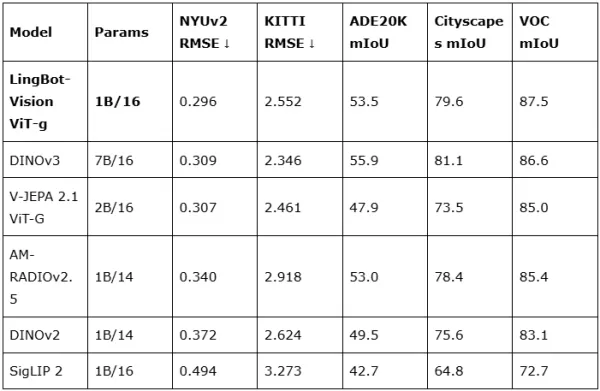
Was die Leistung betrifft, so enthält das Flaggschiff-Modell von LingBot-Vision, ViT-g/16, nur 1,1 Milliarden Parameter und erzielt dennoch Ergebnisse auf dem neuesten Stand der Technik bei Tiefenschätzungsaufgaben, einschließlich NYU-Depth v2. Es übertrifft DINOv3, das über 7 Milliarden Parameter verfügt, und nutzt dabei einen Trainingsdatensatz, der etwa ein Drittel so groß ist. Für Einsatzszenarien mit begrenzten Ressourcen bietet die Serie „destillierte“ Versionen an, die von 3 Milliarden Parametern bis hin zu kleineren Größen reichen und eine erstklassige dichte Vorhersageleistung über verschiedene Hardwarekonfigurationen hinweg gewährleisten.
Um den praktischen Nutzen der Technologie zu demonstrieren, hat das Entwicklungsteam zudem das Tiefenvervollständigungssystem auf LingBot-Depth 2.0 aktualisiert. Tests zeigen deutliche Genauigkeitsverbesserungen beim Umgang mit transparenten Objekten, einem traditionellen „blinden Fleck“ der Wahrnehmung. Mit steigendem Datenvolumen lässt sich die Leistung von LingBot-Vision weiterhin skalieren, ohne dass es zu der für herkömmliche Modelle typischen Sättigung kommt, was das Potenzial seiner grenzorientierten Architektur zur räumlichen Wahrnehmung in komplexen realen Umgebungen weiter untermauert.
LingBot-Vision ist nun auf Hugging Face unter der Apache-2.0-Lizenz vollständig als Open Source verfügbar, einschließlich der Gewichte und des Inferenzcodes für vier Modellgrößen, von groß bis klein. Diese Technologie ermöglicht es Entwicklern, Roboter mit sensibleren physischen Wahrnehmungsfähigkeiten bei geringeren Rechenkosten auszustatten und ebnet damit den Weg für eine präzisere und interaktivere Zukunft im Bereich der verkörperten Intelligenz.
Verwandter Artikel
 GPT 5.5 führt den KI-Sicherheitswettbewerb an, DeepSeek führt bei der Kosteneffizienz.
Kasra Rahjerdi, ein Sicherheitsforscher, hat kürzlich einen bedeutenden Bericht veröffentlicht, der praktische Tests zur Sicherheitslogik großer Sprachmodelle im Detail beschreibt. Dies gelang ihm durch den Aufbau einer absichtlich anfälligen Buchrez
SpaceX-KI könnte Anthropic innerhalb eines halben Jahres überholen, sagt Musk
Elon Musk, CEO von SpaceXAI, prognostiziert, dass sein Unternehmen innerhalb von sechs Monaten eine führende Position im Bereich der KI einnehmen wird, indem es Rechenhardware einsetzt, um den Rücksta
WeRide stellt WITT vor, ein physikalisches KI-Großmodell
Die Technologie für autonomes Fahren entwickelt sich in bemerkenswertem Tempo weiter. Am 17. Juli stellte WeRide, ein führendes Unternehmen im Bereich des autonomen Fahrens, sein firmeneigenes kogniti
Empfehlungen zu verwandten Spezialthemen
SEO
 KI-Tools zur Rangverfolgung bei Google, KI-Übersichten und Sichtbarkeit in Antwort-Suchmaschinen
Die neuesten und am besten bewerteten KI-Tools zur Ranking-Verfolgung für Google, KI-Übersichten und die Sichtbarkeit in Antwortmaschinen für das Jahr 2026 finden Sie hier auf XIX.AI. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzise Ranking-Daten zu liefern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich die Spitzenreiter an und entdecken Sie unverzichtbare Optionen, um die Sichtbarkeit Ihrer Inhalte in Suchmaschinen zu steigern. Stöbern Sie jetzt und finden Sie das perfekte Tool für Ihre Anforderungen.
 10 Tools
 xix.ai
Produktivität
Die besten KI-gestützten Second-Brain-Organizer für Notizen und Aufgaben
2026 Neueste Besten Top-Bewertete KI-Zweitgehirn-Organisatoren für Notizen und Aufgaben! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion kuratiert, mit wöchentlich aktualisierten Rankings, einem Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie praxisnahen Tests, um Ihnen zu helfen, das perfekte Werkzeug zu finden, das Ihre Produktivität erheblich steigert. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
11 Tools
xix.ai
Prompt
AI-Prompt-Testplattformen für ChatGPT- und Claude-Workflows
2026 Neueste Besten Top-Bewerteten KI-Prompt-Testplattformen für ChatGPT- und Claude-Workflows! XIX.AI kuratiert eine leistungsstarke, spielfreudige Sammlung mit wöchentlich aktualisierten Rankings, kostenlosen versus kostenpflichtigen Vergleichen, realen Tests und detaillierten Funktionsübersichten, um Ihnen zu helfen, die wichtigsten Tools zu identifizieren, die die Produktivität steigern und fehlerfreie Ergebnisse liefern. Entdecken Sie jetzt Ihre perfekte Lösung und nutzen Sie Ihren KI-Vorteil. (249 Zeichen)
9 Tools
xix.ai
Marketing
KI-Landingpage-Copy-Tools für SaaS-A/B-Tests, Preisgestaltungsseiten und Demo-Konvertierung
2026 Neueste und beste KI-Tools für Landing Page-Copywriting für SaaS-A/B-Tests, Preisgestaltungsseiten und Demo-Konversionen finden Sie hier auf XIX.AI. Diese kuratierte Liste der am besten bewerteten Tools bietet leistungsstarke, bahnbrechende Lösungen zur Steigerung der Inhaltsqualität, Verbesserung der Schreibeffizienz und Erhöhung der Gesamteffizienz. Wir führen Praxistests durch und bieten einen kostenlosen im Vergleich zu kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings. Unbedingt auszuprobierende Optionen helfen Ihnen, Kreativitätsengpässe zu durchbrechen. Entdecken Sie jetzt Ihr perfektes Tool und erschließen Sie Ihren KI-Vorteil!
8 Tools
xix.ai
Finanzen
Excel KI-Budgetprognose-Tools für die Cashflow-Planung und Kostenkontrolle
2026 Neueste beste Excel-KI-Tools für die Cashflow-Planung und Kostenkontrolle finden Sie auf der hochbewerteten, kuratierten Liste von XIX.AI. Diese leistungsstarken, bahnbrechenden Lösungen helfen Ihnen, die Produktivität durch praxisnahe Tests und strenge Bewertungen erheblich zu steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenpflichtigen und kostenlosen Optionen, um die perfekte Lösung für Ihre Bedürfnisse zu finden. Entdecken Sie jetzt, um Ihren KI-Vorteil im Finanzmanagement zu nutzen.
9 Tools
xix.ai
Prompt
AI-Prompt-Management-Tools für Teams
2026 Neueste Besten Top-Bewertete KI-Prompt-Management-Tools für Teams werden hier von XIX.AI kuratiert. Dieser wöchentlich aktualisierte Leitfaden bietet leistungsstarke, bahnbrechende Lösungen, die die Produktivität von Teams durch reale Tests und detaillierte Ranglisten erheblich steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Version, um das perfekte Tool auszuwählen. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten.
9 Tools
xix.ai

 Kommentare (0)
Im Bereich der verkörperten Intelligenz stellt es nach wie vor eine grundlegende Herausforderung dar, Robotern die Wahrnehmung des physischen Raums mit menschenähnlicher Präzision zu ermöglichen. Robbyant, eine auf verkörperte KI spezialisierte Tochtergesellschaft der Ant Group, hat die LingBot-Vision-Modellfamilie offiziell als Open Source veröffentlicht. Diese Suite selbstüberwachter Vision-Transformers erzielt durch eine innovative Strategie der „Grenzmodellierung“ außergewöhnliche Ergebnisse bei der dichten räumlichen Wahrnehmung und übertrifft trotz geringerer Parameterzahl größere Modelle in mehreren Benchmarks.
Die meisten aktuellen visuellen Grundmodelle legen den Schwerpunkt auf die „Objekterkennung“ und konzentrieren sich darauf, zu identifizieren, was sich in einem Bild befindet, während sie dabei oft entscheidende Hinweise für physische Interaktionen wie Objektgrenzen, Konturen und Tiefe übersehen. LingBot-Vision kehrt diesen Ansatz um, indem es „Grenzen“ als primäre Signale für das Vortraining behandelt. Durch die Nutzung der Masken-Grenzenmodellierung identifiziert das Modell die informationsreichsten Bereiche in einem Bild und konzentriert sein Training auf diese. Diese Methode ermöglicht es dem Modell, semantisches Verständnis zu erlangen und gleichzeitig eine robuste geometrische räumliche Wahrnehmung zu entwickeln.
Was die Leistung betrifft, so enthält das Flaggschiff-Modell von LingBot-Vision, ViT-g/16, nur 1,1 Milliarden Parameter und erzielt dennoch Ergebnisse auf dem neuesten Stand der Technik bei Tiefenschätzungsaufgaben, einschließlich NYU-Depth v2. Es übertrifft DINOv3, das über 7 Milliarden Parameter verfügt, und nutzt dabei einen Trainingsdatensatz, der etwa ein Drittel so groß ist. Für Einsatzszenarien mit begrenzten Ressourcen bietet die Serie „destillierte“ Versionen an, die von 3 Milliarden Parametern bis hin zu kleineren Größen reichen und eine erstklassige dichte Vorhersageleistung über verschiedene Hardwarekonfigurationen hinweg gewährleisten.
Um den praktischen Nutzen der Technologie zu demonstrieren, hat das Entwicklungsteam zudem das Tiefenvervollständigungssystem auf LingBot-Depth 2.0 aktualisiert. Tests zeigen deutliche Genauigkeitsverbesserungen beim Umgang mit transparenten Objekten, einem traditionellen „blinden Fleck“ der Wahrnehmung. Mit steigendem Datenvolumen lässt sich die Leistung von LingBot-Vision weiterhin skalieren, ohne dass es zu der für herkömmliche Modelle typischen Sättigung kommt, was das Potenzial seiner grenzorientierten Architektur zur räumlichen Wahrnehmung in komplexen realen Umgebungen weiter untermauert.
LingBot-Vision ist nun auf Hugging Face unter der Apache-2.0-Lizenz vollständig als Open Source verfügbar, einschließlich der Gewichte und des Inferenzcodes für vier Modellgrößen, von groß bis klein. Diese Technologie ermöglicht es Entwicklern, Roboter mit sensibleren physischen Wahrnehmungsfähigkeiten bei geringeren Rechenkosten auszustatten und ebnet damit den Weg für eine präzisere und interaktivere Zukunft im Bereich der verkörperten Intelligenz.


 GPT 5.5 führt den KI-Sicherheitswettbewerb an, DeepSeek führt bei der Kosteneffizienz.
Kasra Rahjerdi, ein Sicherheitsforscher, hat kürzlich einen bedeutenden Bericht veröffentlicht, der praktische Tests zur Sicherheitslogik großer Sprachmodelle im Detail beschreibt. Dies gelang ihm durch den Aufbau einer absichtlich anfälligen Buchrez
 SpaceX-KI könnte Anthropic innerhalb eines halben Jahres überholen, sagt Musk
Elon Musk, CEO von SpaceXAI, prognostiziert, dass sein Unternehmen innerhalb von sechs Monaten eine führende Position im Bereich der KI einnehmen wird, indem es Rechenhardware einsetzt, um den Rücksta
 WeRide stellt WITT vor, ein physikalisches KI-Großmodell
Die Technologie für autonomes Fahren entwickelt sich in bemerkenswertem Tempo weiter. Am 17. Juli stellte WeRide, ein führendes Unternehmen im Bereich des autonomen Fahrens, sein firmeneigenes kogniti
Die neuesten und am besten bewerteten KI-Tools zur Ranking-Verfolgung für Google, KI-Übersichten und die Sichtbarkeit in Antwortmaschinen für das Jahr 2026 finden Sie hier auf XIX.AI. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzise Ranking-Daten zu liefern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich die Spitzenreiter an und entdecken Sie unverzichtbare Optionen, um die Sichtbarkeit Ihrer Inhalte in Suchmaschinen zu steigern. Stöbern Sie jetzt und finden Sie das perfekte Tool für Ihre Anforderungen.
10 Tools
xix.ai
2026 Neueste Besten Top-Bewertete KI-Zweitgehirn-Organisatoren für Notizen und Aufgaben! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion kuratiert, mit wöchentlich aktualisierten Rankings, einem Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie praxisnahen Tests, um Ihnen zu helfen, das perfekte Werkzeug zu finden, das Ihre Produktivität erheblich steigert. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
11 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Prompt-Testplattformen für ChatGPT- und Claude-Workflows! XIX.AI kuratiert eine leistungsstarke, spielfreudige Sammlung mit wöchentlich aktualisierten Rankings, kostenlosen versus kostenpflichtigen Vergleichen, realen Tests und detaillierten Funktionsübersichten, um Ihnen zu helfen, die wichtigsten Tools zu identifizieren, die die Produktivität steigern und fehlerfreie Ergebnisse liefern. Entdecken Sie jetzt Ihre perfekte Lösung und nutzen Sie Ihren KI-Vorteil. (249 Zeichen)
9 Tools
xix.ai

2026 Neueste und beste KI-Tools für Landing Page-Copywriting für SaaS-A/B-Tests, Preisgestaltungsseiten und Demo-Konversionen finden Sie hier auf XIX.AI. Diese kuratierte Liste der am besten bewerteten Tools bietet leistungsstarke, bahnbrechende Lösungen zur Steigerung der Inhaltsqualität, Verbesserung der Schreibeffizienz und Erhöhung der Gesamteffizienz. Wir führen Praxistests durch und bieten einen kostenlosen im Vergleich zu kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings. Unbedingt auszuprobierende Optionen helfen Ihnen, Kreativitätsengpässe zu durchbrechen. Entdecken Sie jetzt Ihr perfektes Tool und erschließen Sie Ihren KI-Vorteil!
8 Tools
xix.ai

2026 Neueste beste Excel-KI-Tools für die Cashflow-Planung und Kostenkontrolle finden Sie auf der hochbewerteten, kuratierten Liste von XIX.AI. Diese leistungsstarken, bahnbrechenden Lösungen helfen Ihnen, die Produktivität durch praxisnahe Tests und strenge Bewertungen erheblich zu steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenpflichtigen und kostenlosen Optionen, um die perfekte Lösung für Ihre Bedürfnisse zu finden. Entdecken Sie jetzt, um Ihren KI-Vorteil im Finanzmanagement zu nutzen.
9 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Prompt-Management-Tools für Teams werden hier von XIX.AI kuratiert. Dieser wöchentlich aktualisierte Leitfaden bietet leistungsstarke, bahnbrechende Lösungen, die die Produktivität von Teams durch reale Tests und detaillierte Ranglisten erheblich steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Version, um das perfekte Tool auszuwählen. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten.
9 Tools
xix.ai












