

 Дом
Ant Group открыла исходный код LingBot-Vision, что позволяет роботам ориентироваться в пространстве
В области воплощённого интеллекта одной из основных задач по-прежнему остаётся обеспечение роботам возможности воспринимать физическое пространство с точностью, сравнимой с человеческой. Robbyant, дочерняя компания Ant Group, специализирующаяся на воплощённом искусственном интеллекте, официально открыла исходный код семейства моделей LingBot-Vision. Этот набор самообучаемых трансформеров для обработки изображений достигает исключительных результатов в плотном пространственном восприятии благодаря инновационной стратегии «моделирования границ», превосходя по производительности более крупные модели по многим тестам, несмотря на меньшее количество параметров.
Большинство современных базовых моделей зрительного восприятия уделяют приоритетное внимание «распознаванию объектов», сосредоточиваясь на определении того, что изображено на снимке, при этом зачастую упуская из виду важнейшие признаки физического взаимодействия, такие как границы объектов, контуры и глубина. LingBot-Vision переворачивает этот подход, рассматривая «границы» в качестве основных сигналов для предварительного обучения. Используя моделирование границ с помощью масок, модель выявляет области изображения с наибольшей информационной плотностью и сосредотачивает на них своё обучение. Этот метод позволяет модели приобретать семантическое понимание и одновременно развивать надёжное геометрическое пространственное восприятие.
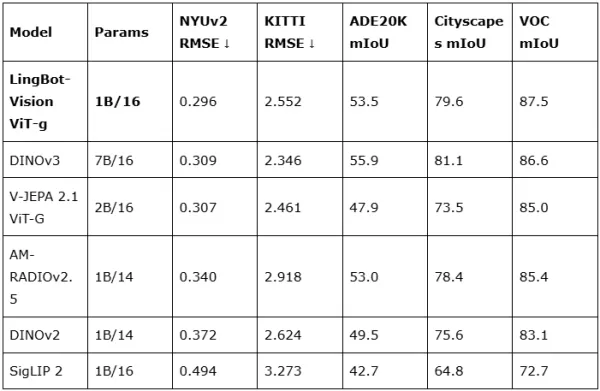
Что касается производительности, то флагманская модель LingBot-Vision, ViT-g/16, содержит всего 1,1 миллиарда параметров, но при этом достигает передовых результатов в задачах оценки глубины, включая NYU-Depth v2. Она превосходит DINOv3, имеющую 7 миллиардов параметров, при этом используя обучающий набор данных, размер которого составляет примерно одну треть от размера DINOv3. Для сценариев развертывания с ограниченными ресурсами серия предлагает дистиллированные версии с количеством параметров от 3 миллиардов до меньших значений, обеспечивая высочайшую производительность плотного прогнозирования на различных аппаратных конфигурациях.
Чтобы продемонстрировать практическую ценность технологии, команда разработчиков также модернизировала систему восстановления глубины до версии LingBot-Depth 2.0. Тесты показывают значительное повышение точности при обработке прозрачных объектов — традиционного «слепого пятна» систем восприятия. По мере увеличения объема данных производительность LingBot-Vision продолжает масштабироваться без насыщения, характерного для традиционных моделей, что еще раз подтверждает потенциал её архитектуры пространственного восприятия, ориентированной на границы, в сложных реальных средах.
LingBot-Vision теперь полностью доступен с открытым исходным кодом на Hugging Face по лицензии Apache-2.0, включая веса и код инференса для четырёх размеров моделей — от крупных до мелких. Эта технология позволяет разработчикам наделять роботов более чувствительными способностями физического восприятия при меньших вычислительных затратах, прокладывая путь к более точному и интерактивному будущему в области воплощённого интеллекта.
Связанная статья
 GPT 5.5 лидирует в гонке за безопасность ИИ, DeepSeek превосходит по эффективности затрат
Касра Раджерди, исследователь безопасности, недавно опубликовал значимый отчет, в котором подробно описываются практические тесты на способность к логическому рассуждению в вопросах безопасности крупных языковых моделей. Он достиг этого, создав намер
ИИ SpaceX может обогнать Anthropic уже через полгода, заявляет Маск
Генеральный директор SpaceXAI Илон Маск прогнозирует, что его компания займет лидирующие позиции в сфере ИИ в течение шести месяцев, используя вычислительное оборудование для сокращения отставания от
WeRide представляет WITT — физическую крупномасштабную модель искусственного интеллекта
Технологии автономного вождения развиваются с поразительной скоростью. 17 июля WeRide, ведущая компания в области автономного вождения, представила свою собственную когнитивную базовую модель искусств
Рекомендации по связанным специальным темам
SEO
 Инструменты отслеживания позиций ИИ для Google, ИИ-обзоров и видимости в поисковых системах
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее высоко оцененные инструменты отслеживания позиций ИИ для Google, ИИ-обзоров и видимости в поисковых системах. Этот тщательно отобранный список включает мощные инструменты, меняющие правила игры, которые проходят строгие реальные тесты для предоставления точных данных о позициях. Получите бесплатное сравнение с платными версиями, посмотрите на лучших представителей и откройте для себя обязательные к использованию варианты, чтобы повысить видимость вашего контента в поисковых системах. Исследуйте сейчас, чтобы найти идеальный инструмент для ваших потребностей.
 10 инструментов
 xix.ai
Производительность
Лучшие ИИ-организаторы для заметок и задач
2026 год: лучшие, топовые и высокооцененные ИИ-организаторы для заметок и задач! XIX.AI подобрал невероятно мощный, меняющий правила игры набор инструментов, включающий еженедельно обновляемые рейтинги, сравнение бесплатных и платных версий, а также реальные тесты, чтобы помочь вам найти идеальный инструмент, значительно повышающий продуктивность. Исследуйте сейчас, чтобы раскрыть своё преимущество с ИИ!
11 инструментов
xix.ai
Быстрый
Платформы для тестирования промптов ИИ для рабочих процессов ChatGPT и Claude
Платформы для тестирования промптов ИИ 2026 года: лучшие и наиболее рейтинговые решения для рабочих процессов ChatGPT и Claude! XIX.AI предлагает мощную коллекцию, меняющую правила игры, с еженедельно обновляемыми рейтингами, сравнением бесплатных и платных вариантов, реальными тестами и подробным разбором функций, чтобы помочь вам определить инструменты, которые необходимо попробовать для повышения продуктивности и получения безупречных результатов. Изучите их сейчас, чтобы найти идеальное решение и раскрыть свой потенциал в использовании ИИ.
9 инструментов
xix.ai
Маркетинг
Инструменты для создания текста посадочных страниц на основе ИИ для A/B-тестов SaaS, страниц с ценами и конверсии демо
2026 Latest Best AI Landing Page Copy Tools for SaaS A/B Tests, Pricing Pages, and Demo Conversion are here on XIX.AI. [[IMG_BASE64_PLACEHOLDER]] Этот тщательно подобранный список лучших инструментов предлагает мощные решения, способные изменить правила игры, повысить качество контента, улучшить эффективность написания и повысить общую продуктивность. Мы проводим реальные тесты и предоставляем бесплатное vs платное сравнение вместе с еженедельно обновляемыми рейтингами. Обязательные для пробных вариантов помогут вам преодолеть творческие ограничения. Исследуйте сейчас, чтобы найти свой идеальный инструмент и раскрыть свой ИИ-потенциал!
8 инструментов
xix.ai
Финансы
Инструменты прогнозирования бюджета Excel на основе ИИ для планирования денежных потоков и контроля расходов
В 2026 году лучшие инструменты Excel на базе искусственного интеллекта для планирования денежных потоков и контроля расходов представлены в рейтинговом списке XIX.AI, получившем высшие оценки. Эти мощные решения, меняющие правила игры, помогают значительно повысить продуктивность благодаря реальным испытаниям и строгим рейтингам. Получите бесплатное сравнение платных и бесплатных версий, чтобы найти идеальное решение для ваших потребностей. Изучите их сейчас, чтобы получить преимущество от использования искусственного интеллекта в финансовом управлении.
9 инструментов
xix.ai
Быстрый
Инструменты управления промптами для команд
В 2026 году лучшие, самые популярные инструменты управления AI-промптами для команд, отобранные XIX.AI, представлены здесь. Этот еженедельно обновляемый гайд включает мощные решения, меняющие правила игры, которые значительно повышают продуктивность команд благодаря реальным тестам и подробным рейтингам. Получите бесплатное сравнение платных и бесплатных вариантов, чтобы выбрать идеальный инструмент. Исследуйте сейчас, чтобы раскрыть ваше преимущество в AI.
9 инструментов
xix.ai

 Комментарии (0)
В области воплощённого интеллекта одной из основных задач по-прежнему остаётся обеспечение роботам возможности воспринимать физическое пространство с точностью, сравнимой с человеческой. Robbyant, дочерняя компания Ant Group, специализирующаяся на воплощённом искусственном интеллекте, официально открыла исходный код семейства моделей LingBot-Vision. Этот набор самообучаемых трансформеров для обработки изображений достигает исключительных результатов в плотном пространственном восприятии благодаря инновационной стратегии «моделирования границ», превосходя по производительности более крупные модели по многим тестам, несмотря на меньшее количество параметров.
Большинство современных базовых моделей зрительного восприятия уделяют приоритетное внимание «распознаванию объектов», сосредоточиваясь на определении того, что изображено на снимке, при этом зачастую упуская из виду важнейшие признаки физического взаимодействия, такие как границы объектов, контуры и глубина. LingBot-Vision переворачивает этот подход, рассматривая «границы» в качестве основных сигналов для предварительного обучения. Используя моделирование границ с помощью масок, модель выявляет области изображения с наибольшей информационной плотностью и сосредотачивает на них своё обучение. Этот метод позволяет модели приобретать семантическое понимание и одновременно развивать надёжное геометрическое пространственное восприятие.
Что касается производительности, то флагманская модель LingBot-Vision, ViT-g/16, содержит всего 1,1 миллиарда параметров, но при этом достигает передовых результатов в задачах оценки глубины, включая NYU-Depth v2. Она превосходит DINOv3, имеющую 7 миллиардов параметров, при этом используя обучающий набор данных, размер которого составляет примерно одну треть от размера DINOv3. Для сценариев развертывания с ограниченными ресурсами серия предлагает дистиллированные версии с количеством параметров от 3 миллиардов до меньших значений, обеспечивая высочайшую производительность плотного прогнозирования на различных аппаратных конфигурациях.
Чтобы продемонстрировать практическую ценность технологии, команда разработчиков также модернизировала систему восстановления глубины до версии LingBot-Depth 2.0. Тесты показывают значительное повышение точности при обработке прозрачных объектов — традиционного «слепого пятна» систем восприятия. По мере увеличения объема данных производительность LingBot-Vision продолжает масштабироваться без насыщения, характерного для традиционных моделей, что еще раз подтверждает потенциал её архитектуры пространственного восприятия, ориентированной на границы, в сложных реальных средах.
LingBot-Vision теперь полностью доступен с открытым исходным кодом на Hugging Face по лицензии Apache-2.0, включая веса и код инференса для четырёх размеров моделей — от крупных до мелких. Эта технология позволяет разработчикам наделять роботов более чувствительными способностями физического восприятия при меньших вычислительных затратах, прокладывая путь к более точному и интерактивному будущему в области воплощённого интеллекта.


 GPT 5.5 лидирует в гонке за безопасность ИИ, DeepSeek превосходит по эффективности затрат
Касра Раджерди, исследователь безопасности, недавно опубликовал значимый отчет, в котором подробно описываются практические тесты на способность к логическому рассуждению в вопросах безопасности крупных языковых моделей. Он достиг этого, создав намер
 ИИ SpaceX может обогнать Anthropic уже через полгода, заявляет Маск
Генеральный директор SpaceXAI Илон Маск прогнозирует, что его компания займет лидирующие позиции в сфере ИИ в течение шести месяцев, используя вычислительное оборудование для сокращения отставания от
 WeRide представляет WITT — физическую крупномасштабную модель искусственного интеллекта
Технологии автономного вождения развиваются с поразительной скоростью. 17 июля WeRide, ведущая компания в области автономного вождения, представила свою собственную когнитивную базовую модель искусств
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее высоко оцененные инструменты отслеживания позиций ИИ для Google, ИИ-обзоров и видимости в поисковых системах. Этот тщательно отобранный список включает мощные инструменты, меняющие правила игры, которые проходят строгие реальные тесты для предоставления точных данных о позициях. Получите бесплатное сравнение с платными версиями, посмотрите на лучших представителей и откройте для себя обязательные к использованию варианты, чтобы повысить видимость вашего контента в поисковых системах. Исследуйте сейчас, чтобы найти идеальный инструмент для ваших потребностей.
10 инструментов
xix.ai
2026 год: лучшие, топовые и высокооцененные ИИ-организаторы для заметок и задач! XIX.AI подобрал невероятно мощный, меняющий правила игры набор инструментов, включающий еженедельно обновляемые рейтинги, сравнение бесплатных и платных версий, а также реальные тесты, чтобы помочь вам найти идеальный инструмент, значительно повышающий продуктивность. Исследуйте сейчас, чтобы раскрыть своё преимущество с ИИ!
11 инструментов
xix.ai

Платформы для тестирования промптов ИИ 2026 года: лучшие и наиболее рейтинговые решения для рабочих процессов ChatGPT и Claude! XIX.AI предлагает мощную коллекцию, меняющую правила игры, с еженедельно обновляемыми рейтингами, сравнением бесплатных и платных вариантов, реальными тестами и подробным разбором функций, чтобы помочь вам определить инструменты, которые необходимо попробовать для повышения продуктивности и получения безупречных результатов. Изучите их сейчас, чтобы найти идеальное решение и раскрыть свой потенциал в использовании ИИ.
9 инструментов
xix.ai

2026 Latest Best AI Landing Page Copy Tools for SaaS A/B Tests, Pricing Pages, and Demo Conversion are here on XIX.AI. [[IMG_BASE64_PLACEHOLDER]] Этот тщательно подобранный список лучших инструментов предлагает мощные решения, способные изменить правила игры, повысить качество контента, улучшить эффективность написания и повысить общую продуктивность. Мы проводим реальные тесты и предоставляем бесплатное vs платное сравнение вместе с еженедельно обновляемыми рейтингами. Обязательные для пробных вариантов помогут вам преодолеть творческие ограничения. Исследуйте сейчас, чтобы найти свой идеальный инструмент и раскрыть свой ИИ-потенциал!
8 инструментов
xix.ai

В 2026 году лучшие инструменты Excel на базе искусственного интеллекта для планирования денежных потоков и контроля расходов представлены в рейтинговом списке XIX.AI, получившем высшие оценки. Эти мощные решения, меняющие правила игры, помогают значительно повысить продуктивность благодаря реальным испытаниям и строгим рейтингам. Получите бесплатное сравнение платных и бесплатных версий, чтобы найти идеальное решение для ваших потребностей. Изучите их сейчас, чтобы получить преимущество от использования искусственного интеллекта в финансовом управлении.
9 инструментов
xix.ai

В 2026 году лучшие, самые популярные инструменты управления AI-промптами для команд, отобранные XIX.AI, представлены здесь. Этот еженедельно обновляемый гайд включает мощные решения, меняющие правила игры, которые значительно повышают продуктивность команд благодаря реальным тестам и подробным рейтингам. Получите бесплатное сравнение платных и бесплатных вариантов, чтобы выбрать идеальный инструмент. Исследуйте сейчас, чтобы раскрыть ваше преимущество в AI.
9 инструментов
xix.ai












