


 Maison
L'IA axée sur l'optimisation apparaît comme une nouvelle voie vers des modèles à usage général
Des chercheurs de l'université de l'Illinois à Urbana-Champaign et de l'université de Virginie ont créé une nouvelle architecture de modèle qui pourrait ouvrir la voie à des systèmes d'IA plus résilients et dotés d'une capacité de raisonnement améliorée.
Baptisée « transformateur basé sur l'énergie » (EBT), cette architecture exploite naturellement la mise à l'échelle du temps d'inférence pour relever des défis complexes. Pour les entreprises, cela se traduit par des applications d'IA rentables, capables de s'adapter à de nouveaux scénarios sans nécessiter de modèles spécialisés et finement réglés.
Le défi de la pensée du système 2
En psychologie, la cognition humaine est généralement divisée en deux modes : le système 1, qui est rapide et instinctif, et le système 2, qui est plus lent, plus réfléchi et analytique. Les grands modèles linguistiques (LLM) actuels excellent dans les tâches du système 1, mais le domaine de l'IA se concentre désormais sur le développement de la pensée du système 2 afin de traiter des problèmes de raisonnement plus complexes.
Les modèles de raisonnement utilisent diverses méthodes de mise à l'échelle du temps d'inférence pour améliorer leurs performances sur les questions difficiles. Une technique courante est l'apprentissage par renforcement (RL), utilisé dans des modèles tels que DeepSeek-R1 et la « série o » d'OpenAI, où l'IA gagne des récompenses pour générer des jetons de raisonnement jusqu'à ce qu'elle arrive à la bonne solution. Une autre stratégie, souvent appelée « best-of-n », consiste à créer plusieurs réponses possibles et à utiliser un système de vérification pour choisir la meilleure.
Cependant, ces approches présentent des limites notables. Elles se limitent généralement à un ensemble restreint de problèmes facilement vérifiables, comme les mathématiques et le codage, et peuvent réduire les performances sur d'autres tâches telles que l'écriture créative. De plus, des études récentes indiquent que les méthodes basées sur le RL n'enseignent peut-être pas aux modèles de nouvelles compétences de raisonnement, mais les encouragent simplement à réutiliser des modèles de raisonnement efficaces qu'ils connaissent déjà. Cela limite leur capacité à résoudre des problèmes qui exigent une véritable exploration au-delà de leur champ d'entraînement.
Modèles basés sur l'énergie (EBM)
Cette nouvelle architecture emprunte une voie différente, en s'appuyant sur une classe de modèles appelés modèles basés sur l'énergie (EBM). Le concept central est simple : plutôt que de générer directement une réponse, le modèle apprend une « fonction d'énergie » qui sert de vérificateur. Cette fonction prend une entrée (telle qu'une invite) et une prédiction candidate, puis lui attribue une valeur, ou « énergie ». Un score d'énergie faible suggère une compatibilité élevée, ce qui signifie que la prédiction correspond bien à l'entrée, tandis qu'un score d'énergie élevé indique une mauvaise correspondance.
En appliquant cela au raisonnement de l'IA, les chercheurs proposent dans un article que les développeurs envisagent « la réflexion comme une procédure d'optimisation par rapport à un vérificateur appris, qui évalue la compatibilité (probabilité non normalisée) entre une entrée et une prédiction candidate ». Le processus commence par une prédiction aléatoire, qui est ensuite progressivement affinée en minimisant son score d'énergie et en explorant les solutions possibles jusqu'à ce qu'elle converge vers une réponse hautement compatible. Cette méthode repose sur l'idée que la vérification d'une solution est souvent beaucoup plus simple que d'en générer une à partir de zéro.
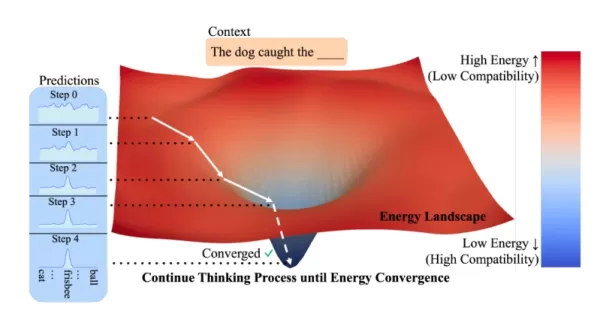
Cette conception « centrée sur le vérificateur » relève trois défis majeurs du raisonnement de l'IA. Premièrement, elle permet une allocation dynamique des ressources de calcul, laissant les modèles « réfléchir » plus longtemps sur les problèmes difficiles et moins sur les plus faciles. Deuxièmement, les EBM s'adaptent naturellement à l'incertitude des problèmes du monde réel, pour lesquels il n'existe pas de réponse claire unique. Troisièmement, ils fonctionnent comme leurs propres vérificateurs, éliminant ainsi le besoin de modèles externes.
Contrairement à d'autres systèmes qui utilisent des générateurs et des vérificateurs distincts, les EBM intègrent les deux dans un modèle unique et unifié. L'un des principaux avantages de cette configuration est l'amélioration de la généralisation. Étant donné qu'il est généralement plus facile de vérifier une solution sur des données nouvelles, hors distribution (OOD), que de générer une réponse correcte, les EBM peuvent mieux gérer les situations inconnues.
Malgré leur potentiel, les EBM ont toujours été confrontés à des problèmes d'évolutivité. Pour y remédier, les chercheurs ont introduit les EBT, des modèles de transformateurs spécialisés conçus pour ce cadre. Les EBT sont entraînés à vérifier d'abord la compatibilité entre un contexte et une prédiction, puis à affiner les prédictions jusqu'à ce qu'ils identifient la sortie la moins énergique (la plus compatible). Cette procédure imite efficacement un processus de réflexion pour chaque prédiction. L'équipe a créé deux variantes d'EBT : un modèle à décodeur unique inspiré de l'architecture GPT et un modèle bidirectionnel similaire à BERT.
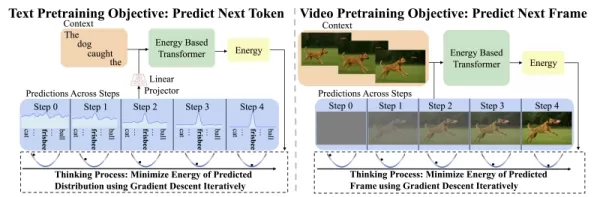
Transformateur basé sur l'énergie (source : GitHub) L'architecture des EBT les rend adaptables et compatibles avec diverses méthodes de mise à l'échelle au moment de l'inférence. « Les EBT peuvent générer des CoT plus longs, s'auto-vérifier, faire le meilleur choix parmi plusieurs options [ou] vous pouvez échantillonner à partir de nombreux EBT », a déclaré Alexi Gladstone, doctorant en informatique à l'université de l'Illinois à Urbana-Champaign et auteur principal de l'article, à VentureBeat. « Le plus intéressant, c'est que toutes ces capacités sont acquises pendant la préformation. »
Les EBT en action
Les chercheurs ont testé les EBT par rapport à des architectures établies : la recette populaire transformer++ pour la génération de texte (modalités discrètes) et le diffuseur de transformation (DiT) pour des tâches telles que la prédiction vidéo et le débruitage d'images (modalités continues). Ils ont évalué les modèles sur la base de deux critères principaux : « l'évolutivité de l'apprentissage », ou l'efficacité de leur formation, et « l'évolutivité de la réflexion », qui mesure l'amélioration des performances grâce à un calcul plus important pendant l'inférence.
Au cours du pré-entraînement, les EBT ont montré une efficacité supérieure, atteignant un taux de mise à l'échelle jusqu'à 35 % supérieur à celui de Transformer++ pour l'ensemble des données, la taille des lots, les paramètres et les calculs. Cela signifie que les EBT peuvent être entraînés plus rapidement et à moindre coût.
Au niveau de l'inférence, les EBT ont également surpassé les modèles existants dans les tâches de raisonnement. En « réfléchissant plus longtemps » (en utilisant davantage d'étapes d'optimisation) et en effectuant une « auto-vérification » (en générant plusieurs candidats et en sélectionnant celui qui consomme le moins d'énergie), les EBT ont amélioré les performances de modélisation linguistique de 29 % par rapport à Transformer++. « Cela correspond à notre affirmation selon laquelle, comme les transformateurs feed-forward traditionnels ne peuvent pas allouer dynamiquement des calculs supplémentaires pour chaque prédiction effectuée, ils ne sont pas en mesure d'améliorer les performances pour chaque token en réfléchissant plus longtemps », expliquent les chercheurs.
Pour le débruitage d'images, les EBT ont donné de meilleurs résultats que les DiT tout en utilisant 99 % de passes avant en moins.
Il est important de noter que l'étude a révélé que les EBT généralisent plus efficacement que les autres architectures. Même avec des performances de pré-entraînement identiques ou inférieures, les EBT ont surpassé les modèles existants dans les tâches en aval. Les gains de performance liés à la réflexion du système 2 ont été particulièrement marqués sur les données qui étaient plus éloignées de la distribution (contrairement aux données d'entraînement), ce qui indique que les EBT sont particulièrement robustes lorsqu'ils sont confrontés à des défis nouveaux et difficiles.
Les chercheurs notent que « les avantages de la pensée des EBT ne sont pas uniformes pour toutes les données, mais augmentent proportionnellement à l'ampleur des changements de distribution, ce qui souligne l'importance de la pensée comme mécanisme essentiel pour une généralisation robuste au-delà des distributions d'entraînement ».
Les avantages des EBT sont significatifs pour deux raisons principales. Premièrement, ils suggèrent qu'à l'échelle massive des modèles de base actuels, les EBT pourraient largement surpasser l'architecture classique des transformateurs utilisée dans les LLM. Les auteurs observent qu'« à l'échelle des modèles de base modernes entraînés sur 1 000 fois plus de données avec des modèles 1 000 fois plus grands, nous nous attendons à ce que les performances de pré-entraînement des EBT soient nettement supérieures à celles de la recette Transformer++ ».
Deuxièmement, les EBT démontrent une efficacité des données bien supérieure. Il s'agit là d'un avantage crucial à une époque où les données d'entraînement de haute qualité constituent de plus en plus un obstacle majeur à la mise à l'échelle de l'IA. « Les données étant devenues l'un des principaux facteurs limitant la poursuite de la mise à l'échelle, cela rend les EBT particulièrement attrayants », indique l'article.
Malgré son mécanisme d'inférence différent, l'architecture EBT est hautement compatible avec le transformateur, ce qui lui permet de remplacer directement les LLM actuels.
« Les EBT sont très compatibles avec les frameworks matériels/d'inférence actuels », a déclaré M. Gladstone, y compris le décodage spéculatif utilisant des modèles feed-forward sur les GPU ou les TPU. Il a ajouté qu'il était convaincu qu'ils pouvaient fonctionner sur des accélérateurs spécialisés tels que les LPU et des algorithmes d'optimisation comme FlashAttention-3, ou être déployés via des frameworks d'inférence courants tels que vLLM.
Pour les développeurs et les entreprises, les solides capacités de raisonnement et de généralisation des EBT pourraient en faire une base puissante et fiable pour la création de la prochaine génération d'applications d'IA. « Une réflexion plus approfondie peut être utile dans presque toutes les applications d'entreprise, mais je pense que les plus intéressantes seront celles qui nécessitent des décisions plus importantes, la sécurité ou des applications avec des données limitées », a déclaré M. Gladstone.
Article connexe
 Base44 dévoile son modèle d’IA propriétaire pour renforcer la défensabilité de sa plateforme de codage par ambiance
Base44, la plateforme de codage par « vibe » acquise par Wix pour 80 millions de dollars il y a seulement un an — alors qu’elle n’avait que six mois et une équipe de huit personnes — a commencé à déployer son modèle d’IA propriétaire afin d’aider les
Bayer s'appuie sur Iambic AI pour accélérer la découverte de médicaments
Le Dr Juergen Eckhardt occupe le poste de responsable du développement commercial et des licences chez Bayer Pharmaceuticals.Bayer s'appuie sur Iambic Therapeutics pour déployer des modèles d'IA de po
Multiverse Computing lance un modèle d'IA générative compressé gratuit
Les grands modèles linguistiques sont confrontés à un défi de taille : leur taille immense. La start-up espagnole Multiverse Computing s'attaque à ce problème en créant des modèles compressés con
Recommandations de sujets spéciaux liés
en écrivant
 Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
 8 outils
 xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

 commentaires (0)
Des chercheurs de l'université de l'Illinois à Urbana-Champaign et de l'université de Virginie ont créé une nouvelle architecture de modèle qui pourrait ouvrir la voie à des systèmes d'IA plus résilients et dotés d'une capacité de raisonnement améliorée.
Baptisée « transformateur basé sur l'énergie » (EBT), cette architecture exploite naturellement la mise à l'échelle du temps d'inférence pour relever des défis complexes. Pour les entreprises, cela se traduit par des applications d'IA rentables, capables de s'adapter à de nouveaux scénarios sans nécessiter de modèles spécialisés et finement réglés.
Le défi de la pensée du système 2
En psychologie, la cognition humaine est généralement divisée en deux modes : le système 1, qui est rapide et instinctif, et le système 2, qui est plus lent, plus réfléchi et analytique. Les grands modèles linguistiques (LLM) actuels excellent dans les tâches du système 1, mais le domaine de l'IA se concentre désormais sur le développement de la pensée du système 2 afin de traiter des problèmes de raisonnement plus complexes.
Les modèles de raisonnement utilisent diverses méthodes de mise à l'échelle du temps d'inférence pour améliorer leurs performances sur les questions difficiles. Une technique courante est l'apprentissage par renforcement (RL), utilisé dans des modèles tels que DeepSeek-R1 et la « série o » d'OpenAI, où l'IA gagne des récompenses pour générer des jetons de raisonnement jusqu'à ce qu'elle arrive à la bonne solution. Une autre stratégie, souvent appelée « best-of-n », consiste à créer plusieurs réponses possibles et à utiliser un système de vérification pour choisir la meilleure.
Cependant, ces approches présentent des limites notables. Elles se limitent généralement à un ensemble restreint de problèmes facilement vérifiables, comme les mathématiques et le codage, et peuvent réduire les performances sur d'autres tâches telles que l'écriture créative. De plus, des études récentes indiquent que les méthodes basées sur le RL n'enseignent peut-être pas aux modèles de nouvelles compétences de raisonnement, mais les encouragent simplement à réutiliser des modèles de raisonnement efficaces qu'ils connaissent déjà. Cela limite leur capacité à résoudre des problèmes qui exigent une véritable exploration au-delà de leur champ d'entraînement.
Modèles basés sur l'énergie (EBM)
Cette nouvelle architecture emprunte une voie différente, en s'appuyant sur une classe de modèles appelés modèles basés sur l'énergie (EBM). Le concept central est simple : plutôt que de générer directement une réponse, le modèle apprend une « fonction d'énergie » qui sert de vérificateur. Cette fonction prend une entrée (telle qu'une invite) et une prédiction candidate, puis lui attribue une valeur, ou « énergie ». Un score d'énergie faible suggère une compatibilité élevée, ce qui signifie que la prédiction correspond bien à l'entrée, tandis qu'un score d'énergie élevé indique une mauvaise correspondance.
En appliquant cela au raisonnement de l'IA, les chercheurs proposent dans un article que les développeurs envisagent « la réflexion comme une procédure d'optimisation par rapport à un vérificateur appris, qui évalue la compatibilité (probabilité non normalisée) entre une entrée et une prédiction candidate ». Le processus commence par une prédiction aléatoire, qui est ensuite progressivement affinée en minimisant son score d'énergie et en explorant les solutions possibles jusqu'à ce qu'elle converge vers une réponse hautement compatible. Cette méthode repose sur l'idée que la vérification d'une solution est souvent beaucoup plus simple que d'en générer une à partir de zéro.
Cette conception « centrée sur le vérificateur » relève trois défis majeurs du raisonnement de l'IA. Premièrement, elle permet une allocation dynamique des ressources de calcul, laissant les modèles « réfléchir » plus longtemps sur les problèmes difficiles et moins sur les plus faciles. Deuxièmement, les EBM s'adaptent naturellement à l'incertitude des problèmes du monde réel, pour lesquels il n'existe pas de réponse claire unique. Troisièmement, ils fonctionnent comme leurs propres vérificateurs, éliminant ainsi le besoin de modèles externes.
Contrairement à d'autres systèmes qui utilisent des générateurs et des vérificateurs distincts, les EBM intègrent les deux dans un modèle unique et unifié. L'un des principaux avantages de cette configuration est l'amélioration de la généralisation. Étant donné qu'il est généralement plus facile de vérifier une solution sur des données nouvelles, hors distribution (OOD), que de générer une réponse correcte, les EBM peuvent mieux gérer les situations inconnues.
Malgré leur potentiel, les EBM ont toujours été confrontés à des problèmes d'évolutivité. Pour y remédier, les chercheurs ont introduit les EBT, des modèles de transformateurs spécialisés conçus pour ce cadre. Les EBT sont entraînés à vérifier d'abord la compatibilité entre un contexte et une prédiction, puis à affiner les prédictions jusqu'à ce qu'ils identifient la sortie la moins énergique (la plus compatible). Cette procédure imite efficacement un processus de réflexion pour chaque prédiction. L'équipe a créé deux variantes d'EBT : un modèle à décodeur unique inspiré de l'architecture GPT et un modèle bidirectionnel similaire à BERT.
L'architecture des EBT les rend adaptables et compatibles avec diverses méthodes de mise à l'échelle au moment de l'inférence. « Les EBT peuvent générer des CoT plus longs, s'auto-vérifier, faire le meilleur choix parmi plusieurs options [ou] vous pouvez échantillonner à partir de nombreux EBT », a déclaré Alexi Gladstone, doctorant en informatique à l'université de l'Illinois à Urbana-Champaign et auteur principal de l'article, à VentureBeat. « Le plus intéressant, c'est que toutes ces capacités sont acquises pendant la préformation. »
Les EBT en action
Les chercheurs ont testé les EBT par rapport à des architectures établies : la recette populaire transformer++ pour la génération de texte (modalités discrètes) et le diffuseur de transformation (DiT) pour des tâches telles que la prédiction vidéo et le débruitage d'images (modalités continues). Ils ont évalué les modèles sur la base de deux critères principaux : « l'évolutivité de l'apprentissage », ou l'efficacité de leur formation, et « l'évolutivité de la réflexion », qui mesure l'amélioration des performances grâce à un calcul plus important pendant l'inférence.
Au cours du pré-entraînement, les EBT ont montré une efficacité supérieure, atteignant un taux de mise à l'échelle jusqu'à 35 % supérieur à celui de Transformer++ pour l'ensemble des données, la taille des lots, les paramètres et les calculs. Cela signifie que les EBT peuvent être entraînés plus rapidement et à moindre coût.
Au niveau de l'inférence, les EBT ont également surpassé les modèles existants dans les tâches de raisonnement. En « réfléchissant plus longtemps » (en utilisant davantage d'étapes d'optimisation) et en effectuant une « auto-vérification » (en générant plusieurs candidats et en sélectionnant celui qui consomme le moins d'énergie), les EBT ont amélioré les performances de modélisation linguistique de 29 % par rapport à Transformer++. « Cela correspond à notre affirmation selon laquelle, comme les transformateurs feed-forward traditionnels ne peuvent pas allouer dynamiquement des calculs supplémentaires pour chaque prédiction effectuée, ils ne sont pas en mesure d'améliorer les performances pour chaque token en réfléchissant plus longtemps », expliquent les chercheurs.
Pour le débruitage d'images, les EBT ont donné de meilleurs résultats que les DiT tout en utilisant 99 % de passes avant en moins.
Il est important de noter que l'étude a révélé que les EBT généralisent plus efficacement que les autres architectures. Même avec des performances de pré-entraînement identiques ou inférieures, les EBT ont surpassé les modèles existants dans les tâches en aval. Les gains de performance liés à la réflexion du système 2 ont été particulièrement marqués sur les données qui étaient plus éloignées de la distribution (contrairement aux données d'entraînement), ce qui indique que les EBT sont particulièrement robustes lorsqu'ils sont confrontés à des défis nouveaux et difficiles.
Les chercheurs notent que « les avantages de la pensée des EBT ne sont pas uniformes pour toutes les données, mais augmentent proportionnellement à l'ampleur des changements de distribution, ce qui souligne l'importance de la pensée comme mécanisme essentiel pour une généralisation robuste au-delà des distributions d'entraînement ».
Les avantages des EBT sont significatifs pour deux raisons principales. Premièrement, ils suggèrent qu'à l'échelle massive des modèles de base actuels, les EBT pourraient largement surpasser l'architecture classique des transformateurs utilisée dans les LLM. Les auteurs observent qu'« à l'échelle des modèles de base modernes entraînés sur 1 000 fois plus de données avec des modèles 1 000 fois plus grands, nous nous attendons à ce que les performances de pré-entraînement des EBT soient nettement supérieures à celles de la recette Transformer++ ».
Deuxièmement, les EBT démontrent une efficacité des données bien supérieure. Il s'agit là d'un avantage crucial à une époque où les données d'entraînement de haute qualité constituent de plus en plus un obstacle majeur à la mise à l'échelle de l'IA. « Les données étant devenues l'un des principaux facteurs limitant la poursuite de la mise à l'échelle, cela rend les EBT particulièrement attrayants », indique l'article.
Malgré son mécanisme d'inférence différent, l'architecture EBT est hautement compatible avec le transformateur, ce qui lui permet de remplacer directement les LLM actuels.
« Les EBT sont très compatibles avec les frameworks matériels/d'inférence actuels », a déclaré M. Gladstone, y compris le décodage spéculatif utilisant des modèles feed-forward sur les GPU ou les TPU. Il a ajouté qu'il était convaincu qu'ils pouvaient fonctionner sur des accélérateurs spécialisés tels que les LPU et des algorithmes d'optimisation comme FlashAttention-3, ou être déployés via des frameworks d'inférence courants tels que vLLM.
Pour les développeurs et les entreprises, les solides capacités de raisonnement et de généralisation des EBT pourraient en faire une base puissante et fiable pour la création de la prochaine génération d'applications d'IA. « Une réflexion plus approfondie peut être utile dans presque toutes les applications d'entreprise, mais je pense que les plus intéressantes seront celles qui nécessitent des décisions plus importantes, la sécurité ou des applications avec des données limitées », a déclaré M. Gladstone.








 Base44 dévoile son modèle d’IA propriétaire pour renforcer la défensabilité de sa plateforme de codage par ambiance
Base44, la plateforme de codage par « vibe » acquise par Wix pour 80 millions de dollars il y a seulement un an — alors qu’elle n’avait que six mois et une équipe de huit personnes — a commencé à déployer son modèle d’IA propriétaire afin d’aider les
 Bayer s'appuie sur Iambic AI pour accélérer la découverte de médicaments
Le Dr Juergen Eckhardt occupe le poste de responsable du développement commercial et des licences chez Bayer Pharmaceuticals.Bayer s'appuie sur Iambic Therapeutics pour déployer des modèles d'IA de po
 Multiverse Computing lance un modèle d'IA générative compressé gratuit
Les grands modèles linguistiques sont confrontés à un défi de taille : leur taille immense. La start-up espagnole Multiverse Computing s'attaque à ce problème en créant des modèles compressés con

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai












