


 Дом
Оптимизация-ориентированный ИИ становится новым путем к универсальным моделям
Исследователи из Университета Иллинойса в Урбана-Шампейне и Университета Вирджинии создали новую архитектуру модели, которая может открыть путь к созданию более устойчивых систем искусственного интеллекта с улучшенными способностями к логическому мышлению.
Эта архитектура, получившая название «энергетический трансформатор» (EBT), естественным образом использует масштабирование времени вывода для решения сложных задач. Для бизнеса это означает экономичные приложения искусственного интеллекта, которые могут адаптироваться к новым сценариям без необходимости использования специализированных, точно настроенных моделей.
Проблема мышления системы 2
В психологии человеческое познание обычно делится на два режима: система 1, которая является быстрой и инстинктивной, и система 2, которая является более медленной, обдуманной и аналитической. Современные большие языковые модели (LLM) отлично справляются с задачами системы 1, но в настоящее время в области искусственного интеллекта основное внимание уделяется развитию мышления системы 2 для решения более сложных задач рассуждения.
Модели рассуждений используют различные методы масштабирования времени вывода, чтобы повысить свою производительность при решении сложных вопросов. Распространенной техникой является обучение с подкреплением (RL), используемое в таких моделях, как DeepSeek-R1 и «o-series» от OpenAI, где ИИ получает вознаграждение за генерацию токенов рассуждений, пока не придет к правильному решению. Другая стратегия, часто называемая «best-of-n», предполагает создание нескольких возможных ответов и использование системы проверки для выбора лучшего из них.
Однако эти подходы имеют заметные ограничения. Они обычно ограничиваются узким набором легко проверяемых задач, таких как математика и программирование, и могут снижать производительность при решении других задач, таких как творческое письмо. Более того, недавние исследования показывают, что методы, основанные на RL, возможно, не обучают модели новым навыкам рассуждения, а просто поощряют их повторно использовать уже известные им успешные модели рассуждения. Это ограничивает их способность решать задачи, требующие подлинного исследования за пределами области их обучения.
Энергетические модели (EBM)
Эта новая архитектура идет по другому пути, основываясь на классе моделей, известных как энергетические модели (EBM). Основная концепция проста: вместо того, чтобы напрямую генерировать ответ, модель изучает «энергетическую функцию», которая служит в качестве верификатора. Эта функция принимает входные данные (например, подсказку) и кандидатское предсказание, а затем присваивает им значение, или «энергию». Низкий энергетический балл означает высокую совместимость, то есть прогноз хорошо соответствует входу, а высокий энергетический балл указывает на плохое соответствие.
Применяя это к рассуждениям ИИ, исследователи предлагают в своей статье, чтобы разработчики рассматривали «мышление как процедуру оптимизации в отношении обученного верификатора, который оценивает совместимость (ненормализованную вероятность) между входными данными и кандидатом в прогноз». Процесс начинается со случайного прогноза, который затем постепенно уточняется путем минимизации его энергетического балла и изучения возможных решений, пока он не сходится к высокосовместимому ответу. Этот метод основан на идее, что проверка решения часто гораздо проще, чем его генерация с нуля.
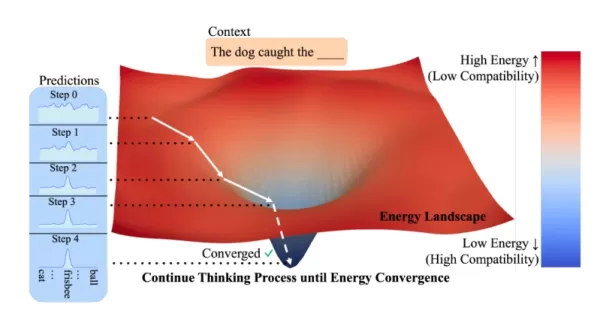
Эта «ориентированная на верификатор» конструкция решает три основные проблемы в рассуждениях ИИ. Во-первых, она позволяет динамически распределять вычислительные ресурсы, позволяя моделям «думать» дольше над сложными проблемами и меньше над более простыми. Во-вторых, EBM естественным образом учитывают неопределенность реальных проблем, для которых не существует единственного четкого ответа. В-третьих, они функционируют как собственные верификаторы, устраняя необходимость во внешних моделях.
В отличие от других систем, которые используют отдельные генераторы и верификаторы, EBM объединяют оба компонента в единую модель. Основным преимуществом такой конфигурации является улучшенная обобщаемость. Поскольку проверка решения на новых данных, не входящих в распределение (OOD), обычно проще, чем генерация правильного ответа, EBM могут лучше справляться с незнакомыми ситуациями.
Несмотря на свой потенциал, EBM исторически сталкивались с проблемами масштабируемости. Чтобы решить эту проблему, исследователи представили EBT — специализированные трансформаторные модели, разработанные для этой структуры. EBT обучаются сначала проверять совместимость между контекстом и прогнозом, а затем уточнять прогнозы, пока не определят выход с наименьшей энергией (наиболее совместимый). Эта процедура эффективно имитирует процесс мышления для каждого прогноза. Команда создала два варианта EBT: модель только с декодером, вдохновленную архитектурой GPT, и двунаправленную модель, похожую на BERT.
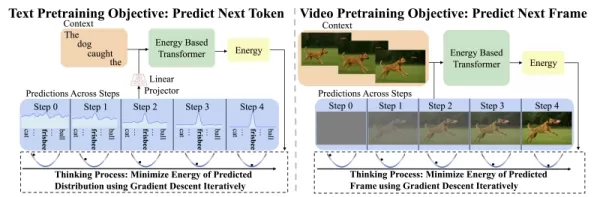
Трансформатор на основе энергии (источник: GitHub) Архитектура EBT делает их адаптируемыми и совместимыми с различными методами масштабирования времени вывода. «EBT могут генерировать более длинные CoT, самопроверяться, выбирать лучшее из N [или] вы можете брать выборку из многих EBT», — сказал VentureBeat Алекси Гладстоун, докторант по информатике в Университете Иллинойса в Урбана-Шампейне и ведущий автор статьи. «Самое лучшее, что все эти возможности изучаются во время предварительного обучения».
EBT в действии
Исследователи протестировали EBT по сравнению с устоявшимися архитектурами: популярным рецептом transformer++ для генерации текста (дискретные модальности) и диффузионным трансформатором (DiT) для таких задач, как прогнозирование видео и удаление шума из изображений (непрерывные модальности). Они оценивали модели по двум основным критериям: «масштабируемость обучения», или эффективность обучения, и «масштабируемость мышления», которая измеряет, насколько производительность улучшается при увеличении вычислений во время инференции.
Во время предварительного обучения EBT продемонстрировали превосходную эффективность, достигнув на 35 % более высокой скорости масштабирования, чем Transformer++, по всем данным, размеру партии, параметрам и вычислениям. Это означает, что EBT можно обучать быстрее и с меньшими затратами.
При выводе EBT также превзошли существующие модели в задачах рассуждения. Благодаря «более длительному мышлению» (использованию большего количества шагов оптимизации) и «самопроверке» (генерации нескольких кандидатов и выбору того, который имеет наименьшую энергию), EBT улучшили производительность языкового моделирования на 29 % по сравнению с Transformer++. «Это согласуется с нашими утверждениями о том, что, поскольку традиционные трансформеры с прямой передачей не могут динамически распределять дополнительные вычисления для каждого прогноза, они не могут улучшить производительность для каждого токена, думая дольше», — объясняют исследователи.
При удалении шума из изображений EBT показали лучшие результаты, чем DiT, при этом используя на 99 % меньше прямых проходов.
Важно отметить, что исследование показало, что EBT более эффективно обобщают, чем другие архитектуры. Даже при одинаковой или более слабой производительности предварительного обучения EBT превосходили существующие модели по задачам ниже по цепочке. Увеличение производительности за счет мышления системы 2 было наиболее выраженным на данных, которые были более далеки от распределения (в отличие от данных обучения), что указывает на то, что EBT особенно устойчивы при решении новых и сложных задач.
Исследователи отмечают, что «преимущества мышления EBT не являются одинаковыми для всех данных, но масштабируются положительно с величиной сдвигов распределения, подчеркивая мышление как критический механизм для надежной генерализации за пределами распределений обучения».
Преимущества EBT значительны по двум ключевым причинам. Во-первых, они предполагают, что при массовом масштабе современных базовых моделей EBT могут существенно превосходить классическую архитектуру трансформатора, используемую в LLM. Авторы отмечают, что «при масштабе современных базовых моделей, обученных на 1000 раз большем объеме данных с моделями, которые в 1000 раз больше, мы ожидаем, что производительность EBT при предварительном обучении будет значительно лучше, чем у Transformer++».
Во-вторых, EBT демонстрируют гораздо большую эффективность использования данных. Это является решающим преимуществом в эпоху, когда высококачественные обучающие данные все чаще становятся основным препятствием для масштабирования ИИ. «Поскольку данные стали одним из основных факторов, ограничивающих дальнейшее масштабирование, это делает EBT особенно привлекательными», — говорится в статье.
Несмотря на другой механизм вывода, архитектура EBT высоко совместима с трансформером, что позволяет ей служить прямой заменой для текущих LLM.
«EBT очень совместимы с текущим аппаратным обеспечением/инфраструктурой вывода», — сказал Гладстоун, включая спекулятивное декодирование с использованием моделей прямой передачи данных на GPU или TPU. Он добавил, что уверен, что они могут работать на специализированных ускорителях, таких как LPU, и с алгоритмами оптимизации, такими как FlashAttention-3, или могут быть развернуты через общие инфраструктуры вывода, такие как vLLM.
Для разработчиков и предприятий сильные способности EBT к рассуждению и обобщению могут сделать их мощной и надежной основой для создания приложений искусственного интеллекта следующего поколения. «Более длительное мышление может в целом помочь почти всем корпоративным приложениям, но я думаю, что наиболее интересными будут те, которые требуют более важных решений, безопасности или приложений с ограниченными данными», — сказал Гладстоун.
Связанная статья
 Base44 представляет собственную модель искусственного интеллекта для усиления защищенности платформы для кодинга в стиле «vibe».
Base44, платформа для «вайб-кодинга», приобретённая Wix за 80 миллионов долларов всего год назад — когда ей было всего шесть месяцев и в команде состояло восемь человек, — начала развертывание собственной модели искусственного интеллекта, чтобы помоч
Компания «Байер» использует технологию Iambic AI для ускорения разработки лекарственных препаратов
Доктор Юрген Экхардт занимает должность руководителя отдела развития бизнеса и лицензирования в компании «Байер Фарма».Компания «Байер» использует возможности компании Iambic Therapeutics для внедрени
Multiverse Computing запускает бесплатную сжатую генеративную модель искусственного интеллекта
Крупные языковые модели сталкиваются с серьезной проблемой: их огромный размер. Испанский стартап Multiverse Computing решает эту проблему, создавая сжатые модели, призванные преодолеть разрыв между в
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
 9 инструментов
 xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai
Образование и обучение
Платформы для создания викторин с ИИ для учителей, репетиторов и программ обучения в группах
2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai
код
Инструменты на базе ИИ для проверки пулл-реквестов в командах GitHub, занимающихся рефакторингом, устранением ошибок и устранением уязвимостей
2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai

 Комментарии (0)
Исследователи из Университета Иллинойса в Урбана-Шампейне и Университета Вирджинии создали новую архитектуру модели, которая может открыть путь к созданию более устойчивых систем искусственного интеллекта с улучшенными способностями к логическому мышлению.
Эта архитектура, получившая название «энергетический трансформатор» (EBT), естественным образом использует масштабирование времени вывода для решения сложных задач. Для бизнеса это означает экономичные приложения искусственного интеллекта, которые могут адаптироваться к новым сценариям без необходимости использования специализированных, точно настроенных моделей.
Проблема мышления системы 2
В психологии человеческое познание обычно делится на два режима: система 1, которая является быстрой и инстинктивной, и система 2, которая является более медленной, обдуманной и аналитической. Современные большие языковые модели (LLM) отлично справляются с задачами системы 1, но в настоящее время в области искусственного интеллекта основное внимание уделяется развитию мышления системы 2 для решения более сложных задач рассуждения.
Модели рассуждений используют различные методы масштабирования времени вывода, чтобы повысить свою производительность при решении сложных вопросов. Распространенной техникой является обучение с подкреплением (RL), используемое в таких моделях, как DeepSeek-R1 и «o-series» от OpenAI, где ИИ получает вознаграждение за генерацию токенов рассуждений, пока не придет к правильному решению. Другая стратегия, часто называемая «best-of-n», предполагает создание нескольких возможных ответов и использование системы проверки для выбора лучшего из них.
Однако эти подходы имеют заметные ограничения. Они обычно ограничиваются узким набором легко проверяемых задач, таких как математика и программирование, и могут снижать производительность при решении других задач, таких как творческое письмо. Более того, недавние исследования показывают, что методы, основанные на RL, возможно, не обучают модели новым навыкам рассуждения, а просто поощряют их повторно использовать уже известные им успешные модели рассуждения. Это ограничивает их способность решать задачи, требующие подлинного исследования за пределами области их обучения.
Энергетические модели (EBM)
Эта новая архитектура идет по другому пути, основываясь на классе моделей, известных как энергетические модели (EBM). Основная концепция проста: вместо того, чтобы напрямую генерировать ответ, модель изучает «энергетическую функцию», которая служит в качестве верификатора. Эта функция принимает входные данные (например, подсказку) и кандидатское предсказание, а затем присваивает им значение, или «энергию». Низкий энергетический балл означает высокую совместимость, то есть прогноз хорошо соответствует входу, а высокий энергетический балл указывает на плохое соответствие.
Применяя это к рассуждениям ИИ, исследователи предлагают в своей статье, чтобы разработчики рассматривали «мышление как процедуру оптимизации в отношении обученного верификатора, который оценивает совместимость (ненормализованную вероятность) между входными данными и кандидатом в прогноз». Процесс начинается со случайного прогноза, который затем постепенно уточняется путем минимизации его энергетического балла и изучения возможных решений, пока он не сходится к высокосовместимому ответу. Этот метод основан на идее, что проверка решения часто гораздо проще, чем его генерация с нуля.
Эта «ориентированная на верификатор» конструкция решает три основные проблемы в рассуждениях ИИ. Во-первых, она позволяет динамически распределять вычислительные ресурсы, позволяя моделям «думать» дольше над сложными проблемами и меньше над более простыми. Во-вторых, EBM естественным образом учитывают неопределенность реальных проблем, для которых не существует единственного четкого ответа. В-третьих, они функционируют как собственные верификаторы, устраняя необходимость во внешних моделях.
В отличие от других систем, которые используют отдельные генераторы и верификаторы, EBM объединяют оба компонента в единую модель. Основным преимуществом такой конфигурации является улучшенная обобщаемость. Поскольку проверка решения на новых данных, не входящих в распределение (OOD), обычно проще, чем генерация правильного ответа, EBM могут лучше справляться с незнакомыми ситуациями.
Несмотря на свой потенциал, EBM исторически сталкивались с проблемами масштабируемости. Чтобы решить эту проблему, исследователи представили EBT — специализированные трансформаторные модели, разработанные для этой структуры. EBT обучаются сначала проверять совместимость между контекстом и прогнозом, а затем уточнять прогнозы, пока не определят выход с наименьшей энергией (наиболее совместимый). Эта процедура эффективно имитирует процесс мышления для каждого прогноза. Команда создала два варианта EBT: модель только с декодером, вдохновленную архитектурой GPT, и двунаправленную модель, похожую на BERT.
Архитектура EBT делает их адаптируемыми и совместимыми с различными методами масштабирования времени вывода. «EBT могут генерировать более длинные CoT, самопроверяться, выбирать лучшее из N [или] вы можете брать выборку из многих EBT», — сказал VentureBeat Алекси Гладстоун, докторант по информатике в Университете Иллинойса в Урбана-Шампейне и ведущий автор статьи. «Самое лучшее, что все эти возможности изучаются во время предварительного обучения».
EBT в действии
Исследователи протестировали EBT по сравнению с устоявшимися архитектурами: популярным рецептом transformer++ для генерации текста (дискретные модальности) и диффузионным трансформатором (DiT) для таких задач, как прогнозирование видео и удаление шума из изображений (непрерывные модальности). Они оценивали модели по двум основным критериям: «масштабируемость обучения», или эффективность обучения, и «масштабируемость мышления», которая измеряет, насколько производительность улучшается при увеличении вычислений во время инференции.
Во время предварительного обучения EBT продемонстрировали превосходную эффективность, достигнув на 35 % более высокой скорости масштабирования, чем Transformer++, по всем данным, размеру партии, параметрам и вычислениям. Это означает, что EBT можно обучать быстрее и с меньшими затратами.
При выводе EBT также превзошли существующие модели в задачах рассуждения. Благодаря «более длительному мышлению» (использованию большего количества шагов оптимизации) и «самопроверке» (генерации нескольких кандидатов и выбору того, который имеет наименьшую энергию), EBT улучшили производительность языкового моделирования на 29 % по сравнению с Transformer++. «Это согласуется с нашими утверждениями о том, что, поскольку традиционные трансформеры с прямой передачей не могут динамически распределять дополнительные вычисления для каждого прогноза, они не могут улучшить производительность для каждого токена, думая дольше», — объясняют исследователи.
При удалении шума из изображений EBT показали лучшие результаты, чем DiT, при этом используя на 99 % меньше прямых проходов.
Важно отметить, что исследование показало, что EBT более эффективно обобщают, чем другие архитектуры. Даже при одинаковой или более слабой производительности предварительного обучения EBT превосходили существующие модели по задачам ниже по цепочке. Увеличение производительности за счет мышления системы 2 было наиболее выраженным на данных, которые были более далеки от распределения (в отличие от данных обучения), что указывает на то, что EBT особенно устойчивы при решении новых и сложных задач.
Исследователи отмечают, что «преимущества мышления EBT не являются одинаковыми для всех данных, но масштабируются положительно с величиной сдвигов распределения, подчеркивая мышление как критический механизм для надежной генерализации за пределами распределений обучения».
Преимущества EBT значительны по двум ключевым причинам. Во-первых, они предполагают, что при массовом масштабе современных базовых моделей EBT могут существенно превосходить классическую архитектуру трансформатора, используемую в LLM. Авторы отмечают, что «при масштабе современных базовых моделей, обученных на 1000 раз большем объеме данных с моделями, которые в 1000 раз больше, мы ожидаем, что производительность EBT при предварительном обучении будет значительно лучше, чем у Transformer++».
Во-вторых, EBT демонстрируют гораздо большую эффективность использования данных. Это является решающим преимуществом в эпоху, когда высококачественные обучающие данные все чаще становятся основным препятствием для масштабирования ИИ. «Поскольку данные стали одним из основных факторов, ограничивающих дальнейшее масштабирование, это делает EBT особенно привлекательными», — говорится в статье.
Несмотря на другой механизм вывода, архитектура EBT высоко совместима с трансформером, что позволяет ей служить прямой заменой для текущих LLM.
«EBT очень совместимы с текущим аппаратным обеспечением/инфраструктурой вывода», — сказал Гладстоун, включая спекулятивное декодирование с использованием моделей прямой передачи данных на GPU или TPU. Он добавил, что уверен, что они могут работать на специализированных ускорителях, таких как LPU, и с алгоритмами оптимизации, такими как FlashAttention-3, или могут быть развернуты через общие инфраструктуры вывода, такие как vLLM.
Для разработчиков и предприятий сильные способности EBT к рассуждению и обобщению могут сделать их мощной и надежной основой для создания приложений искусственного интеллекта следующего поколения. «Более длительное мышление может в целом помочь почти всем корпоративным приложениям, но я думаю, что наиболее интересными будут те, которые требуют более важных решений, безопасности или приложений с ограниченными данными», — сказал Гладстоун.








 Base44 представляет собственную модель искусственного интеллекта для усиления защищенности платформы для кодинга в стиле «vibe».
Base44, платформа для «вайб-кодинга», приобретённая Wix за 80 миллионов долларов всего год назад — когда ей было всего шесть месяцев и в команде состояло восемь человек, — начала развертывание собственной модели искусственного интеллекта, чтобы помоч
 Компания «Байер» использует технологию Iambic AI для ускорения разработки лекарственных препаратов
Доктор Юрген Экхардт занимает должность руководителя отдела развития бизнеса и лицензирования в компании «Байер Фарма».Компания «Байер» использует возможности компании Iambic Therapeutics для внедрени
 Multiverse Computing запускает бесплатную сжатую генеративную модель искусственного интеллекта
Крупные языковые модели сталкиваются с серьезной проблемой: их огромный размер. Испанский стартап Multiverse Computing решает эту проблему, создавая сжатые модели, призванные преодолеть разрыв между в

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai

2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai












