


 家
最適化主導型AIが汎用モデルへの新たな道として台頭
イリノイ大学アーバナ・シャンペーン校とバージニア大学の研究者らは、強化された推論能力を備えたより強靭なAIシステムへの道を開く可能性のある新たなモデルアーキテクチャを開発した。
エネルギーベーストランスフォーマー(EBT)と名付けられたこのアーキテクチャは、推論時のスケーリングを自然に活用して複雑な課題に対処する。企業にとっては、専用に微調整されたモデルを必要とせず、新たなシナリオに適応できるコスト効率の高いAIアプリケーションを意味する。
システム2思考の課題
心理学では、人間の認知は通常2つのモードに分けられる:迅速で直感的な「システム1」と、より遅く、慎重で分析的な「システム2」である。現在の大規模言語モデル(LLM)はシステム1タスクに優れているが、AI分野ではより複雑な推論問題に対処するため、システム2思考の開発に注力している。
推論モデルは難問への対応力を高めるため、様々な推論時スケーリング手法を採用している。代表的な手法が強化学習(RL)であり、DeepSeek-R1やOpenAIの「o-series」モデルでは、AIが推論トークンを生成するたびに報酬を得て、最終的に正解に到達するまで学習する。別の戦略として「ベスト・オブ・n」と呼ばれる手法では、複数の解答候補を生成し、検証システムを用いて最適なものを選択する。
しかし、これらのアプローチには顕著な限界がある。通常、数学やコーディングなど容易に検証可能な狭い問題群に限定され、創造的ライティングなどの他のタスクでは性能が低下する可能性がある。さらに、最近の研究によれば、RLベースの手法はモデルに新たな推論スキルを教えず、単に既知の成功した推論パターンの再利用を促している可能性がある。これにより、トレーニング範囲を超えた真の探索を必要とする問題解決能力が制限される。
エネルギーベースモデル(EBM)
この新たなアーキテクチャは異なるアプローチを取り、エネルギーベースモデル(EBM)として知られるモデル群を基盤としている。中核となる概念は単純明快である:モデルは直接的に解答を生成するのではなく、検証器として機能する「エネルギー関数」を学習する。この関数は入力(プロンプトなど)と候補予測を受け取り、それに値、すなわち「エネルギー」を割り当てる。 エネルギー値が低いほど適合性が高く(予測が入力に合致している)、高いほど適合性が低いことを示す。
この概念をAI推論に応用し、研究者らは論文で「開発者は推論を、学習済み検証器に対する最適化手続きとして捉えるべきである」と提案している。この検証器は入力と候補予測間の適合性(正規化されていない確率)を評価する。 このプロセスはランダムな予測から始まり、そのエネルギースコアを最小化し可能な解を探索することで徐々に洗練され、最終的に高い適合性を持つ解答に収束する。この手法は、解を検証することがゼロから生成するよりもはるかに容易であるという考えに基づいている。
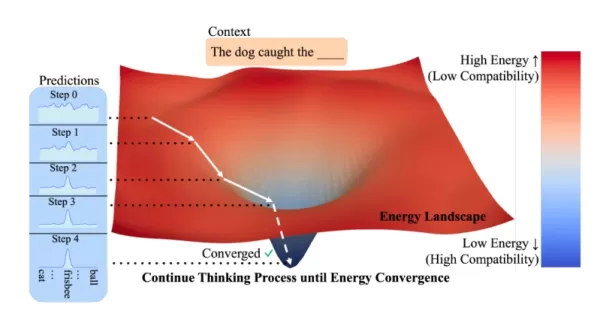
この「検証器中心」設計はAI推論の3大課題を解決する。第一に動的計算リソース配分を可能にし、難問には長く、易問には短く「思考」させる。第二にEBMは現実世界の不確実性(明確な単一解答が存在しない問題)を自然に許容する。第三に自己検証機能を備え、外部モデルが不要となる。
他のシステムが生成器と検証器を分離させるのとは異なり、EBMは両者を単一の統合モデルに組み込む。この構成の主な利点は汎化能力の向上である。分布外(OOD)データにおける解の検証は、通常、正しい答えを生成するよりも容易であるため、EBMは見慣れない状況をより適切に処理できる。
その可能性にもかかわらず、EBMは歴史的にスケーラビリティの問題に直面してきた。この課題に対処するため、研究者らはEBTを導入した。EBTはこのフレームワーク向けに設計された特化型トランスフォーマーモデルである。EBTはまずコンテキストと予測の適合性を確認し、その後、最低エネルギー(最も適合性の高い)出力を特定するまで予測を精緻化するよう訓練される。この手順は、各予測に対する思考プロセスを効果的に模倣する。 チームは2種類のEBTバリエーションを開発した:GPTアーキテクチャに着想を得たデコーダ専用モデルと、BERTに類似した双方向モデルである。
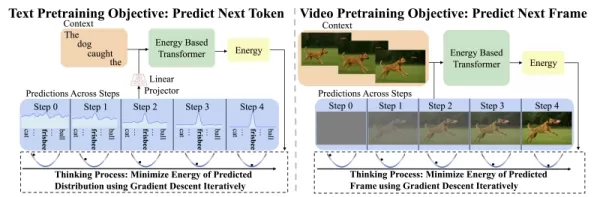
エネルギーベーストランスフォーマー(出典: GitHub) EBTのアーキテクチャは、様々な推論時スケーリング手法への適応性と互換性を備えています。「EBTはより長いCoTを生成でき、自己検証が可能で、ベストオブNを実現できる[あるいは]多数のEBTからサンプリングすることも可能です」と、イリノイ大学アーバナ・シャンペーン校のコンピュータサイエンス博士課程学生であり本論文の筆頭著者であるアレクシー・グラッドストーンはVentureBeatに語りました。 「最も優れた点は、これらの機能が全て事前学習中に習得されることです」
EBTの実践
研究者らはEBTを既存アーキテクチャと比較検証した:テキスト生成(離散モダリティ)向けの高性能トランスフォーマー++手法と、動画予測や画像ノイズ除去(連続モダリティ)向け拡散トランスフォーマー(DiT)である。評価基準は主に2点:「学習スケーラビリティ」(効率的なトレーニング能力)と「推論スケーラビリティ」(推論時の計算量増加に伴う性能向上度)である。
事前学習段階において、EBTはデータ量・バッチサイズ・パラメータ数・計算リソースのあらゆる条件でTransformer++を最大35%上回るスケーリング率を達成し、優れた効率性を示した。これはEBTがより高速かつ低コストで学習可能であることを意味する。
推論段階では、推論タスクにおいてEBTが既存モデルを凌駕した。「より長く思考する」(最適化ステップを増やす)ことと「自己検証」(複数の候補を生成しエネルギーが最も低いものを選択する)を行うことで、EBTはTransformer++より29%高い言語モデリング性能を達成した。 「これは我々の主張と一致する。従来のフィードフォワード型トランスフォーマーは、各予測に対して動的に追加計算を割り当てられないため、より長く考えることでトークンごとの性能を向上させられない」と研究者らは説明する。
画像ノイズ除去では、EBTはDiTよりも優れた結果を出しながら、フォワードパスを99%削減した。
重要な点として、本研究ではEBTが他のアーキテクチャよりも効果的に汎化することが明らかになった。事前学習性能が同等または劣る場合でも、EBTは下流タスクにおいて既存モデルを上回った。システム2思考による性能向上は、訓練データとは異なる分布外データで最も顕著であり、EBTが新規かつ困難な課題に直面した際に特に頑健であることを示している。
研究者らは「EBTの思考効果は全データで均一ではなく、分布の偏りの大きさに比例して顕著に現れる。これは思考が、訓練分布を超えた頑健な一般化を実現する重要なメカニズムであることを強調している」と指摘している。
EBTの優位性は主に2つの理由から重要である。 第一に、今日の基盤モデルの巨大スケールにおいて、EBTはLLMで用いられる古典的なトランスフォーマーアーキテクチャを大幅に上回る可能性を示唆している。著者らは「1000倍の規模で1000倍のデータを学習した現代の基盤モデルでは、EBTの事前学習性能がTransformer++手法を大幅に上回ると予想される」と述べている。
第二に、EBTははるかに高いデータ効率を示す。これは、高品質なトレーニングデータがAIのスケールアップにおける主要なボトルネックとなりつつある時代にあって決定的な利点である。「データの不足がさらなるスケールアップの主要な制約要因となっている現状において、EBTは特に魅力的である」と論文は述べている。
推論メカニズムが異なるにもかかわらず、EBTアーキテクチャはトランスフォーマーと高い互換性を持ち、現行のLLMのドロップイン置換として機能する。
グラッドストーン氏は「EBTは現行のハードウェア/推論フレームワークと極めて互換性が高い」と述べ、GPUやTPU上でのフィードフォワードモデルを用いた推測的デコーディングを含めると説明。さらに、LPUなどの専用アクセラレータやFlashAttention-3のような最適化アルゴリズムでの実行、あるいはvLLMなどの汎用推論フレームワークを通じた展開が可能だと確信していると付け加えた。
開発者や企業にとって、EBTの強力な推論能力と汎化能力は次世代AIアプリケーション構築の堅牢な基盤となり得る。「思考の持続時間はほぼ全ての企業アプリケーションに広く貢献するが、特に重要な意思決定を要する分野、安全関連、データが限られたアプリケーションで真価を発揮するだろう」とグラッドストーンは語った。
関連記事
 Base44、独自開発のAIモデルを公開し、Vibeコーディングプラットフォームの防御力を強化
Base44は、わずか1年前にWixによって8,000万ドルで買収された「バイブコーディング」プラットフォームであり、当時チーム8名、設立からわずか6ヶ月という若さであったが、自然言語を用いてアプリケーションを構築するユーザーを支援するため、独自のAIモデルの提供を開始した。この展開は、最先端モデルがすべてのユースケースにおいて最適かどうか、そして外部モデルに依存する企業が長期的な防衛性を維持できるかどうかをめぐってAIコミュニティが議論している時期に到来した。ベイエリアを拠点とするBase4
バイエル、Iambic AIを活用して創薬プロセスを加速
ユルゲン・エックハルト医学博士は、バイエル・ファーマシューティカルズで事業開発・ライセンス担当責任者を務めています。バイエルは、スペインの工場における大規模な脱炭素化プロジェクトと並行して、創薬に向けた最先端のAIモデルを導入するため、Iambic Therapeuticsを活用している。バイエルは、低分子化合物の創薬および新薬開発を加速させるため、科学技術企業であるIambic Therapeu
マルチバース・コンピューティング、無料圧縮生成AIモデルを発表
大規模言語モデルは重大な課題に直面している:その膨大なサイズである。スペインのスタートアップMultiverse Computingは、最先端AIの能力と企業が実用的に導入できる範囲とのギャップを埋めるべく設計された圧縮モデルを開発することでこの問題に取り組んでいる。同社の革新的な技術「CompactifAI」は量子コンピューティング原理に着想を得た圧縮技術であり、バスク地方のこの企業はOpenA
関連特集おすすめ
書き込み
 長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
 8 ツール
 xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

 コメント (0)
0/500
イリノイ大学アーバナ・シャンペーン校とバージニア大学の研究者らは、強化された推論能力を備えたより強靭なAIシステムへの道を開く可能性のある新たなモデルアーキテクチャを開発した。
エネルギーベーストランスフォーマー(EBT)と名付けられたこのアーキテクチャは、推論時のスケーリングを自然に活用して複雑な課題に対処する。企業にとっては、専用に微調整されたモデルを必要とせず、新たなシナリオに適応できるコスト効率の高いAIアプリケーションを意味する。
システム2思考の課題
心理学では、人間の認知は通常2つのモードに分けられる:迅速で直感的な「システム1」と、より遅く、慎重で分析的な「システム2」である。現在の大規模言語モデル(LLM)はシステム1タスクに優れているが、AI分野ではより複雑な推論問題に対処するため、システム2思考の開発に注力している。
推論モデルは難問への対応力を高めるため、様々な推論時スケーリング手法を採用している。代表的な手法が強化学習(RL)であり、DeepSeek-R1やOpenAIの「o-series」モデルでは、AIが推論トークンを生成するたびに報酬を得て、最終的に正解に到達するまで学習する。別の戦略として「ベスト・オブ・n」と呼ばれる手法では、複数の解答候補を生成し、検証システムを用いて最適なものを選択する。
しかし、これらのアプローチには顕著な限界がある。通常、数学やコーディングなど容易に検証可能な狭い問題群に限定され、創造的ライティングなどの他のタスクでは性能が低下する可能性がある。さらに、最近の研究によれば、RLベースの手法はモデルに新たな推論スキルを教えず、単に既知の成功した推論パターンの再利用を促している可能性がある。これにより、トレーニング範囲を超えた真の探索を必要とする問題解決能力が制限される。
エネルギーベースモデル(EBM)
この新たなアーキテクチャは異なるアプローチを取り、エネルギーベースモデル(EBM)として知られるモデル群を基盤としている。中核となる概念は単純明快である:モデルは直接的に解答を生成するのではなく、検証器として機能する「エネルギー関数」を学習する。この関数は入力(プロンプトなど)と候補予測を受け取り、それに値、すなわち「エネルギー」を割り当てる。 エネルギー値が低いほど適合性が高く(予測が入力に合致している)、高いほど適合性が低いことを示す。
この概念をAI推論に応用し、研究者らは論文で「開発者は推論を、学習済み検証器に対する最適化手続きとして捉えるべきである」と提案している。この検証器は入力と候補予測間の適合性(正規化されていない確率)を評価する。 このプロセスはランダムな予測から始まり、そのエネルギースコアを最小化し可能な解を探索することで徐々に洗練され、最終的に高い適合性を持つ解答に収束する。この手法は、解を検証することがゼロから生成するよりもはるかに容易であるという考えに基づいている。
この「検証器中心」設計はAI推論の3大課題を解決する。第一に動的計算リソース配分を可能にし、難問には長く、易問には短く「思考」させる。第二にEBMは現実世界の不確実性(明確な単一解答が存在しない問題)を自然に許容する。第三に自己検証機能を備え、外部モデルが不要となる。
他のシステムが生成器と検証器を分離させるのとは異なり、EBMは両者を単一の統合モデルに組み込む。この構成の主な利点は汎化能力の向上である。分布外(OOD)データにおける解の検証は、通常、正しい答えを生成するよりも容易であるため、EBMは見慣れない状況をより適切に処理できる。
その可能性にもかかわらず、EBMは歴史的にスケーラビリティの問題に直面してきた。この課題に対処するため、研究者らはEBTを導入した。EBTはこのフレームワーク向けに設計された特化型トランスフォーマーモデルである。EBTはまずコンテキストと予測の適合性を確認し、その後、最低エネルギー(最も適合性の高い)出力を特定するまで予測を精緻化するよう訓練される。この手順は、各予測に対する思考プロセスを効果的に模倣する。 チームは2種類のEBTバリエーションを開発した:GPTアーキテクチャに着想を得たデコーダ専用モデルと、BERTに類似した双方向モデルである。
EBTのアーキテクチャは、様々な推論時スケーリング手法への適応性と互換性を備えています。「EBTはより長いCoTを生成でき、自己検証が可能で、ベストオブNを実現できる[あるいは]多数のEBTからサンプリングすることも可能です」と、イリノイ大学アーバナ・シャンペーン校のコンピュータサイエンス博士課程学生であり本論文の筆頭著者であるアレクシー・グラッドストーンはVentureBeatに語りました。 「最も優れた点は、これらの機能が全て事前学習中に習得されることです」
EBTの実践
研究者らはEBTを既存アーキテクチャと比較検証した:テキスト生成(離散モダリティ)向けの高性能トランスフォーマー++手法と、動画予測や画像ノイズ除去(連続モダリティ)向け拡散トランスフォーマー(DiT)である。評価基準は主に2点:「学習スケーラビリティ」(効率的なトレーニング能力)と「推論スケーラビリティ」(推論時の計算量増加に伴う性能向上度)である。
事前学習段階において、EBTはデータ量・バッチサイズ・パラメータ数・計算リソースのあらゆる条件でTransformer++を最大35%上回るスケーリング率を達成し、優れた効率性を示した。これはEBTがより高速かつ低コストで学習可能であることを意味する。
推論段階では、推論タスクにおいてEBTが既存モデルを凌駕した。「より長く思考する」(最適化ステップを増やす)ことと「自己検証」(複数の候補を生成しエネルギーが最も低いものを選択する)を行うことで、EBTはTransformer++より29%高い言語モデリング性能を達成した。 「これは我々の主張と一致する。従来のフィードフォワード型トランスフォーマーは、各予測に対して動的に追加計算を割り当てられないため、より長く考えることでトークンごとの性能を向上させられない」と研究者らは説明する。
画像ノイズ除去では、EBTはDiTよりも優れた結果を出しながら、フォワードパスを99%削減した。
重要な点として、本研究ではEBTが他のアーキテクチャよりも効果的に汎化することが明らかになった。事前学習性能が同等または劣る場合でも、EBTは下流タスクにおいて既存モデルを上回った。システム2思考による性能向上は、訓練データとは異なる分布外データで最も顕著であり、EBTが新規かつ困難な課題に直面した際に特に頑健であることを示している。
研究者らは「EBTの思考効果は全データで均一ではなく、分布の偏りの大きさに比例して顕著に現れる。これは思考が、訓練分布を超えた頑健な一般化を実現する重要なメカニズムであることを強調している」と指摘している。
EBTの優位性は主に2つの理由から重要である。 第一に、今日の基盤モデルの巨大スケールにおいて、EBTはLLMで用いられる古典的なトランスフォーマーアーキテクチャを大幅に上回る可能性を示唆している。著者らは「1000倍の規模で1000倍のデータを学習した現代の基盤モデルでは、EBTの事前学習性能がTransformer++手法を大幅に上回ると予想される」と述べている。
第二に、EBTははるかに高いデータ効率を示す。これは、高品質なトレーニングデータがAIのスケールアップにおける主要なボトルネックとなりつつある時代にあって決定的な利点である。「データの不足がさらなるスケールアップの主要な制約要因となっている現状において、EBTは特に魅力的である」と論文は述べている。
推論メカニズムが異なるにもかかわらず、EBTアーキテクチャはトランスフォーマーと高い互換性を持ち、現行のLLMのドロップイン置換として機能する。
グラッドストーン氏は「EBTは現行のハードウェア/推論フレームワークと極めて互換性が高い」と述べ、GPUやTPU上でのフィードフォワードモデルを用いた推測的デコーディングを含めると説明。さらに、LPUなどの専用アクセラレータやFlashAttention-3のような最適化アルゴリズムでの実行、あるいはvLLMなどの汎用推論フレームワークを通じた展開が可能だと確信していると付け加えた。
開発者や企業にとって、EBTの強力な推論能力と汎化能力は次世代AIアプリケーション構築の堅牢な基盤となり得る。「思考の持続時間はほぼ全ての企業アプリケーションに広く貢献するが、特に重要な意思決定を要する分野、安全関連、データが限られたアプリケーションで真価を発揮するだろう」とグラッドストーンは語った。








 Base44、独自開発のAIモデルを公開し、Vibeコーディングプラットフォームの防御力を強化
Base44は、わずか1年前にWixによって8,000万ドルで買収された「バイブコーディング」プラットフォームであり、当時チーム8名、設立からわずか6ヶ月という若さであったが、自然言語を用いてアプリケーションを構築するユーザーを支援するため、独自のAIモデルの提供を開始した。この展開は、最先端モデルがすべてのユースケースにおいて最適かどうか、そして外部モデルに依存する企業が長期的な防衛性を維持できるかどうかをめぐってAIコミュニティが議論している時期に到来した。ベイエリアを拠点とするBase4
 バイエル、Iambic AIを活用して創薬プロセスを加速
ユルゲン・エックハルト医学博士は、バイエル・ファーマシューティカルズで事業開発・ライセンス担当責任者を務めています。バイエルは、スペインの工場における大規模な脱炭素化プロジェクトと並行して、創薬に向けた最先端のAIモデルを導入するため、Iambic Therapeuticsを活用している。バイエルは、低分子化合物の創薬および新薬開発を加速させるため、科学技術企業であるIambic Therapeu
 マルチバース・コンピューティング、無料圧縮生成AIモデルを発表
大規模言語モデルは重大な課題に直面している:その膨大なサイズである。スペインのスタートアップMultiverse Computingは、最先端AIの能力と企業が実用的に導入できる範囲とのギャップを埋めるべく設計された圧縮モデルを開発することでこの問題に取り組んでいる。同社の革新的な技術「CompactifAI」は量子コンピューティング原理に着想を得た圧縮技術であり、バスク地方のこの企業はOpenA

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai












