


 Hogar
La IA basada en la optimización surge como una nueva vía hacia los modelos de uso general
Investigadores de la Universidad de Illinois Urbana-Champaign y la Universidad de Virginia han creado una nueva arquitectura de modelo que podría allanar el camino para sistemas de IA más resilientes con una mayor capacidad de razonamiento.
Denominada «transformador basado en energía» (EBT), esta arquitectura aprovecha de forma natural el escalado del tiempo de inferencia para abordar retos complejos. Para las empresas, esto se traduce en aplicaciones de IA rentables que pueden adaptarse a nuevos escenarios sin necesidad de modelos especializados y ajustados.
El reto del pensamiento del sistema 2
En psicología, la cognición humana se divide normalmente en dos modos: el sistema 1, que es rápido e instintivo, y el sistema 2, que es más lento, más deliberado y analítico. Los grandes modelos de lenguaje (LLM) actuales son excelentes en las tareas del sistema 1, pero el campo de la IA se está concentrando ahora en desarrollar el pensamiento del sistema 2 para manejar problemas de razonamiento más complejos.
Los modelos de razonamiento emplean varios métodos de escalado del tiempo de inferencia para mejorar su rendimiento en preguntas difíciles. Una técnica común es el aprendizaje por refuerzo (RL), utilizado en modelos como DeepSeek-R1 y la «serie o» de OpenAI, en los que la IA obtiene recompensas por generar tokens de razonamiento hasta llegar a la solución correcta. Otra estrategia, a menudo denominada «best-of-n», consiste en crear varias respuestas posibles y utilizar un sistema de verificación para elegir la mejor.
Sin embargo, estos enfoques tienen limitaciones notables. Por lo general, se limitan a un conjunto reducido de problemas fácilmente verificables, como las matemáticas y la codificación, y pueden reducir el rendimiento en otras tareas, como la escritura creativa. Además, estudios recientes indican que los métodos basados en RL podrían no estar enseñando a los modelos nuevas habilidades de razonamiento, sino simplemente animándolos a reutilizar patrones de razonamiento exitosos que ya conocen. Esto limita su capacidad para resolver problemas que exigen una exploración genuina más allá de su ámbito de formación.
Modelos basados en la energía (EBM)
Esta nueva arquitectura toma un camino diferente, basándose en una clase de modelos conocidos como modelos basados en la energía (EBM). El concepto central es sencillo: en lugar de generar una respuesta directamente, el modelo aprende una «función de energía» que sirve como verificador. Esta función toma una entrada (como una indicación) y una predicción candidata, y luego le asigna un valor, o «energía». Una puntuación de energía baja sugiere una alta compatibilidad, lo que significa que la predicción se ajusta bien a la entrada, mientras que una puntuación de energía alta indica una mala coincidencia.
Aplicando esto al razonamiento de la IA, los investigadores proponen en un artículo que los desarrolladores deberían considerar «el pensamiento como un procedimiento de optimización con respecto a un verificador aprendido, que evalúa la compatibilidad (probabilidad no normalizada) entre una entrada y la predicción candidata». El proceso comienza con una predicción aleatoria, que luego se refina gradualmente minimizando su puntuación de energía y explorando posibles soluciones hasta que converge en una respuesta altamente compatible. Este método se basa en la idea de que verificar una solución suele ser mucho más sencillo que generar una desde cero.
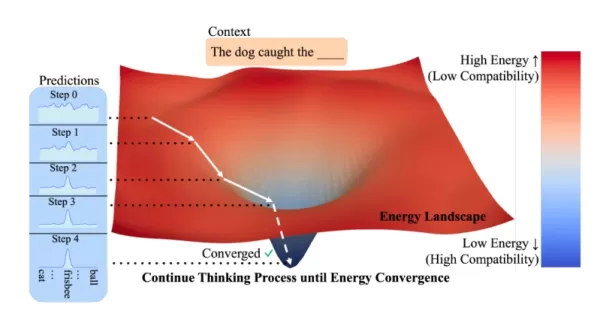
Este diseño «centrado en el verificador» aborda tres retos importantes en el razonamiento de la IA. En primer lugar, permite una asignación dinámica de recursos computacionales, lo que permite a los modelos «pensar» más tiempo en los problemas difíciles y menos en los más fáciles. En segundo lugar, los EBM se adaptan de forma natural a la incertidumbre de los problemas del mundo real, en los que no existe una única respuesta clara. En tercer lugar, funcionan como sus propios verificadores, lo que elimina la necesidad de modelos externos.
A diferencia de otros sistemas que emplean generadores y verificadores separados, los EBM integran ambos en un único modelo unificado. Una ventaja importante de esta configuración es la mejora de la generalización. Dado que verificar una solución en datos nuevos fuera de distribución (OOD) suele ser más fácil que generar una respuesta correcta, los EBM pueden gestionar mejor situaciones desconocidas.
A pesar de su potencial, los EBM se han enfrentado históricamente a problemas de escalabilidad. Para solucionarlo, los investigadores introdujeron los EBT, que son modelos transformadores especializados diseñados para este marco. Los EBT están entrenados para comprobar primero la compatibilidad entre un contexto y una predicción, y luego refinar las predicciones hasta identificar la salida de menor energía (más compatible). Este procedimiento imita eficazmente un proceso de pensamiento para cada predicción. El equipo creó dos variantes de EBT: un modelo solo decodificador inspirado en la arquitectura GPT y un modelo bidireccional similar a BERT.
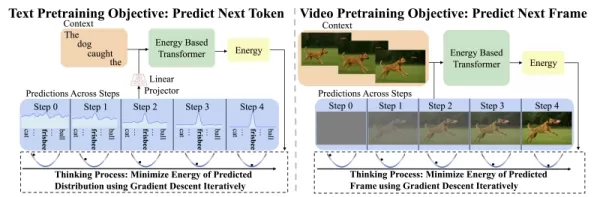
Transformador basado en energía (fuente: GitHub) La arquitectura de los EBT los hace adaptables y compatibles con varios métodos de escalado en tiempo de inferencia. «Los EBT pueden generar CoT más largos, autoverificarse, hacer lo mejor de N [o] se puede tomar una muestra de muchos EBT», explicó Alexi Gladstone, estudiante de doctorado en informática en la Universidad de Illinois Urbana-Champaign y autor principal del artículo, a VentureBeat. «Lo mejor es que todas estas capacidades se aprenden durante el preentrenamiento».
EBT en acción
Los investigadores probaron los EBT frente a arquitecturas establecidas: la popular receta transformer++ para la generación de texto (modalidades discretas) y el transformador de difusión (DiT) para tareas como la predicción de vídeo y la eliminación de ruido en imágenes (modalidades continuas). Evaluaron los modelos basándose en dos criterios principales: la «escalabilidad del aprendizaje», o la eficiencia con la que se entrenan, y la «escalabilidad del pensamiento», que mide cómo mejora el rendimiento con más computación durante la inferencia.
Durante el preentrenamiento, los EBT mostraron una eficiencia superior, alcanzando una tasa de escalado hasta un 35 % mayor que Transformer++ en datos, tamaño de lote, parámetros y computación. Esto significa que los EBT se pueden entrenar más rápido y de forma más asequible.
En la inferencia, los EBT también superaron a los modelos existentes en tareas de razonamiento. Al «pensar más tiempo» (utilizando más pasos de optimización) y realizar una «autoverificación» (generando múltiples candidatos y seleccionando el que tiene la energía más baja), los EBT mejoraron el rendimiento del modelado del lenguaje en un 29 % más que Transformer++. «Esto concuerda con nuestra afirmación de que, dado que los transformadores feed-forward tradicionales no pueden asignar dinámicamente computación adicional para cada predicción que se realiza, no pueden mejorar el rendimiento de cada token pensando durante más tiempo», explican los investigadores.
En cuanto a la eliminación de ruido en imágenes, los EBT obtuvieron mejores resultados que los DiT utilizando un 99 % menos de pasadas hacia adelante.
Es importante destacar que el estudio reveló que los EBT generalizan de forma más eficaz que otras arquitecturas. Incluso con un rendimiento de preentrenamiento igual o inferior, los EBT superaron a los modelos existentes en tareas posteriores. Las mejoras de rendimiento del pensamiento del Sistema 2 fueron más pronunciadas en los datos que se encontraban más fuera de la distribución (a diferencia de los datos de entrenamiento), lo que indica que los EBT son especialmente robustos cuando se enfrentan a retos nuevos y difíciles.
Los investigadores señalan que «las ventajas del pensamiento de los EBT no son uniformes en todos los datos, sino que aumentan positivamente con la magnitud de los cambios de distribución, lo que destaca el pensamiento como un mecanismo crítico para una generalización robusta más allá de las distribuciones de entrenamiento».
Las ventajas de los EBT son significativas por dos razones clave. En primer lugar, sugieren que, a la escala masiva de los modelos básicos actuales, los EBT podrían superar sustancialmente a la arquitectura clásica de transformadores utilizada en los LLM. Los autores observan que «a la escala de los modelos básicos modernos entrenados con 1000 veces más datos y con modelos 1000 veces más grandes, esperamos que el rendimiento de preentrenamiento de los EBT sea significativamente mejor que el de la receta Transformer++».
En segundo lugar, los EBT demuestran una eficiencia de datos mucho mayor. Esta es una ventaja crucial en una era en la que los datos de entrenamiento de alta calidad son cada vez más un importante cuello de botella para la ampliación de la IA. «Dado que los datos se han convertido en uno de los principales factores limitantes para una mayor ampliación, esto hace que los EBT sean especialmente atractivos», afirma el artículo.
A pesar de su diferente mecanismo de inferencia, la arquitectura EBT es altamente compatible con el transformador, lo que le permite servir como sustituto directo de los LLM actuales.
«Los EBT son muy compatibles con los marcos de hardware/inferencia actuales», afirma Gladstone, incluida la decodificación especulativa mediante modelos feed-forward tanto en GPU como en TPU. Añade que confía en que puedan ejecutarse en aceleradores especializados, como LPU y algoritmos de optimización como FlashAttention-3, o que puedan implementarse a través de marcos de inferencia comunes, como vLLM.
Para los desarrolladores y las empresas, las sólidas capacidades de razonamiento y generalización de los EBT podrían convertirlos en una base potente y fiable para crear la próxima generación de aplicaciones de IA. «Pensar a más largo plazo puede ser de gran ayuda en casi todas las aplicaciones empresariales, pero creo que las más interesantes serán aquellas que requieran decisiones más importantes, seguridad o aplicaciones con datos limitados», afirmó Gladstone.
Artículo relacionado
 Base44 desvela su modelo de IA propietario para reforzar la defensabilidad en su plataforma de programación por vibración
Base44, la plataforma de codificación por estilo (vibe coding) adquirida por Wix por 80 millones de dólares hace apenas un año —cuando contaba con solo seis meses de antigüedad y un equipo de ocho personas—, ha comenzado a implementar su modelo de in
Bayer aprovecha la IA de Iambic para acelerar el descubrimiento de fármacos
El Dr. Juergen Eckhardt ocupa el cargo de director de Desarrollo Empresarial y Licencias en Bayer Pharmaceuticals.Bayer está aprovechando la tecnología de Iambic Therapeutics para implementar modelos
Multiverse Computing lanza un modelo generativo de IA comprimido gratuito
Los modelos lingüísticos de gran tamaño se enfrentan a un reto importante: su inmenso tamaño. La startup española Multiverse Computing está abordando este problema mediante la creación de modelos comp
Recomendaciones de temas especiales relacionados
Negocio
 Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
 9 herramientas
 xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai
Educación y aprendizaje
Plataformas de construcción de cuestionarios con IA para profesores, tutores y programas de aprendizaje basados en cohortes
2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai
código
Herramientas de revisión de pull requests basadas en IA para equipos de GitHub que se ocupan de refactorizaciones, errores y fallos de seguridad
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 para la revisión de pull requests con IA para equipos de GitHub! Esta lista seleccionada y mejor valorada presenta potentes soluciones revolucionarias que agilizan la refactorización, la corrección de errores y la detección de brechas de seguridad en todos los flujos de trabajo de los equipos. Disfruta de una comparación entre opciones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la herramienta perfecta para aumentar significativamente tu productividad. ¡Explora ahora mismo y descubre tu ventaja con la IA!
12 herramientas
xix.ai
Texto a voz
Las mejores herramientas de conversión de texto a voz basadas en IA para locuciones naturales
¡Las mejores herramientas de 2026 de conversión de texto a voz con IA, con las mejores valoraciones para locuciones naturales, ya están aquí, en XIX.AI! Esta lista seleccionada incluye opciones potentes y revolucionarias que ofrecen voces nítidas para cualquier caso de uso, respaldadas por pruebas en el mundo real y clasificaciones que se actualizan semanalmente. Consigue una comparación entre las versiones gratuitas y de pago para encontrar la solución imprescindible que impulse tu productividad al instante. ¡Explora ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai

 comentario (0)
0/500
Investigadores de la Universidad de Illinois Urbana-Champaign y la Universidad de Virginia han creado una nueva arquitectura de modelo que podría allanar el camino para sistemas de IA más resilientes con una mayor capacidad de razonamiento.
Denominada «transformador basado en energía» (EBT), esta arquitectura aprovecha de forma natural el escalado del tiempo de inferencia para abordar retos complejos. Para las empresas, esto se traduce en aplicaciones de IA rentables que pueden adaptarse a nuevos escenarios sin necesidad de modelos especializados y ajustados.
El reto del pensamiento del sistema 2
En psicología, la cognición humana se divide normalmente en dos modos: el sistema 1, que es rápido e instintivo, y el sistema 2, que es más lento, más deliberado y analítico. Los grandes modelos de lenguaje (LLM) actuales son excelentes en las tareas del sistema 1, pero el campo de la IA se está concentrando ahora en desarrollar el pensamiento del sistema 2 para manejar problemas de razonamiento más complejos.
Los modelos de razonamiento emplean varios métodos de escalado del tiempo de inferencia para mejorar su rendimiento en preguntas difíciles. Una técnica común es el aprendizaje por refuerzo (RL), utilizado en modelos como DeepSeek-R1 y la «serie o» de OpenAI, en los que la IA obtiene recompensas por generar tokens de razonamiento hasta llegar a la solución correcta. Otra estrategia, a menudo denominada «best-of-n», consiste en crear varias respuestas posibles y utilizar un sistema de verificación para elegir la mejor.
Sin embargo, estos enfoques tienen limitaciones notables. Por lo general, se limitan a un conjunto reducido de problemas fácilmente verificables, como las matemáticas y la codificación, y pueden reducir el rendimiento en otras tareas, como la escritura creativa. Además, estudios recientes indican que los métodos basados en RL podrían no estar enseñando a los modelos nuevas habilidades de razonamiento, sino simplemente animándolos a reutilizar patrones de razonamiento exitosos que ya conocen. Esto limita su capacidad para resolver problemas que exigen una exploración genuina más allá de su ámbito de formación.
Modelos basados en la energía (EBM)
Esta nueva arquitectura toma un camino diferente, basándose en una clase de modelos conocidos como modelos basados en la energía (EBM). El concepto central es sencillo: en lugar de generar una respuesta directamente, el modelo aprende una «función de energía» que sirve como verificador. Esta función toma una entrada (como una indicación) y una predicción candidata, y luego le asigna un valor, o «energía». Una puntuación de energía baja sugiere una alta compatibilidad, lo que significa que la predicción se ajusta bien a la entrada, mientras que una puntuación de energía alta indica una mala coincidencia.
Aplicando esto al razonamiento de la IA, los investigadores proponen en un artículo que los desarrolladores deberían considerar «el pensamiento como un procedimiento de optimización con respecto a un verificador aprendido, que evalúa la compatibilidad (probabilidad no normalizada) entre una entrada y la predicción candidata». El proceso comienza con una predicción aleatoria, que luego se refina gradualmente minimizando su puntuación de energía y explorando posibles soluciones hasta que converge en una respuesta altamente compatible. Este método se basa en la idea de que verificar una solución suele ser mucho más sencillo que generar una desde cero.
Este diseño «centrado en el verificador» aborda tres retos importantes en el razonamiento de la IA. En primer lugar, permite una asignación dinámica de recursos computacionales, lo que permite a los modelos «pensar» más tiempo en los problemas difíciles y menos en los más fáciles. En segundo lugar, los EBM se adaptan de forma natural a la incertidumbre de los problemas del mundo real, en los que no existe una única respuesta clara. En tercer lugar, funcionan como sus propios verificadores, lo que elimina la necesidad de modelos externos.
A diferencia de otros sistemas que emplean generadores y verificadores separados, los EBM integran ambos en un único modelo unificado. Una ventaja importante de esta configuración es la mejora de la generalización. Dado que verificar una solución en datos nuevos fuera de distribución (OOD) suele ser más fácil que generar una respuesta correcta, los EBM pueden gestionar mejor situaciones desconocidas.
A pesar de su potencial, los EBM se han enfrentado históricamente a problemas de escalabilidad. Para solucionarlo, los investigadores introdujeron los EBT, que son modelos transformadores especializados diseñados para este marco. Los EBT están entrenados para comprobar primero la compatibilidad entre un contexto y una predicción, y luego refinar las predicciones hasta identificar la salida de menor energía (más compatible). Este procedimiento imita eficazmente un proceso de pensamiento para cada predicción. El equipo creó dos variantes de EBT: un modelo solo decodificador inspirado en la arquitectura GPT y un modelo bidireccional similar a BERT.
La arquitectura de los EBT los hace adaptables y compatibles con varios métodos de escalado en tiempo de inferencia. «Los EBT pueden generar CoT más largos, autoverificarse, hacer lo mejor de N [o] se puede tomar una muestra de muchos EBT», explicó Alexi Gladstone, estudiante de doctorado en informática en la Universidad de Illinois Urbana-Champaign y autor principal del artículo, a VentureBeat. «Lo mejor es que todas estas capacidades se aprenden durante el preentrenamiento».
EBT en acción
Los investigadores probaron los EBT frente a arquitecturas establecidas: la popular receta transformer++ para la generación de texto (modalidades discretas) y el transformador de difusión (DiT) para tareas como la predicción de vídeo y la eliminación de ruido en imágenes (modalidades continuas). Evaluaron los modelos basándose en dos criterios principales: la «escalabilidad del aprendizaje», o la eficiencia con la que se entrenan, y la «escalabilidad del pensamiento», que mide cómo mejora el rendimiento con más computación durante la inferencia.
Durante el preentrenamiento, los EBT mostraron una eficiencia superior, alcanzando una tasa de escalado hasta un 35 % mayor que Transformer++ en datos, tamaño de lote, parámetros y computación. Esto significa que los EBT se pueden entrenar más rápido y de forma más asequible.
En la inferencia, los EBT también superaron a los modelos existentes en tareas de razonamiento. Al «pensar más tiempo» (utilizando más pasos de optimización) y realizar una «autoverificación» (generando múltiples candidatos y seleccionando el que tiene la energía más baja), los EBT mejoraron el rendimiento del modelado del lenguaje en un 29 % más que Transformer++. «Esto concuerda con nuestra afirmación de que, dado que los transformadores feed-forward tradicionales no pueden asignar dinámicamente computación adicional para cada predicción que se realiza, no pueden mejorar el rendimiento de cada token pensando durante más tiempo», explican los investigadores.
En cuanto a la eliminación de ruido en imágenes, los EBT obtuvieron mejores resultados que los DiT utilizando un 99 % menos de pasadas hacia adelante.
Es importante destacar que el estudio reveló que los EBT generalizan de forma más eficaz que otras arquitecturas. Incluso con un rendimiento de preentrenamiento igual o inferior, los EBT superaron a los modelos existentes en tareas posteriores. Las mejoras de rendimiento del pensamiento del Sistema 2 fueron más pronunciadas en los datos que se encontraban más fuera de la distribución (a diferencia de los datos de entrenamiento), lo que indica que los EBT son especialmente robustos cuando se enfrentan a retos nuevos y difíciles.
Los investigadores señalan que «las ventajas del pensamiento de los EBT no son uniformes en todos los datos, sino que aumentan positivamente con la magnitud de los cambios de distribución, lo que destaca el pensamiento como un mecanismo crítico para una generalización robusta más allá de las distribuciones de entrenamiento».
Las ventajas de los EBT son significativas por dos razones clave. En primer lugar, sugieren que, a la escala masiva de los modelos básicos actuales, los EBT podrían superar sustancialmente a la arquitectura clásica de transformadores utilizada en los LLM. Los autores observan que «a la escala de los modelos básicos modernos entrenados con 1000 veces más datos y con modelos 1000 veces más grandes, esperamos que el rendimiento de preentrenamiento de los EBT sea significativamente mejor que el de la receta Transformer++».
En segundo lugar, los EBT demuestran una eficiencia de datos mucho mayor. Esta es una ventaja crucial en una era en la que los datos de entrenamiento de alta calidad son cada vez más un importante cuello de botella para la ampliación de la IA. «Dado que los datos se han convertido en uno de los principales factores limitantes para una mayor ampliación, esto hace que los EBT sean especialmente atractivos», afirma el artículo.
A pesar de su diferente mecanismo de inferencia, la arquitectura EBT es altamente compatible con el transformador, lo que le permite servir como sustituto directo de los LLM actuales.
«Los EBT son muy compatibles con los marcos de hardware/inferencia actuales», afirma Gladstone, incluida la decodificación especulativa mediante modelos feed-forward tanto en GPU como en TPU. Añade que confía en que puedan ejecutarse en aceleradores especializados, como LPU y algoritmos de optimización como FlashAttention-3, o que puedan implementarse a través de marcos de inferencia comunes, como vLLM.
Para los desarrolladores y las empresas, las sólidas capacidades de razonamiento y generalización de los EBT podrían convertirlos en una base potente y fiable para crear la próxima generación de aplicaciones de IA. «Pensar a más largo plazo puede ser de gran ayuda en casi todas las aplicaciones empresariales, pero creo que las más interesantes serán aquellas que requieran decisiones más importantes, seguridad o aplicaciones con datos limitados», afirmó Gladstone.








 Base44 desvela su modelo de IA propietario para reforzar la defensabilidad en su plataforma de programación por vibración
Base44, la plataforma de codificación por estilo (vibe coding) adquirida por Wix por 80 millones de dólares hace apenas un año —cuando contaba con solo seis meses de antigüedad y un equipo de ocho personas—, ha comenzado a implementar su modelo de in
 Bayer aprovecha la IA de Iambic para acelerar el descubrimiento de fármacos
El Dr. Juergen Eckhardt ocupa el cargo de director de Desarrollo Empresarial y Licencias en Bayer Pharmaceuticals.Bayer está aprovechando la tecnología de Iambic Therapeutics para implementar modelos
 Multiverse Computing lanza un modelo generativo de IA comprimido gratuito
Los modelos lingüísticos de gran tamaño se enfrentan a un reto importante: su inmenso tamaño. La startup española Multiverse Computing está abordando este problema mediante la creación de modelos comp

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 para la revisión de pull requests con IA para equipos de GitHub! Esta lista seleccionada y mejor valorada presenta potentes soluciones revolucionarias que agilizan la refactorización, la corrección de errores y la detección de brechas de seguridad en todos los flujos de trabajo de los equipos. Disfruta de una comparación entre opciones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la herramienta perfecta para aumentar significativamente tu productividad. ¡Explora ahora mismo y descubre tu ventaja con la IA!
12 herramientas
xix.ai

¡Las mejores herramientas de 2026 de conversión de texto a voz con IA, con las mejores valoraciones para locuciones naturales, ya están aquí, en XIX.AI! Esta lista seleccionada incluye opciones potentes y revolucionarias que ofrecen voces nítidas para cualquier caso de uso, respaldadas por pruebas en el mundo real y clasificaciones que se actualizan semanalmente. Consigue una comparación entre las versiones gratuitas y de pago para encontrar la solución imprescindible que impulse tu productividad al instante. ¡Explora ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai












