


 Heim
Optimierungsorientierte KI als neuer Weg zu Allzweckmodellen
Forscher der University of Illinois Urbana-Champaign und der University of Virginia haben eine neue Modellarchitektur entwickelt, die den Weg für widerstandsfähigere KI-Systeme mit verbesserter Schlussfolgerungsfähigkeit ebnen könnte.
Diese Architektur mit dem Namen „Energy-Based Transformer“ (EBT) nutzt auf natürliche Weise die Skalierung der Inferenzzeit, um komplexe Herausforderungen zu bewältigen. Für Unternehmen bedeutet dies kosteneffiziente KI-Anwendungen, die sich an neue Szenarien anpassen können, ohne dass spezielle, fein abgestimmte Modelle erforderlich sind.
Die Herausforderung des System-2-Denkens
In der Psychologie wird die menschliche Kognition in der Regel in zwei Modi unterteilt: System 1, das schnell und instinktiv ist, und System 2, das langsamer, überlegter und analytischer ist. Die heutigen großen Sprachmodelle (LLMs) sind hervorragend für System-1-Aufgaben geeignet, aber der KI-Bereich konzentriert sich derzeit auf die Entwicklung des System-2-Denkens, um komplexere Denkaufgaben zu bewältigen.
Argumentationsmodelle verwenden verschiedene Skalierungsmethoden zur Inferenzzeit, um ihre Leistung bei schwierigen Fragen zu steigern. Eine gängige Technik ist das Reinforcement Learning (RL), das in Modellen wie DeepSeek-R1 und OpenAI's „o-series” verwendet wird, bei denen die KI Belohnungen für die Generierung von Argumentationstoken erhält, bis sie die richtige Lösung findet. Eine andere Strategie, die oft als „Best-of-n” bezeichnet wird, besteht darin, mehrere mögliche Antworten zu erstellen und mithilfe eines Verifizierungssystems die beste auszuwählen.
Diese Ansätze weisen jedoch erhebliche Einschränkungen auf. Sie beschränken sich in der Regel auf eine kleine Gruppe leicht überprüfbarer Probleme, wie Mathematik und Programmierung, und können die Leistung bei anderen Aufgaben, wie z. B. kreativem Schreiben, beeinträchtigen. Darüber hinaus deuten aktuelle Studien darauf hin, dass RL-basierte Methoden den Modellen möglicherweise keine neuen Denkfähigkeiten vermitteln, sondern sie lediglich dazu ermutigen, bereits bekannte erfolgreiche Denkmuster wiederzuverwenden. Dies schränkt ihre Fähigkeit ein, Probleme zu lösen, die eine echte Erforschung außerhalb ihres Trainingsumfangs erfordern.
Energiebasierte Modelle (EBM)
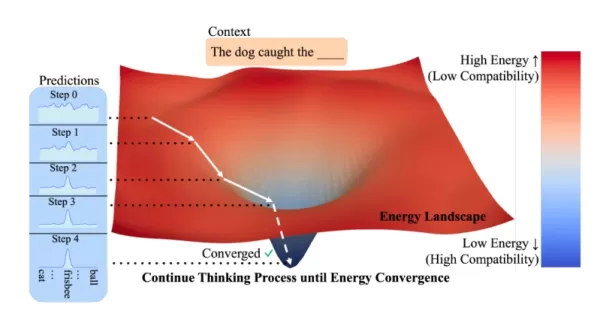
Diese neue Architektur verfolgt einen anderen Ansatz und baut auf einer Klasse von Modellen auf, die als energiebasierte Modelle (EBMs) bekannt sind. Das zentrale Konzept ist einfach: Anstatt direkt eine Antwort zu generieren, lernt das Modell eine „Energiefunktion”, die als Verifizierer dient. Diese Funktion nimmt eine Eingabe (z. B. eine Eingabeaufforderung) und eine mögliche Vorhersage entgegen und weist ihr dann einen Wert oder eine „Energie” zu. Ein niedriger Energiewert deutet auf eine hohe Kompatibilität hin, was bedeutet, dass die Vorhersage gut zur Eingabe passt, während ein hoher Energiewert auf eine schlechte Übereinstimmung hinweist.
In Anwendung auf das KI-Denkvermögen schlagen die Forscher in einem Artikel vor, dass Entwickler „das Denken als einen Optimierungsprozess in Bezug auf einen gelernten Verifizierer betrachten sollten, der die Kompatibilität (nicht normalisierte Wahrscheinlichkeit) zwischen einer Eingabe und einer Kandidatenvorhersage bewertet”. Der Prozess beginnt mit einer zufälligen Vorhersage, die dann schrittweise verfeinert wird, indem ihr Energiewert minimiert und mögliche Lösungen untersucht werden, bis sie zu einer hochkompatiblen Antwort konvergiert. Diese Methode basiert auf der Idee, dass die Überprüfung einer Lösung oft viel einfacher ist als die Generierung einer Lösung von Grund auf.
Dieses „verifiziererzentrierte“ Design bewältigt drei große Herausforderungen beim KI-Schlussfolgern. Erstens ermöglicht es eine dynamische Zuweisung von Rechenleistung, sodass Modelle länger über schwierige Probleme und weniger über einfachere Probleme „nachdenken“ können. Zweitens berücksichtigen EBMs auf natürliche Weise die Unsicherheit realer Probleme, für die es keine eindeutige Antwort gibt. Drittens fungieren sie als ihre eigenen Verifizierer, sodass keine externen Modelle erforderlich sind.
Im Gegensatz zu anderen Systemen, die separate Generatoren und Verifizierer verwenden, integrieren EBMs beide in ein einziges, einheitliches Modell. Ein großer Vorteil dieser Konfiguration ist die verbesserte Generalisierung. Da die Verifizierung einer Lösung anhand neuer, außerhalb der Verteilung liegender Daten (OOD) in der Regel einfacher ist als die Generierung einer richtigen Antwort, können EBMs unbekannte Situationen besser bewältigen.
Trotz ihres Potenzials hatten EBMs in der Vergangenheit mit Skalierbarkeitsproblemen zu kämpfen. Um dieses Problem zu lösen, führten die Forscher EBTs ein, bei denen es sich um spezielle Transformer-Modelle handelt, die für dieses Framework entwickelt wurden. EBTs werden so trainiert, dass sie zunächst die Kompatibilität zwischen einem Kontext und einer Vorhersage überprüfen und dann die Vorhersagen verfeinern, bis sie die Ausgabe mit der geringsten Energie (der höchsten Kompatibilität) identifizieren. Dieses Verfahren ahmt effektiv einen Denkprozess für jede Vorhersage nach. Das Team entwickelte zwei EBT-Varianten: ein nur aus einem Decoder bestehendes Modell, das von der GPT-Architektur inspiriert ist, und ein bidirektionales Modell, das BERT ähnelt.
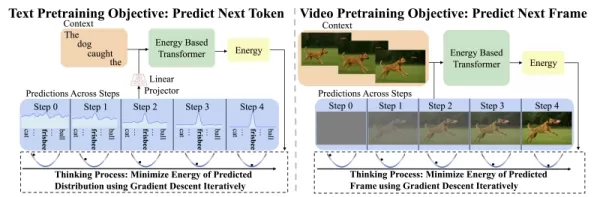
Energiebasierter Transformator (Quelle: GitHub) Die Architektur von EBTs macht sie anpassungsfähig und kompatibel mit verschiedenen Skalierungsmethoden für die Inferenzzeit. „EBTs können längere CoTs generieren, sich selbst überprüfen, Best-of-N durchführen [oder] Sie können aus vielen EBTs auswählen“, erklärte Alexi Gladstone, Doktorand der Informatik an der University of Illinois Urbana-Champaign und Hauptautor der Studie, gegenüber VentureBeat. „Das Beste daran ist, dass all diese Fähigkeiten während des Vortrainings erlernt werden.“
EBTs in Aktion
Die Forscher testeten EBTs im Vergleich zu etablierten Architekturen: dem beliebten Transformer++-Rezept für die Textgenerierung (diskrete Modalitäten) und dem Diffusion Transformer (DiT) für Aufgaben wie Videovorhersage und Bildrauschunterdrückung (kontinuierliche Modalitäten). Sie bewerteten die Modelle anhand von zwei Hauptkriterien: „Lernskalierbarkeit“ oder wie effizient sie trainieren, und „Denkbarkeit“, die misst, wie sich die Leistung mit mehr Rechenleistung während der Inferenz verbessert.
Während des Vortrainings zeigten EBTs eine überlegene Effizienz und erreichten eine um bis zu 35 % höhere Skalierungsrate als Transformer++ über Daten, Batchgröße, Parameter und Rechenleistung hinweg. Das bedeutet, dass EBTs schneller und kostengünstiger trainiert werden können.
Bei der Inferenz übertrafen EBTs auch bestehende Modelle bei Denkaufgaben. Durch „längeres Denken“ (unter Verwendung von mehr Optimierungsschritten) und „Selbstverifizierung“ (Generierung mehrerer Kandidaten und Auswahl des Kandidaten mit der geringsten Energie) verbesserten EBTs die Sprachmodellierungsleistung um 29 % gegenüber Transformer++. „Dies steht im Einklang mit unserer Behauptung, dass herkömmliche Feed-Forward-Transformer nicht in der Lage sind, zusätzliche Rechenleistung für jede Vorhersage dynamisch zuzuweisen, und daher die Leistung für jedes Token nicht durch längeres Nachdenken verbessern können”, erklären die Forscher.
Bei der Bildrauschunterdrückung lieferten EBTs bessere Ergebnisse als DiTs, während sie 99 % weniger Vorwärtsdurchläufe benötigten.
Wichtig ist, dass die Studie ergab, dass EBTs effektiver generalisieren als andere Architekturen. Selbst bei gleicher oder schwächerer Vorab-Trainingsleistung übertrafen EBTs bestehende Modelle bei nachgelagerten Aufgaben. Die Leistungssteigerungen durch System-2-Denken waren bei Daten, die weiter außerhalb der Verteilung lagen (im Gegensatz zu den Trainingsdaten), am ausgeprägtesten, was darauf hindeutet, dass EBTs besonders robust sind, wenn sie mit neuen und schwierigen Herausforderungen konfrontiert werden.
Die Forscher stellen fest, dass „die Vorteile des Denkens von EBTs nicht für alle Daten gleich sind, sondern mit dem Ausmaß der Verteilungsverschiebungen positiv skalieren, was das Denken als einen kritischen Mechanismus für eine robuste Verallgemeinerung über Trainingsverteilungen hinaus hervorhebt“.
Die Vorteile von EBTs sind aus zwei wesentlichen Gründen bedeutend. Erstens deuten sie darauf hin, dass EBTs bei den heutigen massiven Grundlagenmodellen die klassische Transformer-Architektur, die in LLMs verwendet wird, erheblich übertreffen könnten. Die Autoren stellen fest: „Bei modernen Grundlagenmodellen, die mit 1.000-mal mehr Daten und 1.000-mal größeren Modellen trainiert wurden, erwarten wir, dass die Vorabtrainingsleistung von EBTs deutlich besser ist als die des Transformer++-Rezepts.“
Zweitens weisen EBTs eine viel größere Dateneffizienz auf. Dies ist ein entscheidender Vorteil in einer Zeit, in der hochwertige Trainingsdaten zunehmend zu einem großen Engpass für die Skalierung von KI werden. „Da Daten zu einem der wichtigsten limitierenden Faktoren für die weitere Skalierung geworden sind, macht dies EBTs besonders attraktiv“, heißt es in dem Papier.
Trotz ihres unterschiedlichen Inferenzmechanismus ist die EBT-Architektur in hohem Maße mit dem Transformer kompatibel, sodass sie als direkter Ersatz für aktuelle LLMs dienen kann.
„EBTs sind sehr gut mit aktuellen Hardware-/Inferenz-Frameworks kompatibel“, sagte Gladstone, einschließlich spekulativer Dekodierung unter Verwendung von Feed-Forward-Modellen auf GPUs oder TPUs. Er fügte hinzu, dass er zuversichtlich sei, dass sie auf speziellen Beschleunigern wie LPUs und Optimierungsalgorithmen wie FlashAttention-3 laufen oder über gängige Inferenz-Frameworks wie vLLM eingesetzt werden können.
Für Entwickler und Unternehmen könnten die starken Schlussfolgerungs- und Generalisierungsfähigkeiten von EBTs eine leistungsstarke und zuverlässige Grundlage für die Entwicklung der nächsten Generation von KI-Anwendungen bilden. „Längeres Nachdenken kann bei fast allen Unternehmensanwendungen hilfreich sein, aber ich denke, am spannendsten werden diejenigen sein, die wichtigere Entscheidungen, Sicherheit oder Anwendungen mit begrenzten Daten erfordern“, sagte Gladstone.
Verwandter Artikel
 Base44 stellt proprietäres KI-Modell vor, um die Abwehrfähigkeit der Vibe-Coding-Plattform zu stärken
Base44, die vor einem Jahr für 80 Millionen US-Dollar von Wix übernommene Vibe-Coding-Plattform, die damals erst sechs Monate alt war und über ein Team von acht Mitarbeitern verfügte, hat damit begonnen, ihr eigenes KI-Modell einzusetzen, um Nutzern
Bayer nutzt Iambic AI, um die Arzneimittelforschung zu beschleunigen
Dr. Jürgen Eckhardt ist Leiter der Abteilung für Geschäftsentwicklung und Lizenzierung bei Bayer Pharmaceuticals.Bayer nutzt Iambic Therapeutics, um innovative KI-Modelle für die Wirkstoffforschung ei
Multiverse Computing bringt kostenloses komprimiertes generatives KI-Modell auf den Markt
Große Sprachmodelle stehen vor einer großen Herausforderung: ihrer immensen Größe. Das spanische Start-up Multiverse Computing geht dieses Problem an, indem es komprimierte Modelle entwickelt, die die
Empfehlungen zu verwandten Spezialthemen
Geschäft
 Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
 9 Tools
 xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai
Code
KI-Tools zur Überprüfung von Pull-Requests für GitHub-Teams, die sich mit Refactorings, Fehlern und Sicherheitslücken befassen
Die besten neuen KI-Tools zur Pull-Request-Prüfung für GitHub-Teams im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste mit den besten Bewertungen präsentiert leistungsstarke, bahnbrechende Lösungen, die Refactoring, Fehlerbehebung und die Erkennung von Sicherheitslücken in allen Team-Workflows optimieren. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie von Praxistests und detaillierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, mit dem Sie Ihre Produktivität deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai
Text-zu-Sprache
Die besten KI-Tools zur Text-zu-Sprache-Umwandlung für natürliche Sprachausgabe
Die besten und am besten bewerteten KI-Text-to-Speech-Tools für natürliche Sprachausgabe des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Optionen, die für jeden Anwendungsfall kristallklare Stimmen liefern – gestützt auf Tests in der Praxis und wöchentlich aktualisierte Rankings. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die Lösung zu finden, die Sie unbedingt ausprobieren sollten und die Ihre Produktivität sofort steigert. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

 Kommentare (0)
Forscher der University of Illinois Urbana-Champaign und der University of Virginia haben eine neue Modellarchitektur entwickelt, die den Weg für widerstandsfähigere KI-Systeme mit verbesserter Schlussfolgerungsfähigkeit ebnen könnte.
Diese Architektur mit dem Namen „Energy-Based Transformer“ (EBT) nutzt auf natürliche Weise die Skalierung der Inferenzzeit, um komplexe Herausforderungen zu bewältigen. Für Unternehmen bedeutet dies kosteneffiziente KI-Anwendungen, die sich an neue Szenarien anpassen können, ohne dass spezielle, fein abgestimmte Modelle erforderlich sind.
Die Herausforderung des System-2-Denkens
In der Psychologie wird die menschliche Kognition in der Regel in zwei Modi unterteilt: System 1, das schnell und instinktiv ist, und System 2, das langsamer, überlegter und analytischer ist. Die heutigen großen Sprachmodelle (LLMs) sind hervorragend für System-1-Aufgaben geeignet, aber der KI-Bereich konzentriert sich derzeit auf die Entwicklung des System-2-Denkens, um komplexere Denkaufgaben zu bewältigen.
Argumentationsmodelle verwenden verschiedene Skalierungsmethoden zur Inferenzzeit, um ihre Leistung bei schwierigen Fragen zu steigern. Eine gängige Technik ist das Reinforcement Learning (RL), das in Modellen wie DeepSeek-R1 und OpenAI's „o-series” verwendet wird, bei denen die KI Belohnungen für die Generierung von Argumentationstoken erhält, bis sie die richtige Lösung findet. Eine andere Strategie, die oft als „Best-of-n” bezeichnet wird, besteht darin, mehrere mögliche Antworten zu erstellen und mithilfe eines Verifizierungssystems die beste auszuwählen.
Diese Ansätze weisen jedoch erhebliche Einschränkungen auf. Sie beschränken sich in der Regel auf eine kleine Gruppe leicht überprüfbarer Probleme, wie Mathematik und Programmierung, und können die Leistung bei anderen Aufgaben, wie z. B. kreativem Schreiben, beeinträchtigen. Darüber hinaus deuten aktuelle Studien darauf hin, dass RL-basierte Methoden den Modellen möglicherweise keine neuen Denkfähigkeiten vermitteln, sondern sie lediglich dazu ermutigen, bereits bekannte erfolgreiche Denkmuster wiederzuverwenden. Dies schränkt ihre Fähigkeit ein, Probleme zu lösen, die eine echte Erforschung außerhalb ihres Trainingsumfangs erfordern.
Energiebasierte Modelle (EBM)
Diese neue Architektur verfolgt einen anderen Ansatz und baut auf einer Klasse von Modellen auf, die als energiebasierte Modelle (EBMs) bekannt sind. Das zentrale Konzept ist einfach: Anstatt direkt eine Antwort zu generieren, lernt das Modell eine „Energiefunktion”, die als Verifizierer dient. Diese Funktion nimmt eine Eingabe (z. B. eine Eingabeaufforderung) und eine mögliche Vorhersage entgegen und weist ihr dann einen Wert oder eine „Energie” zu. Ein niedriger Energiewert deutet auf eine hohe Kompatibilität hin, was bedeutet, dass die Vorhersage gut zur Eingabe passt, während ein hoher Energiewert auf eine schlechte Übereinstimmung hinweist.
In Anwendung auf das KI-Denkvermögen schlagen die Forscher in einem Artikel vor, dass Entwickler „das Denken als einen Optimierungsprozess in Bezug auf einen gelernten Verifizierer betrachten sollten, der die Kompatibilität (nicht normalisierte Wahrscheinlichkeit) zwischen einer Eingabe und einer Kandidatenvorhersage bewertet”. Der Prozess beginnt mit einer zufälligen Vorhersage, die dann schrittweise verfeinert wird, indem ihr Energiewert minimiert und mögliche Lösungen untersucht werden, bis sie zu einer hochkompatiblen Antwort konvergiert. Diese Methode basiert auf der Idee, dass die Überprüfung einer Lösung oft viel einfacher ist als die Generierung einer Lösung von Grund auf.
Dieses „verifiziererzentrierte“ Design bewältigt drei große Herausforderungen beim KI-Schlussfolgern. Erstens ermöglicht es eine dynamische Zuweisung von Rechenleistung, sodass Modelle länger über schwierige Probleme und weniger über einfachere Probleme „nachdenken“ können. Zweitens berücksichtigen EBMs auf natürliche Weise die Unsicherheit realer Probleme, für die es keine eindeutige Antwort gibt. Drittens fungieren sie als ihre eigenen Verifizierer, sodass keine externen Modelle erforderlich sind.
Im Gegensatz zu anderen Systemen, die separate Generatoren und Verifizierer verwenden, integrieren EBMs beide in ein einziges, einheitliches Modell. Ein großer Vorteil dieser Konfiguration ist die verbesserte Generalisierung. Da die Verifizierung einer Lösung anhand neuer, außerhalb der Verteilung liegender Daten (OOD) in der Regel einfacher ist als die Generierung einer richtigen Antwort, können EBMs unbekannte Situationen besser bewältigen.
Trotz ihres Potenzials hatten EBMs in der Vergangenheit mit Skalierbarkeitsproblemen zu kämpfen. Um dieses Problem zu lösen, führten die Forscher EBTs ein, bei denen es sich um spezielle Transformer-Modelle handelt, die für dieses Framework entwickelt wurden. EBTs werden so trainiert, dass sie zunächst die Kompatibilität zwischen einem Kontext und einer Vorhersage überprüfen und dann die Vorhersagen verfeinern, bis sie die Ausgabe mit der geringsten Energie (der höchsten Kompatibilität) identifizieren. Dieses Verfahren ahmt effektiv einen Denkprozess für jede Vorhersage nach. Das Team entwickelte zwei EBT-Varianten: ein nur aus einem Decoder bestehendes Modell, das von der GPT-Architektur inspiriert ist, und ein bidirektionales Modell, das BERT ähnelt.
Die Architektur von EBTs macht sie anpassungsfähig und kompatibel mit verschiedenen Skalierungsmethoden für die Inferenzzeit. „EBTs können längere CoTs generieren, sich selbst überprüfen, Best-of-N durchführen [oder] Sie können aus vielen EBTs auswählen“, erklärte Alexi Gladstone, Doktorand der Informatik an der University of Illinois Urbana-Champaign und Hauptautor der Studie, gegenüber VentureBeat. „Das Beste daran ist, dass all diese Fähigkeiten während des Vortrainings erlernt werden.“
EBTs in Aktion
Die Forscher testeten EBTs im Vergleich zu etablierten Architekturen: dem beliebten Transformer++-Rezept für die Textgenerierung (diskrete Modalitäten) und dem Diffusion Transformer (DiT) für Aufgaben wie Videovorhersage und Bildrauschunterdrückung (kontinuierliche Modalitäten). Sie bewerteten die Modelle anhand von zwei Hauptkriterien: „Lernskalierbarkeit“ oder wie effizient sie trainieren, und „Denkbarkeit“, die misst, wie sich die Leistung mit mehr Rechenleistung während der Inferenz verbessert.
Während des Vortrainings zeigten EBTs eine überlegene Effizienz und erreichten eine um bis zu 35 % höhere Skalierungsrate als Transformer++ über Daten, Batchgröße, Parameter und Rechenleistung hinweg. Das bedeutet, dass EBTs schneller und kostengünstiger trainiert werden können.
Bei der Inferenz übertrafen EBTs auch bestehende Modelle bei Denkaufgaben. Durch „längeres Denken“ (unter Verwendung von mehr Optimierungsschritten) und „Selbstverifizierung“ (Generierung mehrerer Kandidaten und Auswahl des Kandidaten mit der geringsten Energie) verbesserten EBTs die Sprachmodellierungsleistung um 29 % gegenüber Transformer++. „Dies steht im Einklang mit unserer Behauptung, dass herkömmliche Feed-Forward-Transformer nicht in der Lage sind, zusätzliche Rechenleistung für jede Vorhersage dynamisch zuzuweisen, und daher die Leistung für jedes Token nicht durch längeres Nachdenken verbessern können”, erklären die Forscher.
Bei der Bildrauschunterdrückung lieferten EBTs bessere Ergebnisse als DiTs, während sie 99 % weniger Vorwärtsdurchläufe benötigten.
Wichtig ist, dass die Studie ergab, dass EBTs effektiver generalisieren als andere Architekturen. Selbst bei gleicher oder schwächerer Vorab-Trainingsleistung übertrafen EBTs bestehende Modelle bei nachgelagerten Aufgaben. Die Leistungssteigerungen durch System-2-Denken waren bei Daten, die weiter außerhalb der Verteilung lagen (im Gegensatz zu den Trainingsdaten), am ausgeprägtesten, was darauf hindeutet, dass EBTs besonders robust sind, wenn sie mit neuen und schwierigen Herausforderungen konfrontiert werden.
Die Forscher stellen fest, dass „die Vorteile des Denkens von EBTs nicht für alle Daten gleich sind, sondern mit dem Ausmaß der Verteilungsverschiebungen positiv skalieren, was das Denken als einen kritischen Mechanismus für eine robuste Verallgemeinerung über Trainingsverteilungen hinaus hervorhebt“.
Die Vorteile von EBTs sind aus zwei wesentlichen Gründen bedeutend. Erstens deuten sie darauf hin, dass EBTs bei den heutigen massiven Grundlagenmodellen die klassische Transformer-Architektur, die in LLMs verwendet wird, erheblich übertreffen könnten. Die Autoren stellen fest: „Bei modernen Grundlagenmodellen, die mit 1.000-mal mehr Daten und 1.000-mal größeren Modellen trainiert wurden, erwarten wir, dass die Vorabtrainingsleistung von EBTs deutlich besser ist als die des Transformer++-Rezepts.“
Zweitens weisen EBTs eine viel größere Dateneffizienz auf. Dies ist ein entscheidender Vorteil in einer Zeit, in der hochwertige Trainingsdaten zunehmend zu einem großen Engpass für die Skalierung von KI werden. „Da Daten zu einem der wichtigsten limitierenden Faktoren für die weitere Skalierung geworden sind, macht dies EBTs besonders attraktiv“, heißt es in dem Papier.
Trotz ihres unterschiedlichen Inferenzmechanismus ist die EBT-Architektur in hohem Maße mit dem Transformer kompatibel, sodass sie als direkter Ersatz für aktuelle LLMs dienen kann.
„EBTs sind sehr gut mit aktuellen Hardware-/Inferenz-Frameworks kompatibel“, sagte Gladstone, einschließlich spekulativer Dekodierung unter Verwendung von Feed-Forward-Modellen auf GPUs oder TPUs. Er fügte hinzu, dass er zuversichtlich sei, dass sie auf speziellen Beschleunigern wie LPUs und Optimierungsalgorithmen wie FlashAttention-3 laufen oder über gängige Inferenz-Frameworks wie vLLM eingesetzt werden können.
Für Entwickler und Unternehmen könnten die starken Schlussfolgerungs- und Generalisierungsfähigkeiten von EBTs eine leistungsstarke und zuverlässige Grundlage für die Entwicklung der nächsten Generation von KI-Anwendungen bilden. „Längeres Nachdenken kann bei fast allen Unternehmensanwendungen hilfreich sein, aber ich denke, am spannendsten werden diejenigen sein, die wichtigere Entscheidungen, Sicherheit oder Anwendungen mit begrenzten Daten erfordern“, sagte Gladstone.








 Base44 stellt proprietäres KI-Modell vor, um die Abwehrfähigkeit der Vibe-Coding-Plattform zu stärken
Base44, die vor einem Jahr für 80 Millionen US-Dollar von Wix übernommene Vibe-Coding-Plattform, die damals erst sechs Monate alt war und über ein Team von acht Mitarbeitern verfügte, hat damit begonnen, ihr eigenes KI-Modell einzusetzen, um Nutzern
 Bayer nutzt Iambic AI, um die Arzneimittelforschung zu beschleunigen
Dr. Jürgen Eckhardt ist Leiter der Abteilung für Geschäftsentwicklung und Lizenzierung bei Bayer Pharmaceuticals.Bayer nutzt Iambic Therapeutics, um innovative KI-Modelle für die Wirkstoffforschung ei
 Multiverse Computing bringt kostenloses komprimiertes generatives KI-Modell auf den Markt
Große Sprachmodelle stehen vor einer großen Herausforderung: ihrer immensen Größe. Das spanische Start-up Multiverse Computing geht dieses Problem an, indem es komprimierte Modelle entwickelt, die die

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

Die besten neuen KI-Tools zur Pull-Request-Prüfung für GitHub-Teams im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste mit den besten Bewertungen präsentiert leistungsstarke, bahnbrechende Lösungen, die Refactoring, Fehlerbehebung und die Erkennung von Sicherheitslücken in allen Team-Workflows optimieren. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie von Praxistests und detaillierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, mit dem Sie Ihre Produktivität deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Text-to-Speech-Tools für natürliche Sprachausgabe des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Optionen, die für jeden Anwendungsfall kristallklare Stimmen liefern – gestützt auf Tests in der Praxis und wöchentlich aktualisierte Rankings. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die Lösung zu finden, die Sie unbedingt ausprobieren sollten und die Ihre Produktivität sofort steigert. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai












