


 首页
全球首个事件级具身智能世界模型,结束了机器人的逐帧学习
5月29日,Variable Robot团队发布了WALL-WM,这是全球首个基于“事件级预测”构建的具身智能世界模型。 该模型突破了传统具身大型模型逐帧学习动作的局限,将世界模型的预测单元转换为语义事件。这标志着机器人在理解和执行任务方面迈入了一个新阶段。
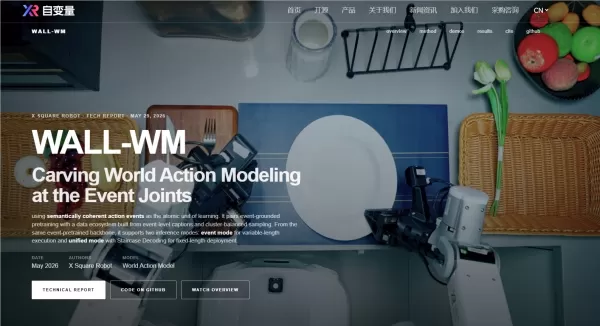
在当前的具身智能领域,主流的视觉-语言-动作(VLA)模型通常基于当前图像和指令来预测固定长度的动作块。这种逐帧训练方法往往导致机器人专注于细微的肢体动作,却忽视了动作的最终目标。 当面对更换杯子或桌子等场景时,机器人常因缺乏泛化能力而失败。为解决这一行业痛点,Variable团队在其学术论文中指出,文本、视觉和动作信息在现实世界中天然存在于不同的时间尺度和流形几何结构中。 将它们强行置于单一共享空间中,极易破坏预训练的几何先验。
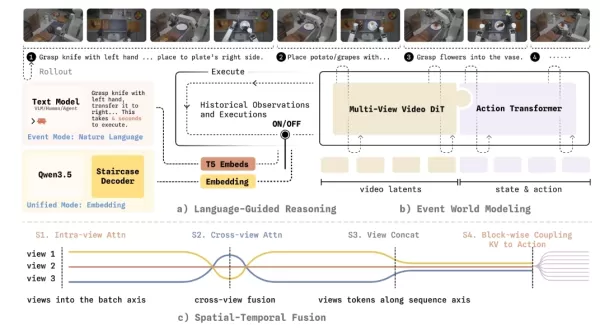
为应对这一挑战,WALL-WM 世界模型引入了一种创新的事件中心化训练与执行机制。它将复杂任务分解为语义清晰的事件节点,例如伸手、抓取和移动。 在运行时,该模型不再机械地计算下一帧图像。相反,它首先模拟世界因下一个事件将如何变化,然后将这种视觉变化精确转化为机械臂的运动轨迹。
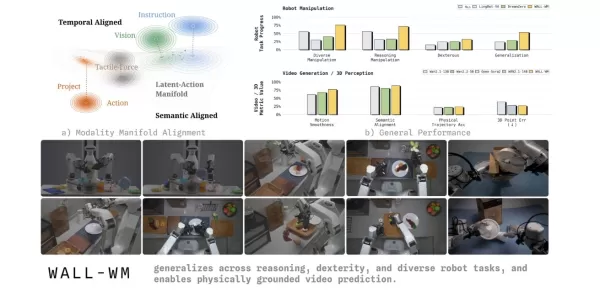
为确保这一新架构能在物理世界中可靠部署,Variable Robot团队进行了一系列深度工程改造。该系统支持在同一基础权重上灵活切换“事件模式”(具有可变长度的动作输出)与“统一模式”(具有实时闭环控制)。 该系统还实现了视频模型与动作模型之间的单向耦合,防止来自互联网视频的宝贵动态先验信息过早受到动作数据的偏置。 针对多摄像头间的几何感知,该模型引入了截锥体遮罩和管状遮罩,迫使 AI 建立跨视图的真实三维几何对应关系。为解决决策延迟问题,它采用了一种新的“分步思维链解码”技术,在保持逻辑可解释性的同时,显著降低了解码延迟。
相关文章
 字节跳动加大核心AI激励,豆包增长14.6%
字节跳动近日召开豆包股权说明会,公布面向豆包部门员工的最新激励政策。豆包股票的行权价已从2026年6月的14.85美元上调至17.02美元,涨幅约为14.6%。此次调整不仅提升了豆包股票的估值,还大幅扩大了其覆盖范围。根据员工岗位的不同,部分员工可能获得相当于其总薪酬约5%的豆包股票。根据新的兑换机制,字节跳动允许员工在整体薪酬包中,将部分现金工资兑换为豆包股权。兑换比例因职级而异,设有20%和30%等不同档位。例如,L2和L3级员工可选择20%的全覆盖兑换比例,而L3和L4级员工的该比例可
MiniMax 推出 10 倍团队计划,以激励全球 AI 专家
MiniMax(稀宇科技)通用人工智能实验室正式推出“10x Team”,这是一项全球人才协作计划。该计划旨在招募跨行业的顶尖专家,探索大模型在垂直领域的深度应用。通过将深厚的行业知识与前沿人工智能技术相结合,MiniMax 致力于将大模型的生产力从通用场景拓展至专业场景,最终推动行业效率实现“十倍增长”。验证行业认知价值,开放多模态核心资源过去与行业专家的合作表明,深厚的专业洞察对于构建高质量、实用的行业专属大模型至关重要。在此基础上,“10x Team”计划将向合作伙伴开放包括多模态模型
韩国启动国家人工智能计算中心建设,投资2.5万亿韩元,目标2028年完成
韩国媒体EtNews报道,韩国AI计算中心(KOACC)的奠基仪式于8月3日在全罗南道顺天市的Solar City数据中心园区举行。该项目总投资额为2.5万亿韩元(约合118.38亿元人民币),计划于2028年投入运营,成为迄今为止韩国在AI基础设施领域规模最大的国家投资之一。该项目的股权分布凸显了深化政企合作的战略意图。三星SDS作为最大股东持有30%的股份,而包括科学技术信息通信部、金融监督院和国家成长基金在内的公共实体合计持有29%的股份。NAVER Cloud紧随其后,持股26.1%,
相关专题推荐
教育与学习
 用于作业和考试备考的AI学习工具
2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
 10 个工具
 xix.ai
音乐创作
面向词曲创作者、旋律片段、主旋律及多语言草稿创作的AI人声演示工具
2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai
商业
适合中小企业的最佳AI竞品分析工具
2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai
图像编辑
用于电商服装、皮肤清洁和色彩一致性的 Photoshop AI 修图工具
2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai
提示词
适用于 ChatGPT 工作流的最佳 AI 提示词库
2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
教育与学习
面向教师、辅导老师和基于群体的学习项目的 AI 测验构建平台
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai

 评论 (1)
0/500
![JasonHarris]()
Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics
5月29日,Variable Robot团队发布了WALL-WM,这是全球首个基于“事件级预测”构建的具身智能世界模型。 该模型突破了传统具身大型模型逐帧学习动作的局限,将世界模型的预测单元转换为语义事件。这标志着机器人在理解和执行任务方面迈入了一个新阶段。
在当前的具身智能领域,主流的视觉-语言-动作(VLA)模型通常基于当前图像和指令来预测固定长度的动作块。这种逐帧训练方法往往导致机器人专注于细微的肢体动作,却忽视了动作的最终目标。 当面对更换杯子或桌子等场景时,机器人常因缺乏泛化能力而失败。为解决这一行业痛点,Variable团队在其学术论文中指出,文本、视觉和动作信息在现实世界中天然存在于不同的时间尺度和流形几何结构中。 将它们强行置于单一共享空间中,极易破坏预训练的几何先验。
为应对这一挑战,WALL-WM 世界模型引入了一种创新的事件中心化训练与执行机制。它将复杂任务分解为语义清晰的事件节点,例如伸手、抓取和移动。 在运行时,该模型不再机械地计算下一帧图像。相反,它首先模拟世界因下一个事件将如何变化,然后将这种视觉变化精确转化为机械臂的运动轨迹。
为确保这一新架构能在物理世界中可靠部署,Variable Robot团队进行了一系列深度工程改造。该系统支持在同一基础权重上灵活切换“事件模式”(具有可变长度的动作输出)与“统一模式”(具有实时闭环控制)。 该系统还实现了视频模型与动作模型之间的单向耦合,防止来自互联网视频的宝贵动态先验信息过早受到动作数据的偏置。 针对多摄像头间的几何感知,该模型引入了截锥体遮罩和管状遮罩,迫使 AI 建立跨视图的真实三维几何对应关系。为解决决策延迟问题,它采用了一种新的“分步思维链解码”技术,在保持逻辑可解释性的同时,显著降低了解码延迟。








 字节跳动加大核心AI激励,豆包增长14.6%
字节跳动近日召开豆包股权说明会,公布面向豆包部门员工的最新激励政策。豆包股票的行权价已从2026年6月的14.85美元上调至17.02美元,涨幅约为14.6%。此次调整不仅提升了豆包股票的估值,还大幅扩大了其覆盖范围。根据员工岗位的不同,部分员工可能获得相当于其总薪酬约5%的豆包股票。根据新的兑换机制,字节跳动允许员工在整体薪酬包中,将部分现金工资兑换为豆包股权。兑换比例因职级而异,设有20%和30%等不同档位。例如,L2和L3级员工可选择20%的全覆盖兑换比例,而L3和L4级员工的该比例可
 MiniMax 推出 10 倍团队计划,以激励全球 AI 专家
MiniMax(稀宇科技)通用人工智能实验室正式推出“10x Team”,这是一项全球人才协作计划。该计划旨在招募跨行业的顶尖专家,探索大模型在垂直领域的深度应用。通过将深厚的行业知识与前沿人工智能技术相结合,MiniMax 致力于将大模型的生产力从通用场景拓展至专业场景,最终推动行业效率实现“十倍增长”。验证行业认知价值,开放多模态核心资源过去与行业专家的合作表明,深厚的专业洞察对于构建高质量、实用的行业专属大模型至关重要。在此基础上,“10x Team”计划将向合作伙伴开放包括多模态模型
 韩国启动国家人工智能计算中心建设,投资2.5万亿韩元,目标2028年完成
韩国媒体EtNews报道,韩国AI计算中心(KOACC)的奠基仪式于8月3日在全罗南道顺天市的Solar City数据中心园区举行。该项目总投资额为2.5万亿韩元(约合118.38亿元人民币),计划于2028年投入运营,成为迄今为止韩国在AI基础设施领域规模最大的国家投资之一。该项目的股权分布凸显了深化政企合作的战略意图。三星SDS作为最大股东持有30%的股份,而包括科学技术信息通信部、金融监督院和国家成长基金在内的公共实体合计持有29%的股份。NAVER Cloud紧随其后,持股26.1%,

2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai

2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai

2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai

2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai

Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics












